2026-10-29 08:00:00
假如把我的 AI Coding 经验沉淀成一些最佳实践规则,可以给到大伙复用,会是怎么样的,于是乎,昨天一下午我就在琢磨这个事情,手写反复调整后给到大伙,可以让你和你的 Agent 一起去学习。
2026-10-26 08:00:00

距离写完上一篇 Mole 出 Mac 版后,用户教会了我做产品 已经过去两个多月。这段时间里,Mole 从 1.13 一路发到了 1.18,加上了 AI 工具清理和系统数据清理,Windows 版也在 10 月 14 日晚上发了出来,GitHub 上的 Star 一转眼也到了 72.9K。
回头看这段时间,花时间最多的反而不是写新功能,而是做了一些在工程师看来挺划不来的蠢事情:把国内外 850 款 Mac 软件一个个装上、用一下、再卸掉;把 400 多封没激活的 license 邮件一封封补发出去;几十个图标前前后后改了三轮;还有把界面文案一句句改到第一次用的人也能看懂。
程序员天然喜欢做可扩展的事情,什么事都想着尽可能工具化、自动化、AI 化来解决,让自己偷懒。这两个月下来我的感受有点不一样,代码越来越便宜,谁都能很快做出一个能跑的东西,能拉开差距的,越来越是那些只有亲手做过才知道的细节。好在有了 AI,这些原来要花大量人力的蠢事,现在一个人也做得完了。
我平时有点强迫症,电脑里的软件一直控制在 30 个左右。为了让 Mole 的卸载更彻底,清理残留的能力更强,最初那一轮我整理了国内外 300 多款 Mac 软件,下载下来 100 多个 G,分成 30 组,每组 10 个,让 Agent 借助 computer use 的能力去官网下载,依次安装到我的电脑上,检查目录、更新 bundle、自启动,再卸载,找剩下的残留,把缺的规则补进 Mole。
当时想着最多搞 100 个主流软件来测试,结果测完想着要不再搞 100 个,到了 200 个的时候,又想着再搞 100 个,后来又补充了 App Store 版本和扩展插件,一路到了 549、709、824,现在是 850 款。我的电脑一下子变成了下面这个非常凌乱的桌面,哈哈给大伙瞅瞅。

这个过程看着非常无聊,很多软件一装上就疯狂弹窗要权限,诱导你去买会员,有些还必须输入管理员密码,Agent 大部分能自己处理,少部分我在旁边帮一手。让我非常惊喜的是,AI 还顺手自己写了自动化安装、卸载、检查残留的脚本,让自己干得更轻松,挺聪明的,哈哈我就只能给它打打下手。
这也改变了我的一些固有观点。本来以为软件工程应该是规范的、有秩序的,跑了 100 个软件后,后面应该没什么可以补充的规则了,因为按理主流软件的开发规范完全可以枚举出来。结果越往后走越发现,完全不是这样,很多残留,怎么写通用规则都找不全,甚至有些 bundle id 干脆就不是反向域名,看着很规范的约定,可能只是当年某个程序员随手写的,没有任何理论可以解释出来,只能装一个查一个。
那一轮 300 多款软件测下来,Mole 补了 13 类可以复用的通用规则、90 多条精确清理路径,也顺手改掉了 30 多个原本以为要清、其实不该动的地方,还补了 100 多条单元测试。其中那些不该动的地方,对我来说和新找到的残留一样有价值,缓存可以重新生成,用户自己的文件却不能,几个软件共用的数据更不能因为卸了其中一个就清掉。
每款软件具体的残留路径和手动卸载步骤,我也整理成了中英文指南放在官网,现在 850 款都能免费看,就算不用工具,照着步骤也能手动删干净,大伙可以看看自己电脑上的软件在不在这个名单里。

做 AI 清理之前,很多小伙伴就提过想清 AI 工具的数据。之前在我看来,AI Coding 的会话记录是非常重要的资产,所以这一块只清真正的缓存和旧版本。
不过随着平时天天用 AI,我自己本地也攒了非常多没那么大用的旧产物、旧会话和 worktree,也有用户的 opencode.db 一个单文件就涨到了 62 GB,急着问该怎么清。于是我把 30 多款 AI 工具逐个测了一遍,其中桌面端测了 13 个,命令行也是 13 个,另外还查了 OpenClaw、Hermes 和 Pi 卸载以后留下的目录。
和之前装完就卸不一样,这次能用上的工具我都登录了账号,在真实项目里真金白银地用了一次,问问题、跑 Agent、建代码索引、设定时任务,因为很多数据只有实际用过才会产生,只装不开是看不到的。
每装一个,AI 就对照装之前的状态,量它往家目录、~/Library、/usr/local/bin 和 shell 配置里写了什么,记进一份台账,然后看它占了多少进程和内存,最后用 Mole 卸载,卸完再按名字把整个家目录扫一遍,找没列出来的东西,缺什么当晚补进代码,再复测一次。
这一轮看到的东西比普通软件更让人意外。最直观的是内存,13 个桌面端同时开着一共占了大约 23 GB,有一款国产大厂的工具一启动就是 41 个进程,占了 4.49 GB 内存。这些工具大多是 VS Code 或 Electron 系,一个窗口背后挂着一长串 helper,所以后来做状态监控时,我让每个 App 只占一行,把同属于它的所有子进程合在一起算,不然光看活动监视器,根本搞不清到底是谁在吃内存。
还有就是它们对系统做的小改动。有些工具第一次打开时,会往 /usr/local/bin 放一个 root 所有的命令链接,App 删掉以后这个链接就变成了死链接;有一款往 ~/.local/bin 放了一个 python3.12,之后在终端里输入 python3.12,实际运行的都是它自带的版本;最离谱的是某个国产命令行工具,我运行了一次,它先告诉我自己已经停止维护,然后完全没问我,就直接下载安装了它的新版本,改了 .zshrc,还把原来的命令改名成了 legacy。
体积上也很夸张。有个桌面端第一次用 Work 模式就下载了约 1 GB 的工具包,解压后是 3.1 GB,里面塞了一整套自带的 LibreOffice、FFmpeg 和 OpenJDK;我自己天天用的 ~/.codex 已经 24 GB,其中会话占了 17 GB;Claude 桌面版 14 GB 里有 12 GB 是 Cowork 虚拟机。还有很多 skill 安装器会往每一个 Agent 的目录都写一份 skills/,不管你装没装这个 Agent,所以我明明没用过 Qwen Code、iFlow 和 Droid,家目录下它们的配置文件夹却都在,Mole 的第一版还把它们当成了 2.4 MB 的工具残留,差点把我装的 skills 当垃圾一起清掉。
进程也是我没想到的。卸载完第二天早上再查,有两个命令行工具的目录删了又长了回来,原因是前一晚在终端里开着的会话进程还活着,程序文件已经在废纸篓里了,后台进程照样在往目录里写日志,命令行工具没有窗口,关掉终端标签并不一定会结束它。
测试过程中也看到了不少乱象,比如有的软件在你下载安装包时,会悄悄往剪贴板写一点东西用来跟踪安装渠道;有的装上后疯狂弹窗让你去做活动领 Token,牛皮癣满天飞,有一种捏着鼻子用的感觉。对比下来,Claude、Codex、Cursor 都比较克制,国内让我意外觉得不错的是 Qoder,界面干净,审美在线,没有乱来。
这些也让我改了一个之前的判断,会话确实珍贵,但用完的旧会话和 worktree 也确实占空间。现在的 AI 清理里,会话会按你选的保留时间列出来,15、30、90、120 天可选,每一条都带标题和时间,删之前先留一份恢复副本;worktree 只有在 git 能证明里面没有未提交的改动时才会出现;opencode.db 则是做数据库压缩,只把空出来的页还给磁盘,不替用户删对话。

前阵子翻 Reddit,看到很多人抱怨 Mac 设置里的系统数据动辄一两百 GB,问到底是些什么、能不能删。但这个数字其实只是一个分类结果,Apple 的官方说明也是把其他分类没归进去的文件都算在里面,它并不是一份可以照着删的清单,所以 Mole 的系统数据分组只写自己量出来能处理多少,不去硬凑系统设置里的那个总数。
难的地方在于,这一块没办法在我自己的电脑上装一个查一个,每台 Mac 的系统数据都不一样,很多情况只能等用户报上来,再一层层去查。
比如可清除空间,系统报出来的数字里混着 iCloud 可以收回的文件、系统自己会释放的缓存,一台一个本地快照都没有的 Mac,这个数字也有 142 GB 左右。早期的 Mole 曾用它去估算快照能清多少,结果估出来能清 50.7 GB,清完可用空间实际只多了几 GB。现在快照这一行不再写预估大小,清完以后直接去量磁盘可用空间实际变了多少,而且 APFS 删完以后空间不是一下子回来的,要等它不再增长了才算数。中间还抓出一个 bug,读取可用空间时一直拿到的是缓存住的旧值,导致清完永远显示释放了 0。
还有一位用户的系统数据里,堆了 179.53 GB 的壁纸渲染缓存,整整 6644 个文件,每张壁纸、每种屏幕尺寸各存一份没压缩的 BMP,系统自己从来不删。第一版能把它扫出来,却一个字节都删不掉,因为壁纸进程一直在后台运行,检查文件占用的命令对单个文件又会报错,被当成了不确定。最后改成只列出一周以前的、而且不是正在显示的那几张,交给用户确认,这个在 1.17 里已经可以用了。
至于像我自己电脑上的 119 GB iPhone 备份和 79.5 GB Parallels 虚拟机,这种东西很大,但不应该交给一个全选删除按钮,Mole 只显示大小和管理入口,不能勾选,也不算进可清理空间,让人回到对应的地方确认清楚再说。

国庆的时候,我花了一天做了件拖了很久的事,把 Mole 从 5 月开售到 9 月底买了却还没激活的订单翻了一遍,大约 400 多单,用 AI 写了一个简单的本地脚本把用户邮箱和 Key 列出来,然后按购买月份、国家和语言,一封一封重新发了出去。不是促销邮件,也不是催促激活,更多就像发个微信一样,告诉用户不要忘记了,不急着用也可以。
有意思的是,陆陆续续收到了非常多各个国家用户的回信,比我预想的要有意义很多。有用户说买来就是想支持我继续开发,自己更喜欢用 Terminal 版本,还有人完全忘记了 GUI,一直在使用 CLI。也有用户非常用心,买了两个,一个给自己,一个给家人,打算当圣诞节礼物,所以一直没激活,Key 已经存进了密码管理器,让我感觉这个世界真美好。
也有用户一开始在公司电脑上用,后来公司禁止使用不在范围内的软件,一直在等自己的新 Mac;还有用户是在我打折的时候买的,现在还没有 MacBook,等自己新机到手就立马去激活。也有人回了一个「Prefect!」,还有人在国庆假期说,假期也该好好摸了(mole),这些回信看着都很开心。
不过其中也有不少用户其实是邮箱填错了,可能是打太快了,把邮箱写成了 gmai.com、gmail.con、cloud.com 这一类,也没来找我;也有用户是第一封邮件没有收到,为了早点用上又买了一遍。
在后台数据里看,这些人全都是同一个状态,未激活。如果直接给所有人发同一封催活邮件,反而可能把问题想错了,买来支持、留着送人、等新电脑的人,他们没有遇到需要催促的问题,邮箱填错和信没收到的人,才是真的没拿到激活码。这几种情况,光看后台数字是分不出来的,只有一封封看回信才知道。
所以顺着这件事,我把购买后的流程补了一截,付款完成后自动跳回官网页面直接展示 Key,即使用户邮箱填错了或者邮件被拦截,也能在购买后第一时间看到。顺带还多做了一个有意思的小细节,用户在网页上点击激活,就能一键把安装好的客户端唤起来,自动在激活页填好这个 Key,不用自己复制粘贴,点下确认按钮就好了。
这个小魔法拆开看,就是网页交给系统一个 Mole 能识别的链接,系统再交给客户端,客户端只把 Key 放进输入框,不会替用户自动确认激活,最后还是走原来的许可证校验,把最后一步留给用户。写过客户端和前端的工程师,可能会觉得这个技术实现其实很简单,但对大部分用户来说,会感觉卧槽、神奇、魔法,这个产品帮我多做了些事情。或许这也是我做产品一直追求的,多做一些有趣的小细节,让用户感受到这种魔法,有一点黑客与画家的感觉。
最近我又在做一件差不多的事,给 5 月 Mole 刚上线就买了的那批老用户写信,简体、繁体、英文、西班牙语、法语各写了一份,信里主要是谢谢他们这么早就支持,说说这几个月 Mac 版加了系统数据和 AI 清理,在 Mole 里检查更新就能用上,最后留一句,用着有任何不顺手的地方,或者想要什么新功能,直接回信告诉我。
就这么一封短信,前前后后也改了好几遍,前几版读着总有一点推销的感觉,像是一封营销邮件,后来一句句改成平时和朋友说话的口气,简单、清晰、不啰嗦,读着像是我自己会发出去的信,才算满意。
Paul Graham 在 Do Things that Don’t Scale 里写过,Wufoo 早期给新用户手写感谢信,Stripe 会当场拿过用户的电脑直接帮忙装好。放到现在代码没什么壁垒了,这些看似不可扩展的笨功夫反而更值钱。
这两个月花时间最多的细节,是把 Mole 里的图标整套换掉。之前用的是系统图标,简单场景完全够用,但细看会缺少一点灵性。调研了一圈,Remix Icon 写 Web 时用得很多,放到 App 上感觉不是很好看,最后选了 Phosphor,大概 70% 可以直接用,剩下 30% 是我用 Opus 5.5 写 SVG 自绘的,这样整体线宽和风格才能一致。

我一直想着,做出来的产品应该是有灵性、有生命的,用的人能感觉到这里面花了心思,图标这种小细节就是个很好的入手点。比如大伙看「保持常亮」我用的是一杯咖啡,有一种 Caffeine 的比喻,让电脑好像喝了咖啡一样睡不着;「关于」一般会用一个带圈的 i,但我想着应该是 hello,所以用了挥手的标志;「诊断」正常会用排查的标志,这里用了一个听诊器,更像是给电脑做一次体检。
结果发出去之后,用户的反馈让我意识到有些图标其实可以再来优化一下。有几个图标我自己觉得挺好,用户却觉得不够直观,「检查更新」用了一个下载的图标,被大家读成了下载,GPU 的小方块看不出是显卡,压缩包的图标看不懂,两根叠在一起的内存条也不太像内存,还有人说清洁屏幕的海绵和关于的挥手看不懂。仔细想想确实是这样,图标首先得让人看懂,好不好看在其次。
于是这几个都按大家的建议又改了一轮,检查更新换成了顺时针箭头,GPU 画成了双风扇显卡,压缩包换成了归档盒,音频从音符换成了耳机,清洁屏幕回到了最初刷子的意思,内存回到了芯片,关于最后还是换回了最正统的 ⓘ,只是按整列的线宽重新画了一遍,其中不少前前后后改了三次,终于舒服了。

文案上也是同样的折腾。之前写代码把 Claude 和 Codex 的额度都用得差不多了,翻出吃灰了一阵子的 Gemini,切到 3.8 Flash High,试着让它帮我看看文案,结果让我很惊喜,它写代码可能不算最顶尖,但写大白话写得很好。我把 Mole 的设置项、清理项说明和官网内容几乎全过了一遍,要求很简单,说人话,简单、清晰、易懂,让第一次用的人也能秒懂,不要文绉绉,也不要有 AI 味。
我让它输出改前、改后的对比和原因,再一条条看,那感觉真像请了一位很有耐心的语文老师坐在旁边,帮我把很多程序员自嗨的表达改成了正常人看得懂的话。比如缓存删除那一项,原来的说法容易被误解成整个 App 的删除方式,现在写清楚它只管清理页的普通缓存,卸载不受影响。
测几百个软件的时候,还有一个意外的收获。Mole 刚出来的前几个版本就开始支持视障用户,加了很多无障碍属性,没想到这次帮了大忙,AI 借助这些属性,可以非常准确地找到每个按钮和元素的位置,测试顺利了很多。
无障碍属性提供的不只是一个坐标,还有这个控件叫什么、是什么类型、现在是什么状态,界面稍微变动,脚本依然能找到同一个按钮,如果只靠截图和坐标,弹窗一变、窗口一动,就很容易点偏。苹果从一开始就想着每个人都应该能平等地用电脑,很多地方都能被 VoiceOver 读到,这点真好。独立开发的小伙伴做 App 和网页时,可以让 AI Coding 顺手把无障碍补上,视障用户能用上了,日后做自动化测试时往往也会反过来帮到自己。
做 Windows 版的时候也是这样一个一个测出来的。其实 Windows 这边不是从零开始,Mole 的 Windows CLI 年初就开始陆续维护,有社区同学一起贡献,现在 CLI 已经很成熟了,有了这个底子才有了这次的桌面版。桌面版用的是 Windows 原生的 C# 和 WinUI 3,Mac 版的 Swift 代码几乎用不上,来来回回写了差不多一个月,攒下 7.8 万行代码和 4000 多个测试用例。测过的 486 款 Windows 软件大多是在 Mac 上的 Parallels 虚拟机里跑的,我买了一台 ThinkPad X1,24 小时开着,Mac 通过 UU 远程和 ssh 连过去,让 AI 直接操作这台真实的电脑做安装、卸载和清理验收。

现在我的 Mac 是整个研发的主力端,上面跑着 Parallels 虚拟机,连着旁边的 ThinkPad X1,数据线还插着一台 Android 小平板,打开 adb 调试以后,AI 可以帮我操作一些没有 API 的服务,再加上 Xcode 里的 iPhone 模拟器。所有的 AI 上下文都在这一台 Mac 上,平时终端里开着 7 到 10 个 Tab 的 Agent 在跑任务,社交平台上收集到的建议和反馈会进到 Notion,AI 搞定后自动标记完成,这也是为什么我一个人可以把 GitHub 上那么多 issue 逐个清掉,哈哈。

用 Mac 开发 Windows 软件的具体做法,比如代码怎么分层才能在 Mac 上跑测试、虚拟机怎么用脚本驱动,我单独写在了 Mole 博客的这一篇里,选型上的取舍也在你不知道的客户端开发里聊过,有同样需求的小伙伴可以看看。
AI 让代码写得更快,也让做出一个看得过去的界面容易了很多,人看着好像什么都不用做了,动动嘴就行,但我这段时间的体会是,人在这里的作用反而更大了,AI 帮我们省下来的时间,刚好可以用来做这些看似无用功的打磨。
把 850 款软件一个个装上卸掉,把收到的回信一封封看完,把几十个图标改上三轮,这些事情 AI 不会替你决定去做,但做完之后,能让 1% 的用户在用你产品的时候,时不时体会到一种秒懂、卧槽、变魔术的感觉,那就非常值得了。
把踩过的坑写成清理规则、补进 100 多条单元测试、整理成公开指南,下次就不用再从头来过,这些笨功夫才算没有白费。
测过的软件越多,越想让 Mole 保持现在的克制,不上传用户的本地文件和会话内容,不加任何使用统计,能用默认值解决的就不加开关。
接下来 Mac 这边我想先测到 1000 款,Windows 那边也会接着补,大伙电脑里如果装了什么特别难卸载、或者残留很深的软件,欢迎到 GitHub 讨论帖 告诉我,我放进下一轮的测试清单里。踏踏实实做出一个自己用着舒服、别人也觉得靠谱的工具,就很开心了。
CLI 照旧在 GitHub 开源免费,Mac 和 Windows 桌面版在 mole.fit,欢迎小伙伴们随时来吐槽。
2026-10-22 08:00:00

发现不少小伙伴很好奇我是怎么用 Mac 来开发 Windows 软件的,以及 Windows 软件现在一般用什么技术栈来实现,刚好我这段时间也在做类似的事情,来和大伙随便聊聊关于多端技术选择的思考。
做过前端客户端的小伙伴应该都知道,这些年端的开发一般是这三条路。
第一种最简单方便的是,直接写 Web 代码,塞到浏览器就能跑,包括早年的 PhoneGap、Cordova 就是把网页塞进一个原生壳里,然后提供一些 bridge 的能力让 JS 可以调用到一些原生的能力,比如唤起手机摄像头这类的 Web 不好做的事情。
第二种是跨端开发,也就是早年大家常听到的一码多端。当时移动端有 React Native、Weex 这一类技术,主要是为了解决 Web 性能差的问题,一份代码同时打包 iOS 和 Android。国内大厂当时重度用跨端还有一个非常大的原因,就是动态化和热更新,讲得土一点就是可以绕过商店审核直接下发新页面,这也是国内跨端在移动互联网高速发展时特别流行的重要原因。
桌面端大家熟悉的就是 Electron,大家熟知的现在不少 AI 桌面端、VS Code、Slack 是用这个做的,代价是相当于每个应用都自带一份 Chromium 和 Node.js,安装包一百多 MB,内存也占得多。但好处是在 Chromium 渲染引擎的统一下能够很好地保持多端的展示一致性,加上里面写的代码非常好写,后续不少桌面的速成就会用这个技术。
跨端后面也慢慢延伸出更多有趣的解决方案,类似 Flutter 自己实现一套渲染引擎,早期靠 Skia,现在换成了自研的 Impeller 渲染引擎来保障多端一致和性能效率的均衡,包括桌面端上老牌的 Qt,和 Flutter 一样自己画界面。
这两年桌面跨端也出现了用 Rust 写的 Tauri、Go 写的 Wails,它们和 Electron 不一样的地方就是,没有塞一个 Chromium 进去,而是使用的系统自带的 WebView,包会小非常多,但是整体还是基于 Web 这一套研发思路和对应实现语言去进行桥接交互,但是由于系统 WebView 每个平台不一样,Windows 上是 WebView2,Mac 上是 WKWebView,Linux 上是 WebKitGTK,所以多端显示的一致性反而不如 Electron,还是要写兼容代码。所以这种情况下,即使 Electron 很大内存占用也不低,还是会被选择更多。
第三种是原生开发,也是没有 AI 之前大家觉得难度最大的一种方式。早年苹果系的 Objective-C、Android Java、Windows C++ 和 C#,都需要花很多时间去学习、看书、手编代码,深入研究系统底层原理,才能写出性能更好、更稳定的代码,属于前期投入大、后期用户很享受的技术。我 17 年那会儿刚工作不久,职业发展比较爽的一个很大原因,是抽了半年时间学习 Objective-C 和 iOS 研发,让本职是前端的工作提前往跨端方向走了,刚好可以解决一些只懂前端或只懂客户端都搞不定的难题,那也是我做一线开发非常快乐有趣的一段时间。
等到后面 Swift + SwiftUI、Kotlin + Jetpack Compose、C# + WinUI 3 慢慢出来成熟后,这些原生端语言的写法也慢慢向前端的声明式写法靠齐,也更易写了,声明式代码更短、更好读了。但是在国内,原生完全被 React Native、Flutter、Electron 的广泛使用盖过去了,开发者不多,生态发展完全靠官方推动,这也是为什么很多 App 出活很快,但大家普遍觉得用久了卡卡的,而且这类 App 还占了大头。想迁移到原生的话,假如之前架构实现得不好,大概率只能重写,完全不能复用,实现得好,比如你早就把业务逻辑抽出来了,类似 Kotlin Multiplatform 这类方案把业务逻辑共享、界面各写各的原生,算是第四条路,也是最近几年的趋势。
聊到这里大家应该大概明白了,这里也有一个不可能三角,就是研发效率、体验、性能这三者,选择 Web 是多效率少性能,选原生是多性能体验少效率,选跨端刚好是在这三者取一个中间,做得好容易都占,做得不好,容易没有一边占到好处的尴尬局面。

那么在现在 AI 写代码不是大问题的情况下,该怎么选呢?很多时候还是看场景。如果是重内容的浏览、阅读这类轻应用,直接用 Web 技术最省心;但如果是需要深度调用系统底层能力,或者追求更低内存和更顺手交互的应用,我依然更推荐原生技术,可以第一时间享受到系统官方本身的众多调优。有了 AI 之后,一个人写两套原生的成本其实大幅下来了,效率那一边被补上了不少,调试和体验验证反而成了人最需要花心思的地方。
当然假如实在技术选型不那么重要,工作量非常之大,以及业务效果远大于技术体验选择,选择跨端技术也是可以的,这样快,迭代发布也快,能以最快速度把新功能推给用户。
技术栈上,Mac 版本的 Mole 使用的也是原生的 Swift + SwiftUI,能够让我很好调用系统能力以及非常好的性能体验,想着不将就,所以在 Windows 上我也是想着直接用本身写 Windows 软件最直接的语言,C# 加 WinUI 3,跑在 .NET 10 上,过程虽然难搞,但是相比十年前我了解轮子哥谈的 Windows 开发要简单好理解一些了。
Windows 上的原生界面框架其实挺多的,包括很多年前了解过的 Win32、WinForms、WPF、UWP 这一波,WPF 是 2006 年出的,到现在还在维护,但控件和设计语言不是很好看,非常上一代的感觉,然后 UWP 又被沙盒和应用商店给绑定住,现在微软主推的是 Windows App SDK 里的 WinUI 3,界面框架从系统里面拆出来单独发版,这样就有一个好处,普通的 Win32 程序也能用,基础组件就是 Windows 11 自己的 Fluent 风格,我还挺喜欢,高分屏缩放和 ARM64 都是原生支持。
然后这里 .NET 10 是去年 11 月发的长期支持版本,打包时我把运行时一起打进去,用户不需要另外装 .NET,x64 和 ARM64 这里各出了一个原生安装包,骁龙的 Windows 笔记本就不要走转译了,相当于尽量让用户使用简单不折腾。这里安装和更新用的是开源的 Velopack 框架,可以很方便做增量更新,也很好用。
工程师开始写代码时候肯定会想到能复用尽量复用,所以我开始写的时候也非常想复用 Mac 的 Swift 代码,后面让 AI 分析了一下,十几万行 Swift 代码可以脱离 AppKit、SwiftUI 这些系统框架使用的 20% 都没有,处理的逻辑也是 ~/Library 这类 macOS 自己的路径规则,基本用不上,所以 Windows 版几乎是从零开始写的。
两边的关系其实非常简单,外观和交互我尽量完全一致,尽可能让大家意识里面认为的 Windows 软件不那么精致美观的感觉在这里也保持我认为好的水平,然后底层代码各写各的,关于视觉的一致性还原有了 AI 以后很简单,我把原本的 Mac 版写在 Swift 里的颜色、字号、间距、圆角这些设计 token,直接写了一个脚本生成为 Windows 里面 XAML 资源,文案也是从 Mac 的多语言文件转成 Windows 的格式,11 种语言一起转过来,甚至大家看到的菜单栏里面的那个 runner 动画也是用的同一个脚本同步来的。

虽说同步,可能大家会觉得很简单,其实这里需要花点精力防止 AI 直接给你跑偏了,每次同步其实我会记录对应的是 Mac 的哪一个提交,这样两边就不会走偏去,然后功能上会有一份 SYNC.md 当做对账表,Mac 每加一个功能、修一个安全问题,Windows 这边都会标清楚哪些是已经实现、哪些是刻意不同还是不适用,以及为什么这样判断。
通过这两个机制,我可以很好的让两边的底层完全各写各的,但是又能很好地保持功能对齐,完全不需要刻意去硬写一层兼容去磨平,反而会变复杂,这里能复用的反而是设计、文案以及踩坑后定下来的各种规则,反而这些是 AI 非常喜欢的“能力抽象层”,也就是说随着时代发展,慢慢所谓的代码抽象没有那么重要了,反而是规则抽象更重要。
另外 Windows 开发还有一块比 Mac 要麻烦不少,就是证书签名,没有签名的,一打开会出现「Windows 已保护你的电脑」,甚至 Windows 11 的智能应用控制会直接不让运行,国内不少安全软件也会把没签名的程序当成可疑报毒,这和 Mac 上没签名、没公证的软件提示「已损坏」差不多,平时 Mac 上大家还可以跑一条命令解掉,Windows 上想正规分发,这一步没有啥好办法,就是需要。
调研下来微软的签名生态的确比苹果差太多了,微软有自己的 Azure Artifact Signing,一个月 9.99 美元最省事,居然个人只开放给美国和加拿大的开发者,没办法使用,很奇葩的规定,然后行业还规定从 2023 年起签名私钥必须放在硬件或者云端 HSM 里,不能再是电脑上的一个文件,今年起单张证书最长只能用 460 天,差不多一年多就得换一次证书。
最后我买的是 Certum 的云端 OV 证书,3 年 3 百多美元,签名时登录电脑上的 SimplySign,再用手机上的 App 给一个动态码,SmartScreen 的信誉也跟着证书上审核过的名字慢慢积累。刚开始一段时间的签名包在 ThinkPad 上也会一样被 SmartScreen 拦了下来,后来我每次发版都把安装包提交到微软的恶意软件分析门户,让信誉慢慢积累起来,而且 SimplySign 的登录会话闲置几个小时就会断开,需要再次输入动态码才能继续签名,所以这里其实很难做成云端自动打包。
证书搞定后,就是开发环境的事情了,我的研发要求是代码和 AI 的上下文必须全留在 Mac 上,Mac 用习惯了,真的很难使用 Windows 去研发,这里 Windows 只负责编译和验证效果和各种测试,所以我在 Mac 上装了 Parallels Desktop,大概 3 百多块一年,之前也听不少小伙伴吐槽过这个软件,不过在我的 M5 Pro 上跑 Windows 11 还挺顺滑,让我感觉这个钱花得很值。
它最好用的一点是我的 Claude 能很顺手地操作它,仓库直接作为 Parallels 的共享文件夹挂进虚拟机,变成一个 X 盘,Mac 上改完代码,虚拟机里直接编译,不需要来回 Copy 文件,只是两边的编译产物要分到不同的目录,对于编译、启动、看日志的工作都被我写成了脚本,通过 Parallels 自带的 prlctl exec 直接在虚拟机里执行,程序启动就崩的时候 Windows 只给一个 0xc000027b,Mole 会把真正的异常写进日志,脚本跑完顺手打印出来,Claude 直接就能读到。相当于写代码还是在 Mac 上的 Claude Code 里,调试和运行都在虚拟机里,脚本不能解决的地方,直接用 Codex 的 computer use 去点,只有少部分那种系统确定弹框点不了,我在这里就是这个职责,点点系统弹框确定,哈哈。

说到这里,可以和大伙分享一下 Mole Windows 的架构分层,一共四层,最底下的 Core 只依赖 .NET,不碰任何 Windows 接口,清理规则、路径安全检查、卸载残留的判断都放到这里,测试用的是一个按 Windows 路径规则模拟出来的内存文件系统,这样在 Mac 上也可以很好的跑;往上是 Platform 层,注册表、文件系统、Win32 调用这些真正的系统接口都放在这一层,打开 EnableWindowsTargeting 以后,Mac 上也能编译通过;再往上就是写过应用同学非常熟悉的界面状态的 ViewModel 层,这里和 Mac 版本会一一对应,这样也能够在 Mac 上测,只有最上面这一层的 WinUI 界面必须去 Windows 里编译。

这也是让我一个月时间可以写 8 万多行 Windows 代码、4000 多个测试,但是几乎大部分可以在 Mac 上完成的一个很方便的地方,也是架构设计的巧妙处,当然这里我只提供之前做架构时候的想法建议,大部分是 Opus 5.5 去帮我整的,很牛逼。
接着可以聊测试了,我反而认为在 AI 时代,工程师最大的价值,除了架构设计外就是这个测试验证了,所以为了保证产品是可以售卖的,肯定需要在真实环境测试验证,反复找体验问题去修复的,所以我整了一台 ThinkPad X1 Carbon,这个机器质感还不错的,我把它当成真机环境,设置永不休眠,可以让我和我的 Agent 24 小时去验证测试回归,包括获取各种真实系统环境的参数验证,400 多款 Windows 软件的卸载、残留清理、注册表、启动项测试,大部分在虚拟机里跑,x64 安装包、真实的高分屏、电池、SmartScreen 这些虚拟机看得不准确的,就直接放到这台机器上验,所以这台机器让我感觉也非常值。
然后为了不想在两台机器拷来拷去,最后还是用了 UU 远程,直接在 ThinkPad 那边开一个远程终端,我这边在 Mac 上直接操作,然后还把 ssh 连接当做备用,大部分软件的安装、卸载和调试,都是通过命令行脚本去完成的,剩下需要看界面的,直接通过远程桌面让 computer use 去操作,非常方便,最终相当于我还是在 Mac 上做的所有的事情。
这个过程走下来,到最后做完让几个天使用户帮忙试用,反馈确实帮大家解决了不少痛点,就觉得折腾这么一遭挺值的。能让 Windows 用户也用上顺手、干净的好软件,心里其实挺开心的。
技术栈选好以后,再来聊聊我们在进行客户端应用研发的时候,如何利用各种技术语言的特性来帮助我们产品做得更好。
比如说写 Mac 应用你的主语言是 Swift,其实你完全可以融入一些其他的语言来帮助你解决这个语言不那么擅长的某些地方的问题,当时 6 年前做妙言的时候就是这样,这是一个原生的 Mac Markdown 笔记应用,使用纯 Swift 实现,当时有一个非常难解决的问题卡住我,就是如何用 Swift 来实现一个 Markdown 的格式化能力,很像我们在 VS Code 里面使用 Prettier 的 Markdown 格式化那个能力的效果。
当时想用 Swift 手写实现这个能力,原本的就是用 JS 实现的,非常复杂差不多快要放弃了,洗澡的时候突然想到一个点子,其实在 Swift 里面我完全可以去调用一个 JavaScriptCore 的能力,它是可以执行 JS 的,那我是不是可以把杂乱的 md 当做一个字符串传到这个里面去运行,然后帮我输出非常清晰规范化的 md 字符串,我再解析渲染出来,立马去测试验证,真的可以,效果感觉非常不错,在当时没有 AI 的时代,假如我用 Swift 去实现这个格式化引擎,不知道要多久才搞得出。
再到后面,就更有意思了,当时写 Pake 这个桌面打包工具的时候,主要是 Rust 写的,但是 Rust 的生态在当时也非常差,比如我想写一些下载的能力,完成后弹出一个 Toast 的能力,它甚至都没有成型的 Toast 组件,既然我会前端,当时想到的点是,可以通过 Rust 去调用 JS,让 JS 生成一个 document 容器塞到 Web 里面去,这样在有消息通知的时候,我可以让 Rust 去调 JS,把这个东西渲染出来,效果也非常好,同时不会影响原有的性能,还能够更美观。

其实很多时候,假如你对各种语言都了解一点,碰到难搞问题的时候可以帮助你很快想到一些 Hack 的办法去解决,甚至你还会融会贯通,反过来调用,比如当时在渲染的 Web 里面,需要去调用下载的能力,这个时候还可以反向去调用 Rust 的成型的系统能力帮我去下载,性能就更高。
这个里面有一个很有意思的技术,讲土一点,你可以把它理解成通信,相当于不同语言之间可以通过一个中间层去交换信息,然后监听各自执行,刚刚上面 Rust 和 JS 相互调用这里就使用了这种技巧,开头说的 PhoneGap 给 JS 开的 bridge 也是这种通信。甚至当你脑洞大开的时候,你甚至可以多个语言相互通信,当时做妙言的分栏编辑功能时候,一边是原生的 Markdown 编辑器,一边是 WebView 渲染的预览效果,Markdown 解析用的是 GitHub 开源的 C 语言库 cmark-gfm,性能和能力都非常牛逼,但是很底层,它可以在每一块 HTML 上标出对应原文的第几行,然后我用预览里的 JS 读这些标记,算出当前滚到了第几行,再通过消息通道告诉 Swift,编辑区同步跟着到这个位置,这样就很好实现了两边滚动预览效果是非常同步的。

当时 Kaku 里面也有用过类似的能力,有一个功能是你直接在终端里面输入 # 加一句自然语言回车,我可以帮你去调用一个快速的 AI 帮你生成一个终端可执行命令,这个效果非常酷。

但是实现起来其实也很难,因为正常时候你直接回车,你的 zsh 就报错了,不会执行这一块,因为它不认识,当时也想了很久,发现我可以用终端的转义序列把这句话发给 Kaku,里面的 Lua 脚本接到后交给 Rust 这一层去请求模型,生成的命令再用 Lua 回填到命令行,有一种偷梁换柱的感觉,等一小会儿命令就填好了,然后他可以很自然的回车,这条自然语言生成的命令就执行了,相当于一句话在 zsh、Lua、Rust 走了一圈,最后回到终端上了。

类似这样的场景还挺多的,这种难题的解决是在前 AI 时代,我认为作为工程师最有意思的地方,你可以完全把各种语言当做一个工具,没有任何偏见的去使用,只基于场景选择最合适它的语言,而非我喜欢这个语言,就用这个语言去实现所有的功能。
也即我们做产品的时候,需要充分去利用各个语言生态的特性,来弥补做客户端时候本身语言的一些短板,同时把原本的高性能、交互不错的优势发挥到最好,这样最终效果就非常互补,很有意思。
不过说到底,技术是给业务服务的,好比抢演唱会门票,大家不会在乎你客户端用什么写的、有多顺畅,只在乎能不能抢到票,抢不到票照样被骂,选型选得好只是锦上添花,最终还是要先把用户最真实的需求解决好。
在 AI 时代,以前需要花大力气啃的跨语言难题变少了,很多时候直接上来一个 Opus 5.5 全部一把梭就帮你解决了,不过假如你了解这些语言的特性,在它跑偏的时候,可以提醒它去试试那个语言的那个特性或者那个库,说不定可以帮你做产品少走不少弯路。
哈哈,我现在就想着好好珍惜还能够在某些方面指导 AI 干活,说不定再过半年,这个活也不需要工程师干了,AI 可以完全帮你做了,那会更有趣还是更无趣呢?
我这种 AI 乐观派会认为编码这个事情应该就没意思了,不过还会有更多有趣未知的新东西值得我们去探索,那会更有意思些!
欢迎交流,有在做 Windows 或者跨端开发的小伙伴,也随时聊聊你们的想法和实践。
2026-08-16 08:00:00

最近我写了不少关于独立开发的思考,想着汇总一下,就把 Mole 从开源 CLI 做到 Mac 付费软件这一路聊一聊,当时是怎么想的,哪些事情做下来有用。
去年国庆我在三亚的泳池边写了几百行代码,做了个 Mac 清理的命令行工具 Mole CLI 开源到 GitHub 上,本来只想给自己和同事用。结果不到一年收了 60K star,陆续发了 50 多个版本,121 位来自全球各地的开发者提交过代码,解决掉近 800 个功能建议和 Bug。
其实我一直没太意识到用的人有多少,直到有一次,因为在 README 上挂了两张用 Vercel 加速的图片,流量把账单跑超了,欠了 Vercel 80 刀。当时才反应过来,桌面端可以做了。
之前收到最多的一类邮件来自国外用户,大意都差不多:我父母也用 Mac,我妹妹也用,但他们不会开终端,能不能做一个不用敲命令就能用的版本。这件事拖了挺久,主要是觉得 CLI 本身还没到成熟的地步。等 CLI 跑了大半年,哪些能删、删到什么程度算安全,心里有底了才开始做桌面版,做到自己敢天天用了才发出去。当天晚上十点发布,那一夜通知一直在响,法国、德国各种币种都有,后来为了睡觉把邮箱通知关了。后面几个月一直在加东西,等于是一批用户先掏了钱,再陪着我把它做完。CLI 没有任何变化,照旧开源免费,也会一直更新,付费的只有桌面版。
桌面版做出来之后,我自己用得最多的反而是清理,因为这台 Mac 经常跑出空间不足的警告。我全天开着 Claude Code 和 Codex 写东西,后来才发现 AI 留下的文件跟以前很不一样。
主要是三块。最明显的是编译产物,以前一天手写几百行代码编译三五次,现在一个下午让 agent 跑十几轮,每轮都要编译。Rust 项目的 target、前端的 .next 和 dist、Xcode 的 DerivedData 增长极快,我自己有一次清出 86G 全是这些。其次是 AI 工具自己留下的旧版本,Claude Code、Cursor Agent 都是静默更新的,每次拉个两三百兆的新版本,旧的就存在那里不管。再就是 Ollama 和 LM Studio 拉下来的本地模型,动辄占掉几十 G。

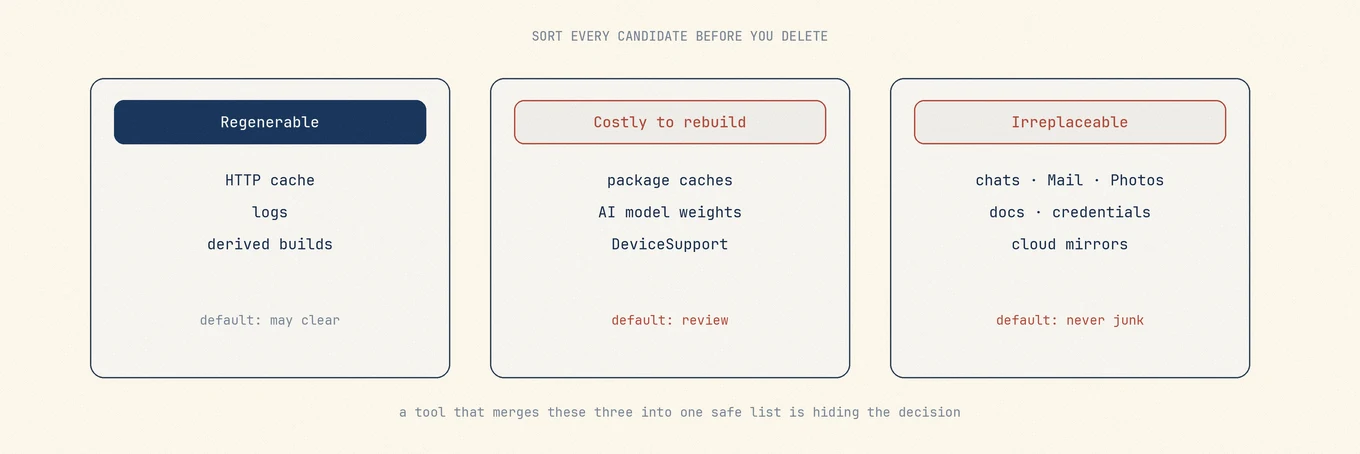
如果把这些都压成同一份「安全可删」的清单当然省事,但代价是替用户把决定做了。后来我处理这类数据主要按拿回来的代价来分,扫出来的每样东西先判定归属,再决定默认要不要勾上。
像编译产物、多数日志、HTTP 和 GPU 缓存,删掉以后重新编译一次或刷下网页就回来了,代价只是几分钟 CPU,只要相关的 App 退出了就可以默认清。但 node_modules、Pods、venv 这些包管理器缓存,看着也是依赖目录,删了却必须重新联网下。在高铁或者飞机上想跑一下项目就只能干等。这两类很容易一起当垃圾清掉,Mole CLI 早期就是这样,后来我专门把所有下载类的目录从 Mac 版的清理列表里摘了出去,得让用户自己看一眼。
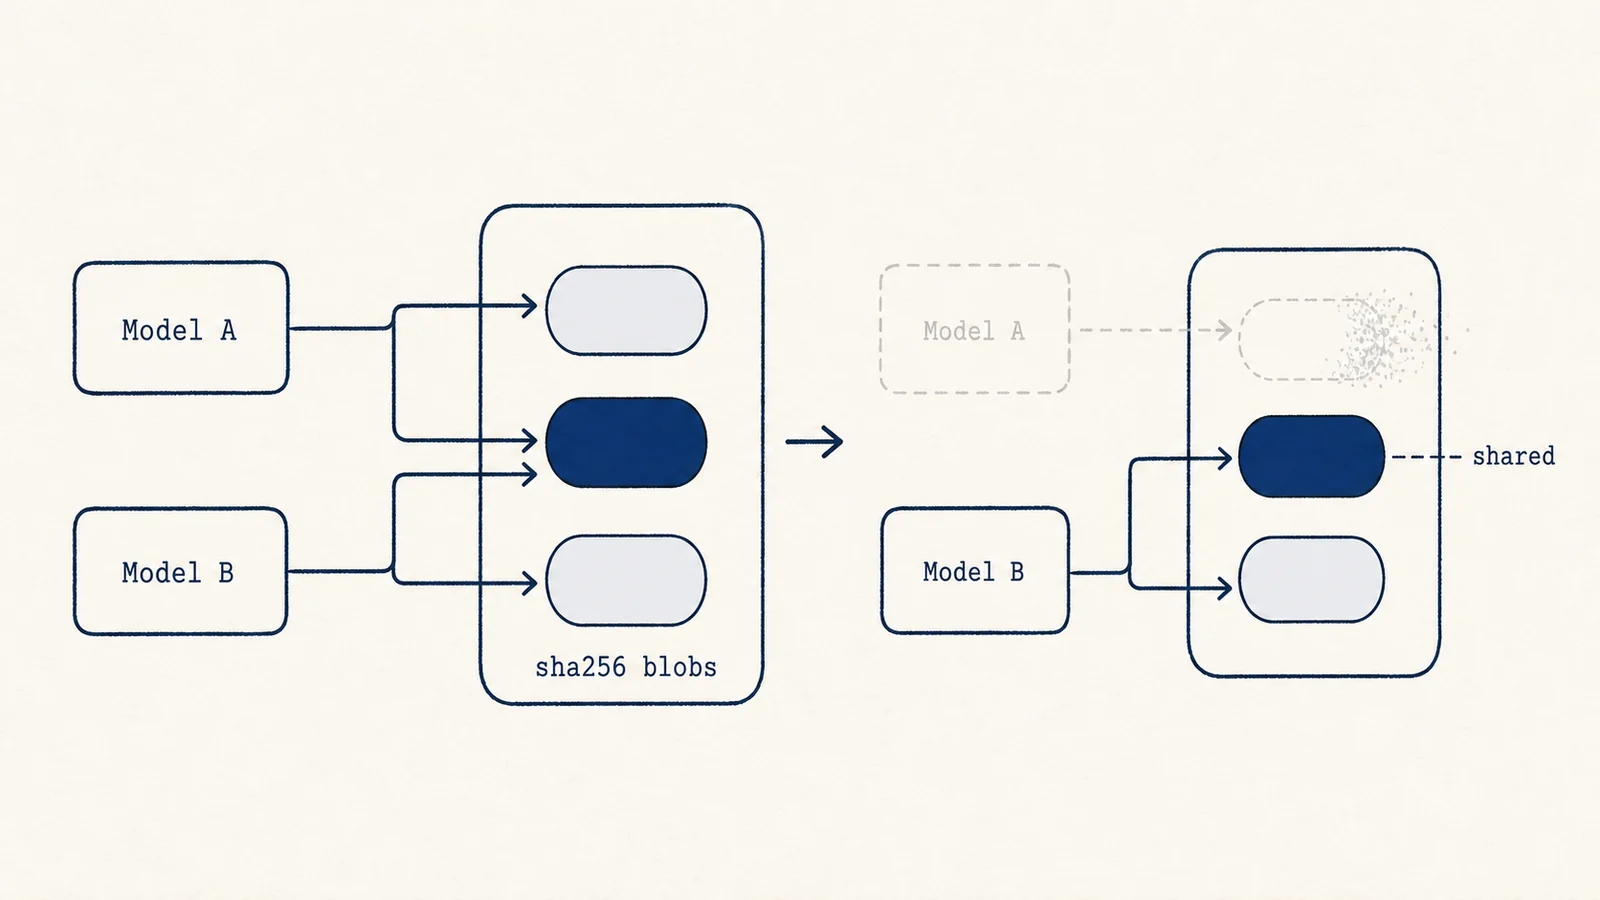
至于模型,是这里面占用最大的一类,几十 G 重下一遍非常耗时。而且通用清理工具想帮着删也删不对,Ollama 把模型拆成一堆按哈希命名的块,多个模型可能共用同一块,从文件系统上直接删掉一个看着很大的块,很可能把另一个模型也弄坏。这种引用关系只有工具自己清楚。
所以 ~/.ollama/models、~/.cache/huggingface 这类路径在代码里是写死的保护名单,扫描阶段根本不会出现,只在磁盘分析那边显示占用大小,模型本身交回给 Ollama、LM Studio 自己管。
还有一类东西比模型更不能动,是 AI 的会话记录。~/.codex/sessions、~/.claude/projects、~/.grok/sessions 里存的是你和 AI 几个月甚至一年的完整对话,里面有当时的思路、被否掉的方案、每一处为什么这么改的原因,删掉就真的没了,说起来比代码本身还珍贵。所以这几个路径在 Mole 里永远不会清,放了多久没动过都一样,同样受保护的还有 memories、plans、skills 和生成的图片。

这些保护名单不是一开始就想好的,基本都是踩出来的。最蠢的一次是 com.apple.e5rt.e5bundlecache,名字里带 Caches,位置也在缓存目录下,怎么看都是缓存,其实它是苹果神经引擎编译好的模型。CLI 早期真把它当缓存清了,用户那边所有用到识别功能的 App 全挂,一直到重启才好。从那以后我养成一个习惯,看到名字里带 cache 的目录,先在心里过三个问题,谁写的,重启之后谁会去读它,万一删错了怎么找回来。有一个答不上来我就不动它。
这类工具好不好,我不太看能清多少,主要看删之前让不让你看清楚。
Mole 清理的时候是先扫描,逐项列出来,每一项显示具体是什么、在哪、占多少,拿不准的默认不勾选,确认完再删,删的时候优先进废纸篓,后悔了还能找回来。扫描和清理全程在本机完成,文件和结果都不会上传。代价是慢,多了一步确认,赶时间的时候会嫌它啰嗦,但我还是想让它宁可漏删也不误删。

卸载走的是同一套逻辑,选中一个 App,Mole 会把它散在系统各处的东西一起翻出来,逐项标上路径和大小,上面这张图里 Claude 本体只有 781MB,~/Library/Application Support/claude 却有 7.67 GB,真正占空间的从来不是应用包本身。登录项和后台服务也放在同一页,不用再去系统设置里一个个找。
举个例子,macOS 系统更新下载下来的安装包,也就是 /macOS Install Data 那个目录,经常十几个 G,看着是完美的清理目标。但系统可能还等着用它把更新装完,删早了机器就起不来。所以它在 Mole 里是默认不勾选的审阅项,前面叠了三道门,系统里有更新等着装就整行隐藏,安装包最近 14 天里动过就隐藏,安装相关进程还在运行也隐藏,哪个信号读不出来,就当它有风险,直接不显示。
真到执行删除那一刻,root 权限的脚本还会把这几项检查重新跑一遍,不通过就非零退出,不会出现「报告说清了 12G 其实一个字节没动」这种事。
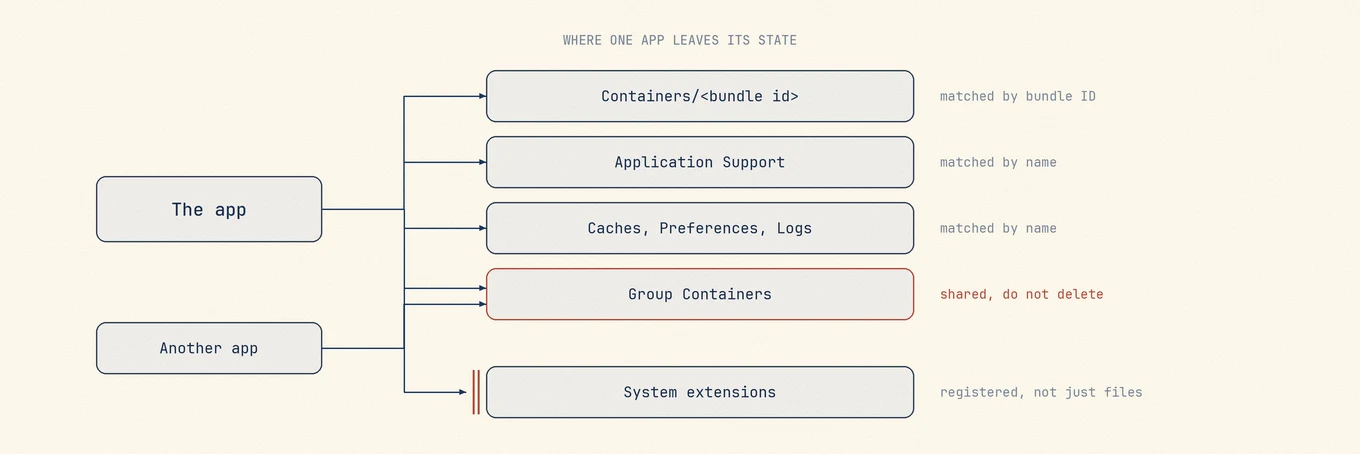
我自己判断一款清理工具好不好,有个很土的办法。装同一个厂商的两款产品,只卸掉其中一款,看它会不会把两款共用的 Application Support 父目录或者 group 容器也列进去。列进去了,说明它是按名字匹配的,不是按归属判断。归属都说不清的工具,我不太敢让它批量删东西。
该找的文件它都会去找,只是平时不会主动来打扰你。
装了之后它不会隔三差五弹个通知提醒你该清理了,也不会扫完之后跳出来说你的电脑有多危险。你想清的时候打开它,不想的时候它就跟不存在一样。
界面上也是同一个想法,扫描没结束就不进结果页,等一下就能好的事连加载提示都不给,要等一阵才出现一个正在忙的动画,完成页也提前留好空间,结果出来的时候窗口不会跳一下。这些规定都很琐碎,合起来就是它用起来稳的原因。
底下要做的事情本来就不好预测,这时候加动画帮不上忙,还是得流程本身够可靠。我不希望一个维护工具需要人一直盯着,发起任务,等它完成,再拿回屏幕就够了,不用老闪着灯提醒你来看它。
无障碍也算在里面,朗读顺序、键盘操作、焦点稳不稳,和看上去安不安静是同一件事。系统开启「减少动态效果」之后,行星会停止装饰性旋转,状态变化也减少空间移动,任何操作都不依赖用户看懂动画。

以前我做东西基本只考虑身边同事和朋友用得顺不顺手。这次从 CLI 做到桌面端才发现,要让一个 70 岁的老爷爷也用得上,中间要过的事情多得多,也有意思得多。下面这些都是从这三个月的用户邮件里翻出来的,我最大的收获几乎都在这里。
有位快 70 岁的英国用户,说他犯了一个老年时刻,把 Mole 又买了一遍,「第二笔钱就当做送你,谢谢这个出色的工具,帮我省下了比 CleanMyMac 多得多的英镑」。我建议他退款或者把多出来的授权送人,他去问了一圈,第二天回我「我邻居没人用 Mac,我 Bluesky 上的关注者也没有,这一轮算我请你」。收到这样的信,我会觉得必须把产品做得更好,才对得起这份信任。
一位美国用户纠正了我一个关于地区习惯的错误想法。我一直以为美国人看温度就得用华氏,所以美区默认给了华氏,他说:「美国人在所有技术相关的场景都用摄氏度,只有天气和体温例外。我装上 Mole 看到 110,吓了一跳。Apple 给美国人看的规格也是摄氏度,fastfetch、neofetch 在美式系统上默认也是摄氏度。建议保留华氏切换,但所有地区默认摄氏度。」后来就改成了默认摄氏可切华氏。他还追了一封聊定价,说我给的那个数字读起来不像刻意定的价,像是从别的货币换算过来的,又补了一句「我说外来不是指反华,而是人们希望感觉到作者理解他们」。说实话那个价格就是我拍脑袋定的,做产品之前从没认真想过定价这件事,被一个素不相识的用户当面点出来,挺不好意思的,原来一个价格数字也会影响用户的决策。
一位视力轻度障碍的用户说:「看起来是个很不错的 App,可惜我用不了,它似乎把深色模式写死了。我系统设成浅色,也只用浅色模式的 App。」Mole 只做深色其实是个刻意的决定,菜单栏面板像 HUD 一样浮在壁纸上,深色玻璃眩光更少,也不用多一个主题开关。但这个理由对他不成立,我一直觉得自己在无障碍上做得挺认真,却完全没想到浅色模式本身也是一种无障碍需求。这封信收到有一阵了,Mole 到现在还是只有深色,浅色一直排在列表上没做完。一个说自己在意无障碍的产品,把一位明确说了用不了的用户晾到现在,这件事我一直有点过意不去。
还有一位德国大学的讲师来申请教育授权,说这「不仅是对我个人的支持,也是一种有意义的教育层面的支持」。原来还有国外的老师在课堂环境里用我的产品,这是我没预料到的用法。一位匈牙利的医生则给了最真实的差评,「说实话,这个价格对一个免费应用也能做到的事情来说有点高了」。这条我一点都不觉得刺耳,不同国家购买力差别很大,他不是在抱怨,是在帮我定位问题。
Mole 里我自己最喜欢的几个功能,起源其实都不是我想到的。AirPods 快没电时会收到一条提醒,是做电池健康那阵子加的,我一直没遇到这个场景,直到某天下午真的收到了,很贴心又不打扰。屏幕常亮做了三种不同的行为,也是用户提醒之后才补的,周末突然出门,AI Coding 那边可以继续跑,帮我省下不少异步的时间。状态里能看到 iPhone 的电量,这一块之前不太好实现,后来也找到了办法。这些都是用户告诉我要加的,加完之后我自己受益最多。
答疑、退款、重置激活码这些事加起来不到用户量的 1%,花半小时写个脚本就能全自动,但我没写。只有自己一封封处理过,才能感觉到用户到底要什么、为什么退款、哪里让他不舒服,而那经常不是他第一句话问的东西。我给自动化定的门槛是三件事都成立,问题反复出现,答案已经稳定,例外也都摸清楚了,在那之前我宁愿一封封回。目前这样还有效,我没花钱做营销,增长基本来自口碑,退款率低于 0.8%。买的人里有不少是先用了很久 CLI 的老用户。
发布之前我也没有搭工单系统、客服平台和知识库。工程师喜欢先把这套支撑系统搭起来,因为那是熟悉的工作,AI 又把它压缩到半天,更容易让人过早动手,可是搭起来只要半天,维护却是长期的事,而且暂时根本用不到。等哪天收件箱开始丢请求、看不清响应时间,或者同一个问题得到了不同回答,那才是真正需要新系统的时候。AI 能把开发压缩到几天,但和人打交道不能省,不然做产品也没什么意思。自己一封封回信,慢慢也就有了信任。
写代码其实只是一小部分,更多时间都在弄清楚别人到底痛在哪里、怎么不用看说明书就会用、怎么让需要的人看到。一个人把这些环节全跑下来,感觉和写代码完全不一样。
对一个清理工具来说,不删什么比删什么重要得多,前面的保护名单就是这么来的。很多功能本身挺好,但只要不在这条主线上,我就坚决不加,不然功能一堆砌,自己也不好维护。
脑子里要清楚接下来的路线,知道哪些需求不该接。软件不用看说明书就能顺手用,才算及格。有不少朋友提过很酷的建议,只要会让软件变吵或者变复杂,我都婉拒了。一百个用 Mac 的人里有一位觉得它有用,就足够了。
现在一个功能进路线图之前要过三道门:用户没点进这个功能就不能有常驻的定时器、监听器和采样开销,不能为一点小便利去扩大特权助手或者新增系统权限,有合理默认值的时候不能加设置项。这不是所有软件的通用原则,是 Mole 给自己定的规矩,常驻的工作、特权和配置每多一样,用户就得多信任你一点。

我基本没攒过大招,尽量做到每周都发一版,这样用户的问题能及时解决,也能跟人有来有回地聊。每次发布、更新、宣发其实都是一次很好的沟通机会,也让之前没看到消息的人知道你在做什么。
现在用 AI 写代码,省下的时间更应该花在想清楚问题上。比如把真正的问题聊透、把界面文案改得谁都能看懂。Token 怎么花都不心疼,但要花在用户真正能感受到的地方。
Mole 从第一天就是全球化的,英文内容也发得比中文多。这段时间的感受是世界很大,用户很广,而且他们从一开始就愿意信任你。你顺手帮过的人,后来很可能就成了你的用户,因为彼此有过真实的来往。我也没花钱做过推广,X 上的消息一开始传播很快,但热度过去得也快,反而有些东西发到 YouTube 之后衰减非常慢,只要东西够好,有人推荐,能在上面活很久。
数据我花了不少时间看,销量、访问量、用户评论、退款原因和 GitHub 上的 issue 放在一起,能看到很多自己平时完全没想到的盲区,也知道大家逛到哪一步就不买了。
最后一条是心态。如果一门心思只想快速涨粉或卖货,人很容易动作变形。把平时真实的摸索、踩坑和更新过程发出来,大家看得到你是一个实在做事的人,自然会产生信任。现在网上浮躁的东西太多,愿意长期认真做东西、不忽悠人,反而最能走得远。
Mole 桌面版目前是清理、卸载、优化、磁盘分析、硬件状态五块,界面上每一块对应一颗行星,清理是地球,卸载是火星,优化是水星,分析是木星,状态是太阳。这和我小时候喜欢看各种行星运行有关系,加上十年前学会前端之后第一个特别想学的就是 WebGL,正好凑到了一起。行星的贴图我换了不下 10 次,从 NASA 官网下了很多才挑定,转的方向、转速、完成之后的飞行效果也都照着真实的天体来。
这部分完全可以不做,做个菜单栏点一下清一下的小工具也能用。但 AI 产生的赛博垃圾已经够多了,与其拿 Token 再堆一个能跑就行的界面,我还是想做个舒服一点的东西出来,不浪费我的 Token,也不污染你的时间线。
我做事情喜欢水到渠成,不喜欢急躁地赶进度,这三个月下来更是这么觉得。踏踏实实做出一个自己用着舒服、别人也愿意买单的东西,就很开心了。
CLI 在 GitHub 上开源免费,Mac 桌面版在官网 mole.fit。
第一次做付费产品,肯定有很多没考虑周全的地方,欢迎大家随时提建议。回头看,上面那些让我最受启发的改动,几乎都来自用户的一封邮件或一个 issue。多听大家的吐槽,对我帮助真的很大。
2026-06-07 08:00:00

今年 4 月我组装了一台小机器狗,做的过程在推特上发过几条,大伙应该都刷到过,从买零件、装结构,到最后它能听懂指令、走两步、还能对话几句。
缘由要从过年那段时间说起,那阵子我天天用 Opus 4.6 写代码,发现很多地方它写得比我好,又快又准,越用越 FOMO,于是就想,要不试试软硬件结合的东西,这块相比纯软件可能还有一点门槛。
真想做了,方向很快就落到具体问题上,传感器怎么读,舵机怎么控,通信怎么兜底,电池、结构件和故障怎么处理。这些都比「做一台机器人」实在,于是我买了 STM32、ASRPRO、ESP32-C3、MG90S 舵机、OLED、DHT11、锂电池,还有一套 3D 打印结构件,凑成一台能听懂话、会趴下、会走路、还能接云端 AI 对话的小机器狗。
真上手才发现,最费时间的反而是各种小细节,MG90S 舵机 4 个里总有一个不太稳,OLED 我带电插一次就直接烧了,又多等了几天零件。直到 DeepSeek 对话、温湿度读取和动作控制都真跑起来,我才慢慢体会到「AI 进入物理世界」是什么意思。
从软件视角看,具身智能很容易被理解成给大模型接上一副身体,但真把线插上、电机转起来、结构件震起来,感受完全不一样,一条自然语言指令一路要变成结构化意图、动作序列、PWM、力矩、电流和接触,每一层都有自己的时间、能量和误差预算,还冒出一堆纯软件里根本不用操心的问题。
发完「你不知道的大模型」那篇文章后,有小伙伴起哄,看来你要写「你不知道的具身智能」了。我一想这台小机器狗刚好能帮上忙,虽然很皮毛,但我想聊的「感知、空间、动作、力矩」这些具身智能的基本概念,它身上其实都有,于是就开始了。
文章前半写这台机器狗的创造过程,后半是我基于公开论文、官方博客、开源项目和第三方资料整理的学习笔记,希望能给在 AI 之外、也想了解具身智能的朋友,多一个工程师视角。
这台小机器狗最后做成了一个低成本异构系统,加起来成本大概 200 多的样子,能听到唤醒词后进入对话,把用户指令交给云端 LLM 做语义理解,再把返回的结构化动作转成 STM32 能执行的舵机控制。
| 模块 | 型号/规格 | 价格区间 | 负责的事 |
|---|---|---|---|
| 主控 | STM32F103C8T6 | ¥5-10 | 舵机控制、传感器读取、基础动作逻辑 |
| 离线语音 | ASRPRO | ¥15-25 | 唤醒词和本地关键词识别 |
| 联网模块 | ESP32-C3-MINI | ¥10-15 | Wi-Fi、配网、云端 AI 对话 |
| 辅助 Wi-Fi | ESP-01S | ¥8-12 | 备用通信通道 |
| 舵机 | MG90S 金属齿 × 4 | ¥40-60 | 四条腿的角度控制 |
| 传感器 | DHT11 | ¥5-10 | 温湿度读取 |
| 显示 | 0.96 英寸 OLED | ¥10-15 | 状态显示 |
| 电源 | 3.7V 1000mAh 锂电 | ¥15-20 | 供电 |
| 结构件 | 3D 打印 PLA | ¥20-30 | 机身和四条腿 |
把它拆成数据流,对调试很有帮助。后面很多卡住的地方,最后都落在周边硬件上,比如唤醒词误触发、联网超时、舵机角度或供电不稳,这些偏硬件的坑甚至能整理成一张排查表:
| 步骤 | 输入 | 输出 | 常见问题 |
|---|---|---|---|
| 唤醒 | 环境音频 | 唤醒事件 | 误唤醒、漏唤醒、噪声 |
| 联网 | 唤醒事件和用户语音 | 云端请求 | Wi-Fi 配网、断线、超时 |
| 意图解析 | 文本或音频 | 结构化动作 | 参数范围、动作名称、上下文 |
| 本地通信 | 结构化动作 | UART 帧 | 校验、丢包、重传 |
| 运动执行 | UART 帧 | PWM 输出 | 抖动、供电、舵机偏差 |
| 状态回传 | 传感器和执行结果 | 文本或语音回复 | 读数延迟、失败状态表达 |
一开始也想过,要不要换一颗更强的芯片全包了,真接线以后发现不是一回事,唤醒、联网、PWM、传感器读取、云端请求,各自要处理的延迟和稳定性都不一样。
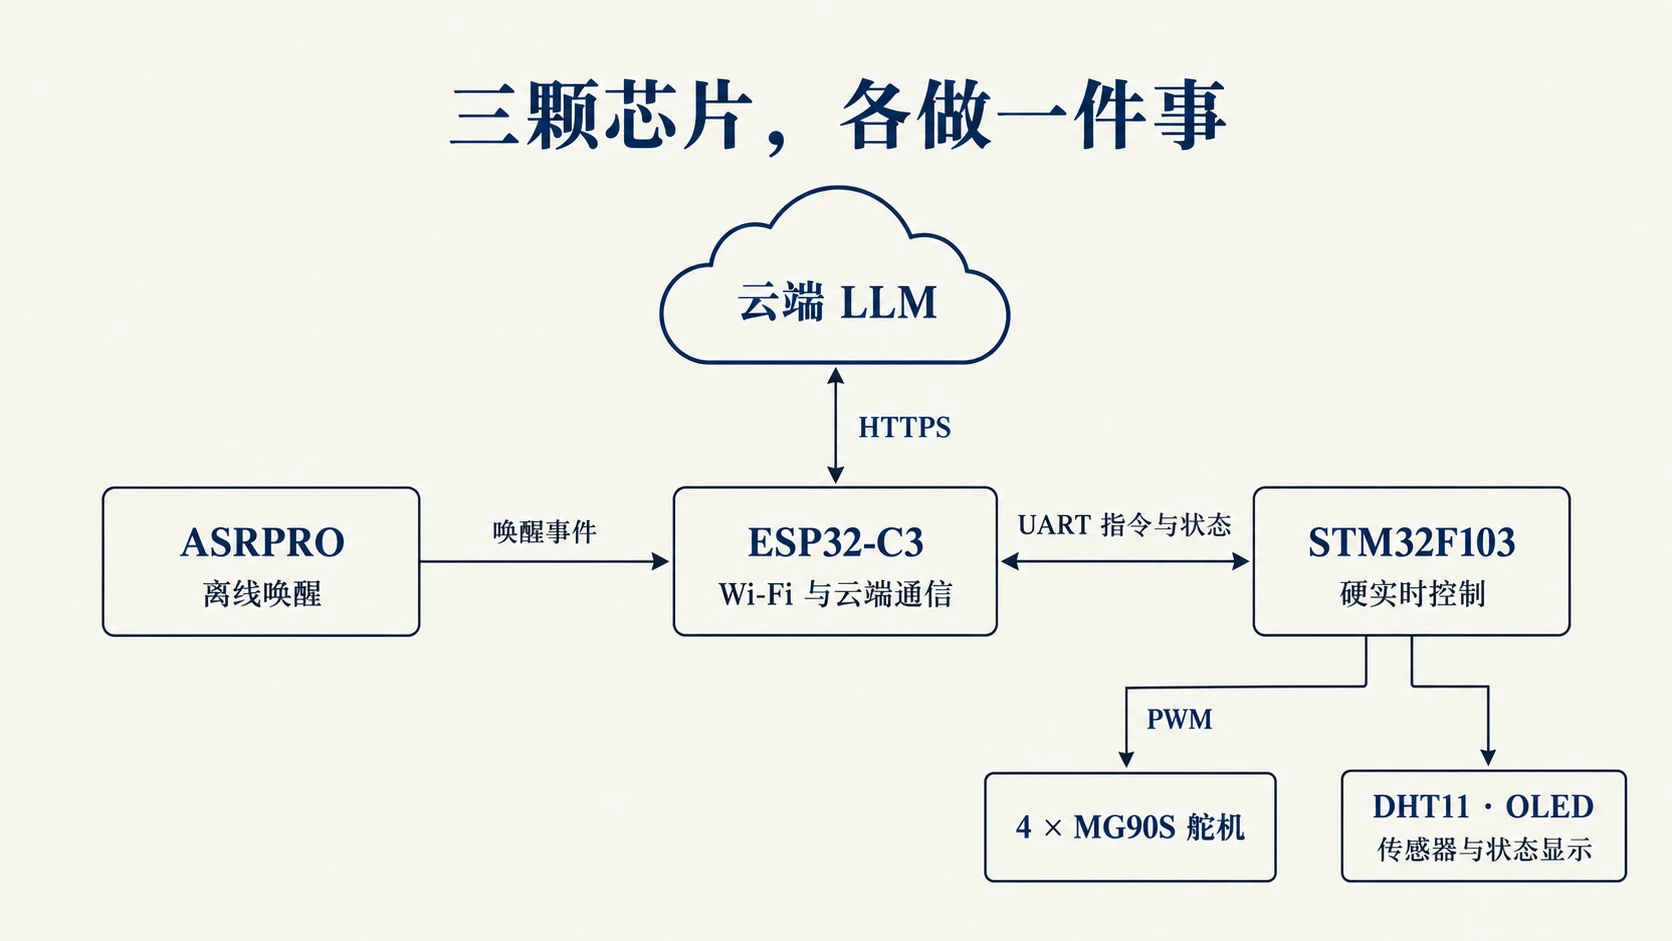
ESP32-C3 负责 Wi-Fi 和云端 AI,接入 2.4GHz 网络,把语音或文本转给云端模型,再把结果发给 STM32。它比 STM32 更适合联网,但如果同时承担 PWM、多路串口、网络请求和对话状态,调度会很快变重。
ASRPRO 负责离线唤醒,低功耗监听环境声,识别到唤醒词再拉起联网,比全程上传音频更省电,也少一些隐私压力。
STM32F103 是 72MHz 的 ARM Cortex-M3,Flash 64KB、SRAM 20KB,跑模型不现实,做硬实时控制刚好;4 个 MG90S 舵机用 50Hz PWM 控角度,0.5-2.5ms 脉宽对应 0-180 度,硬件定时器能稳定输出微秒级 PWM,舵机走路时就不容易被任务调度带偏。
大概清明节前的那个周五零件和工具就全部到了,当天晚上开始整,持续几天,最后它从一堆零件变成了一台绑着线、能走好几步、能听懂简单指令的小机器狗,挺有趣的。

|

|

|
这里也用到 MCP 的概念,只不过在这台小机器狗里更简单,就是给模型和设备定一份「能力清单」。设备把自己能干的事报上去,模型照着清单调用。
对我最有用的地方,是把哪些能力留在本地、哪些能力交给云端先分清楚:设备端控制扬声器、LED、舵机、GPIO 等本地硬件,云端扩展智能家居、PC 操作、知识搜索、邮件等能力,这样边界会清楚很多。
实际完整走一遍是这样的,ESP32-C3 先上报自己有哪些能力(servo_control、sensor_read、gpio_write),我说「曼波坐下」,云端模型生成一个结构化调用(目标舵机、目标角度、速度参数),ESP32-C3 把它翻成 UART 指令发给 STM32,STM32 再一步步调整 PWM、回传执行状态。
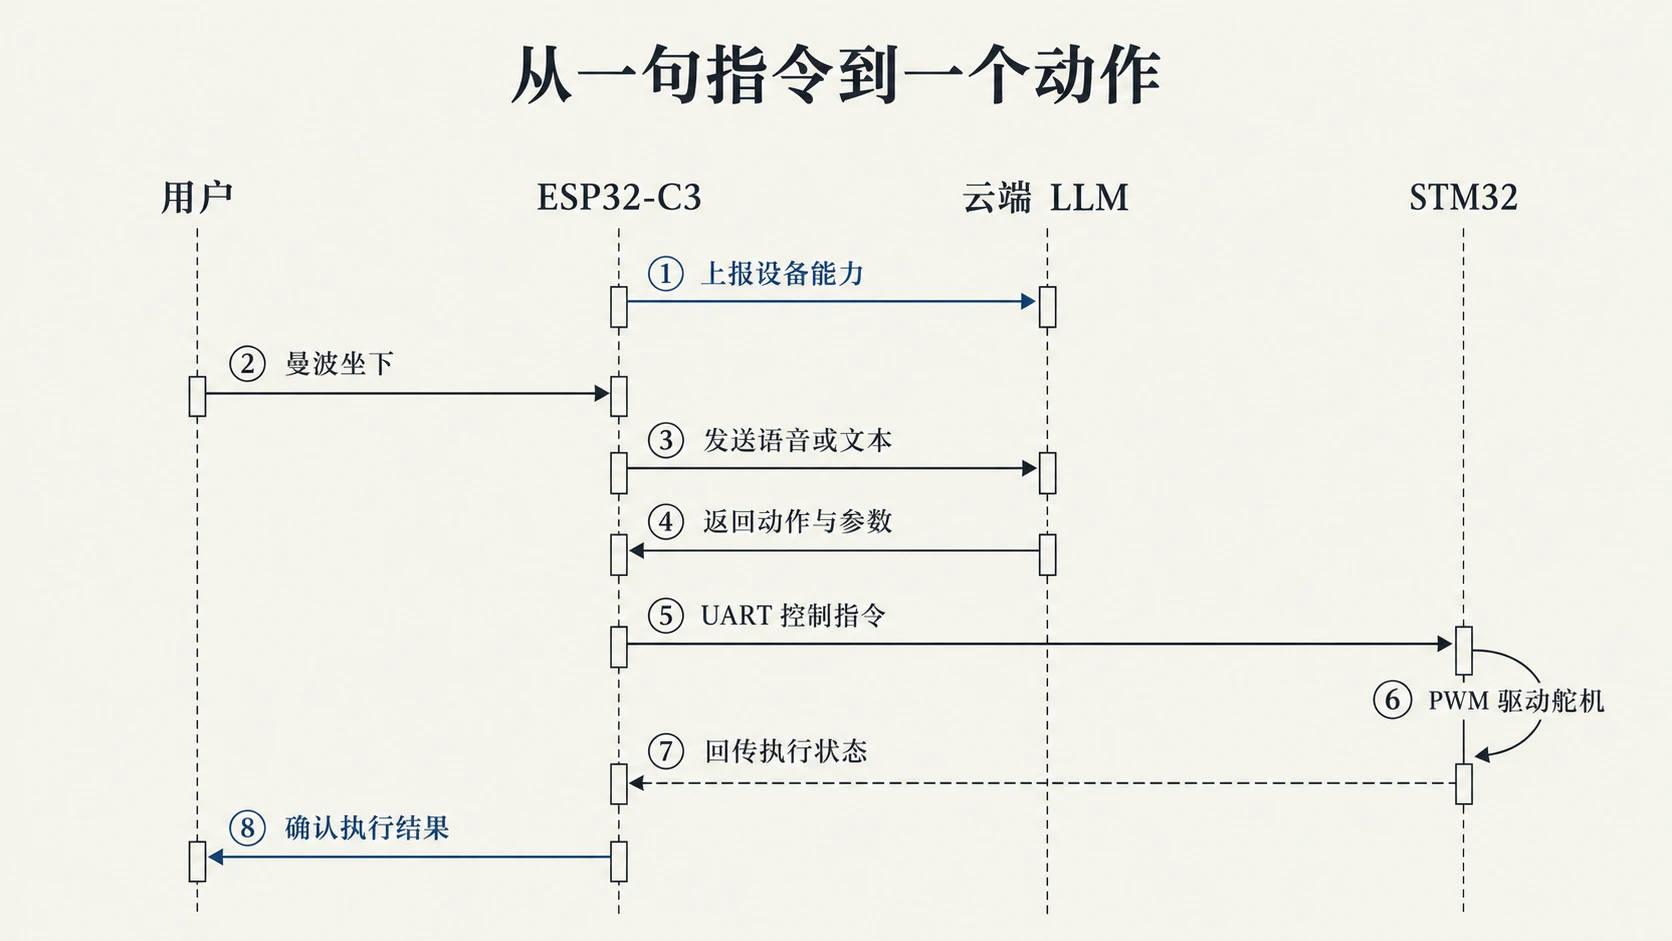
这套小系统已经能听懂「坐下」、「站起来」、「现在温度多少」。空间能力完全没有,自己在哪里、椅子在哪里、往左走两步会不会撞到,全不知道。
小机器狗听不懂「往左走两步绕过椅子」,它根本不知道椅子离自己多远,也不知道自己在房间里站哪儿、朝哪边,更没有一张能持续更新的 3D 地图,深度感知、位姿估计、空间地图,这三样能力它都没有。
补空间能力不是再多接一个模块。深度相机、IMU、能跑 SLAM 的板子一上来,成本、功耗、算法栈就完全不一样,STM32 那套小系统也接不住。
后面还会多出四条新链路:「相机标定」要处理内参、畸变、曝光和同步;「位姿估计」要算清相机、IMU 和机身坐标之间的变换;「地图更新」要考虑环境变了之后旧地图怎么失效或修正;「动作规划」则是地图上可达,不等于真实脚底能稳定落下。
小机器狗如果只在桌面上演示,可以绕开这些问题。一旦放到房间里,地板反光、桌腿遮挡、线缆、台阶和光照变化都会进来。
图像模型擅长回答「这张图里有什么」这种 2D 问题,但机器人还得继续回答:这个物体离我多远,遮挡是什么情况,从哪个方向抓更稳,移动一步以后视角和支撑点会怎么变。
在 2D 图像里,一个杯子只是几百个像素。放到机器人世界里,一个杯子是有体积、重量、摩擦、遮挡和接触面的物体。机器人常用的 3D 表示主要有下面这几种,工程代价差别不小:
| 表示 | 解决的问题 | 工程代价 |
|---|---|---|
| Occupancy / Voxel | 哪些空间被占据,哪里能走 | 需要多视角或深度估计,分辨率和算力要权衡 |
| Point Cloud | 传感器原生 3D 几何 | 点云稀疏、无序,语义处理成本高 |
| NeRF / 3D Gaussian Splatting | 重建高保真场景,生成新视角 | 训练、更新和动态物体处理仍然麻烦 |
| 3D Scene Graph | 房间、物体和关系的空间记忆 | 依赖稳定感知和语义绑定 |

低层避障常用 occupancy 或局部 cost map,抓取看点云和末端位姿,长期任务需要 scene graph 这种带关系的空间记忆。难的是把它们放到同一个时间轴和坐标系里,3D 场景一旦无法持续更新,很快就会变成过期照片。小机器狗完全没有后两者,所以「往左走两步绕过椅子」这种指令根本没法执行。
SLAM 和点云擅长几何,能给位姿和障碍物,但语义弱,系统知道前面有一团点,却不知道那是椅子还是纸箱。NeRF 和 3D Gaussian Splatting 擅长重建和生成新视角,对机器人来说,更要看它们能不能把仿真、数据增强和世界模型拉近真实场景。
3D Scene Graph 更接近长期记忆,它把房间、桌子、杯子、抽屉这些对象变成节点,把「杯子在桌子上」「抽屉属于柜子」「钥匙上次在玄关」变成关系。家庭机器人要回答「我上次把扳手放在哪里」,只存一堆视频帧很难做到。
空间记忆还必须保留不确定性。机器人只在画面里看过一次杯子,就不该永久相信它还在原处。对象名称、最近观测时间、置信度和可见性,实现时都要一起存。

VLA 也在从 2D 往 3D 迁移。早期 RT-2、OpenVLA 主要把 2D 图像、语言和动作连起来,桌面抓取够用,但指令如果变成「把被挡住的蓝色积木拿出来」,2D 像素就不够了。机器人要知道蓝色积木被谁挡住,是否要先移开挡住它的物体,移开后是否会让别的东西掉下来。
3D-VLA、SpatialVLA 这类工作尝试把 3D 场景、SE(3) 位姿(位置加朝向,6 个自由度)和动作生成合到一起。Figure 的 Helix 系列虽然可以从单目视觉输入工作,但它仍然需要在内部学到深度、可操作性和物体关系。显式输入可以是 2D,内部表征要进入 3D。

单目摄像头做人形机器人同样需要权衡。单目可以通过多视角、运动视差和神经网络估深度,但需要足够的数据和稳定运动。主动深度或 LiDAR 是用硬件换确定性。Tesla、Figure、Boston Dynamics、宇树的传感器选择不同,背后是在视觉数据、算力、实时性和安全冗余之间取舍。
这也是我这台小机器狗的边界,它能把语言变成动作,但动作还不在空间里,没有位姿、地图和遮挡处理,「往左走两步」这种指令还是没法落地。
我那台小机器狗跑的还是固定动作,你说「坐下」,它就调出一组预设好的舵机角度,并没有真的从画面和语言里生成新动作,只是在语音入口前面加了一层意图识别。
在真实的具身智能里,VLA(Vision-Language-Action)才是值得细看的方向,把视觉、语言和机器人状态一起喂给同一个模型,让它直接输出动作,减少「视觉检测、语言理解、规划、控制」之间一堆手写接口,不过接口少了,排错难度反而会增加不少。
| 路线 | 代表工作 | 动作怎么表示 | 放到真机上会怎样 |
|---|---|---|---|
| 离散 token | RT-1、RT-2、OpenVLA | 把连续动作离散成 token | 容易接入语言模型,但精度和序列长度受限 |
| 动作块 | ACT | 一次预测未来 k 步动作 | 减少高频控制的累计误差 |
| 扩散生成 | Diffusion Policy、RDT-1B | 从噪声逐步生成动作轨迹 | 适合多模态动作,比如左绕或右绕都合理 |
| 流匹配 | π0、π0.5、SmolVLA | 生成连续动作分布 | 采样更快,更适合低延迟控制 |
| 高低频双系统 | Helix、Gemini Robotics 系列 | 高层推理拆任务,低层 VLA 执行动作 | 更接近大脑和小脑分工 |
同样是「输出动作」,有的模型给关节角,有的给末端执行器(手或夹爪)的位移,有的给夹爪开合。关节角贴近硬件但难跨机器人迁移,末端位姿更通用却要配上逆运动学。
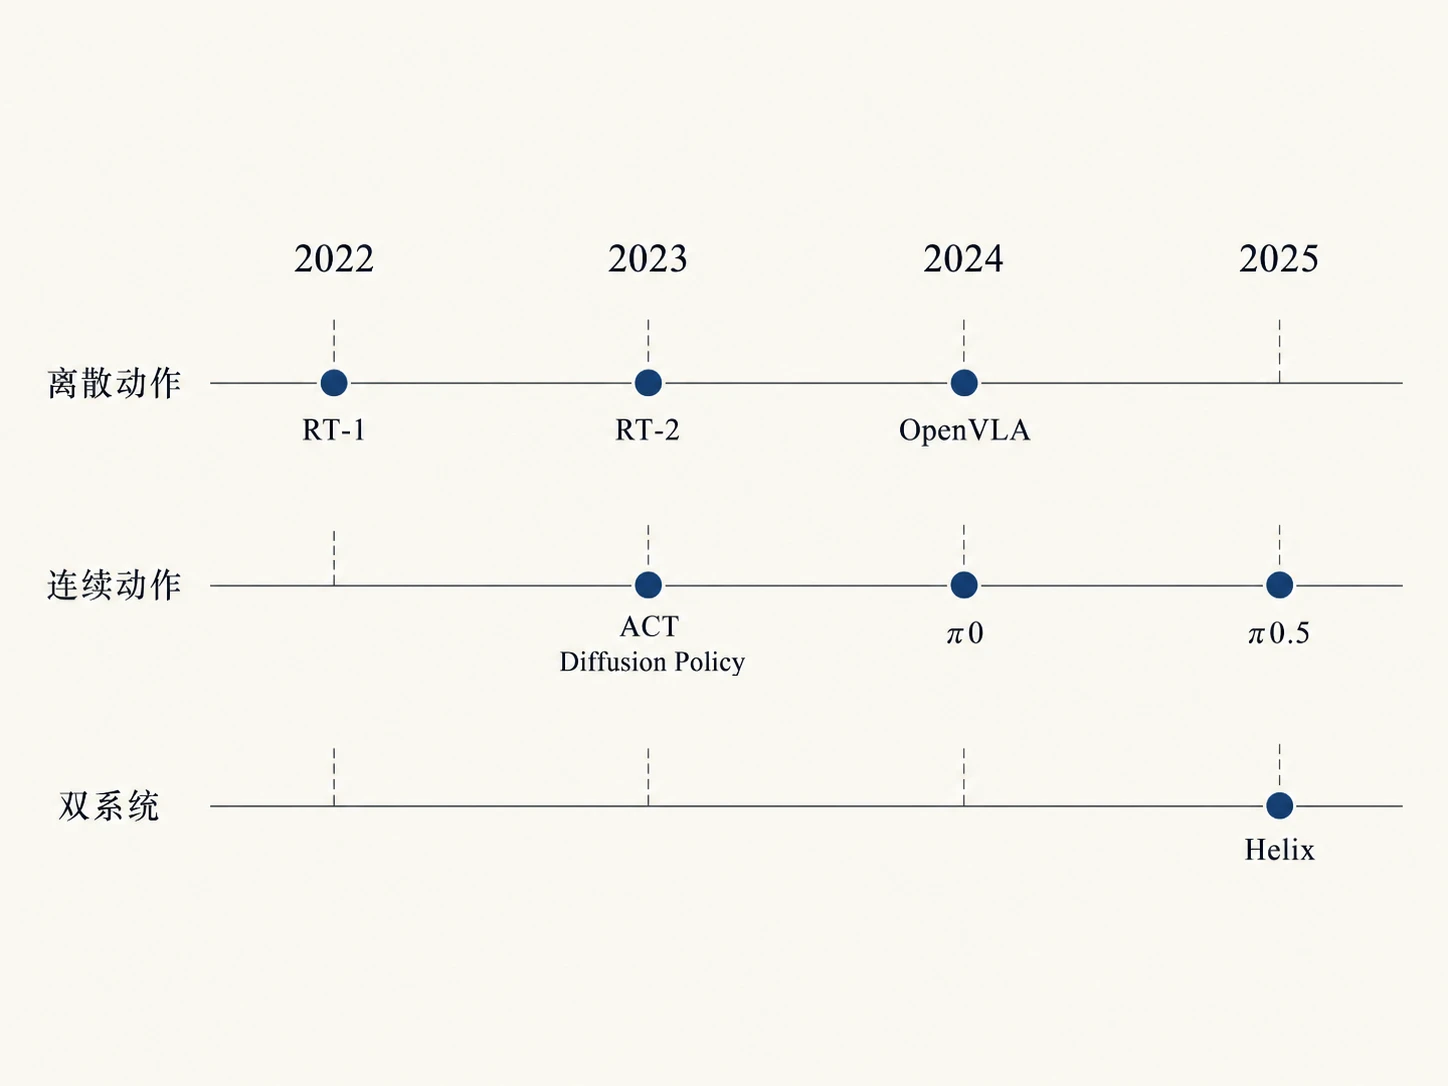
最早是 RT-1,把 13 万条演示、700 多个任务喂给 Transformer,第一次把机器人控制当成序列学习。RT-2 再把互联网图文混进来训,让模型把网上学到的常识也带进控制,代价是连续的关节、位姿、夹爪压成 token 会丢精度,动作一多 token 串也跟着变长。
ACT 更直接,把动作打包成一小段一起预测。ALOHA 用一对便宜的遥操作臂就能插 USB、拉拉链、煎蛋,到现在还是很多人上手模仿学习的第一站。Diffusion Policy 解决的是「绕开障碍物」这种有多条合理路径的情况,普通回归容易学出个直接撞上去的折中动作,扩散从噪声一步步生成,反而能把几种都对的走法都保住。
π0 改用流匹配,采样快不少。π0.5 再把泛化往开放环境推,混进高层子任务、口头指令和网页数据一起训。Physical Intelligence 给的结果是训练环境越多、到新家越稳定,大约 100 个环境就追平了「直接在目标环境训练」。
SmolVLA 走另一头,把门槛压到消费级硬件,450M 参数、只用社区数据、3 万条 episode 以内就能跑,能力未必最强,但把 VLA 从大公司集群里解放了出来。社区数据多样性要覆盖光照、相机角度、房间和演示质量,和软件工程里的测试集类似,单一实验室的干净数据,未必比一批有噪声但覆盖更广的更管用。
2025 年后高低层分工更明确。Google DeepMind 的 Gemini Robotics 就是一路,ER 1.5 负责理解和拆任务,配套的 VLA 管把每步变成动作,还出了 On-Device 版,本地低延迟,50-100 条演示就能适配新任务。
这种分工演示起来往往很好看,但放到产品里就容易暴露问题。「按本地垃圾分类规则整理桌面」,高层模型要查规则、拆步骤、解释意图,低层模型要识别每个物体并放进正确容器,两层混成一个黑盒,真出了问题就很难排查。
Figure 的 Helix 也走分层系统。早期 Helix 里 S2 是低频 VLM,S1 是 200Hz 动作策略;Helix 02 又补了 1kHz 的 S0 全身控制层,把平衡、接触和协调放到更快的一层。小机器狗里的处理方式也类似,慢模型做理解可以,平衡、接触和协调得交给更快的一层。
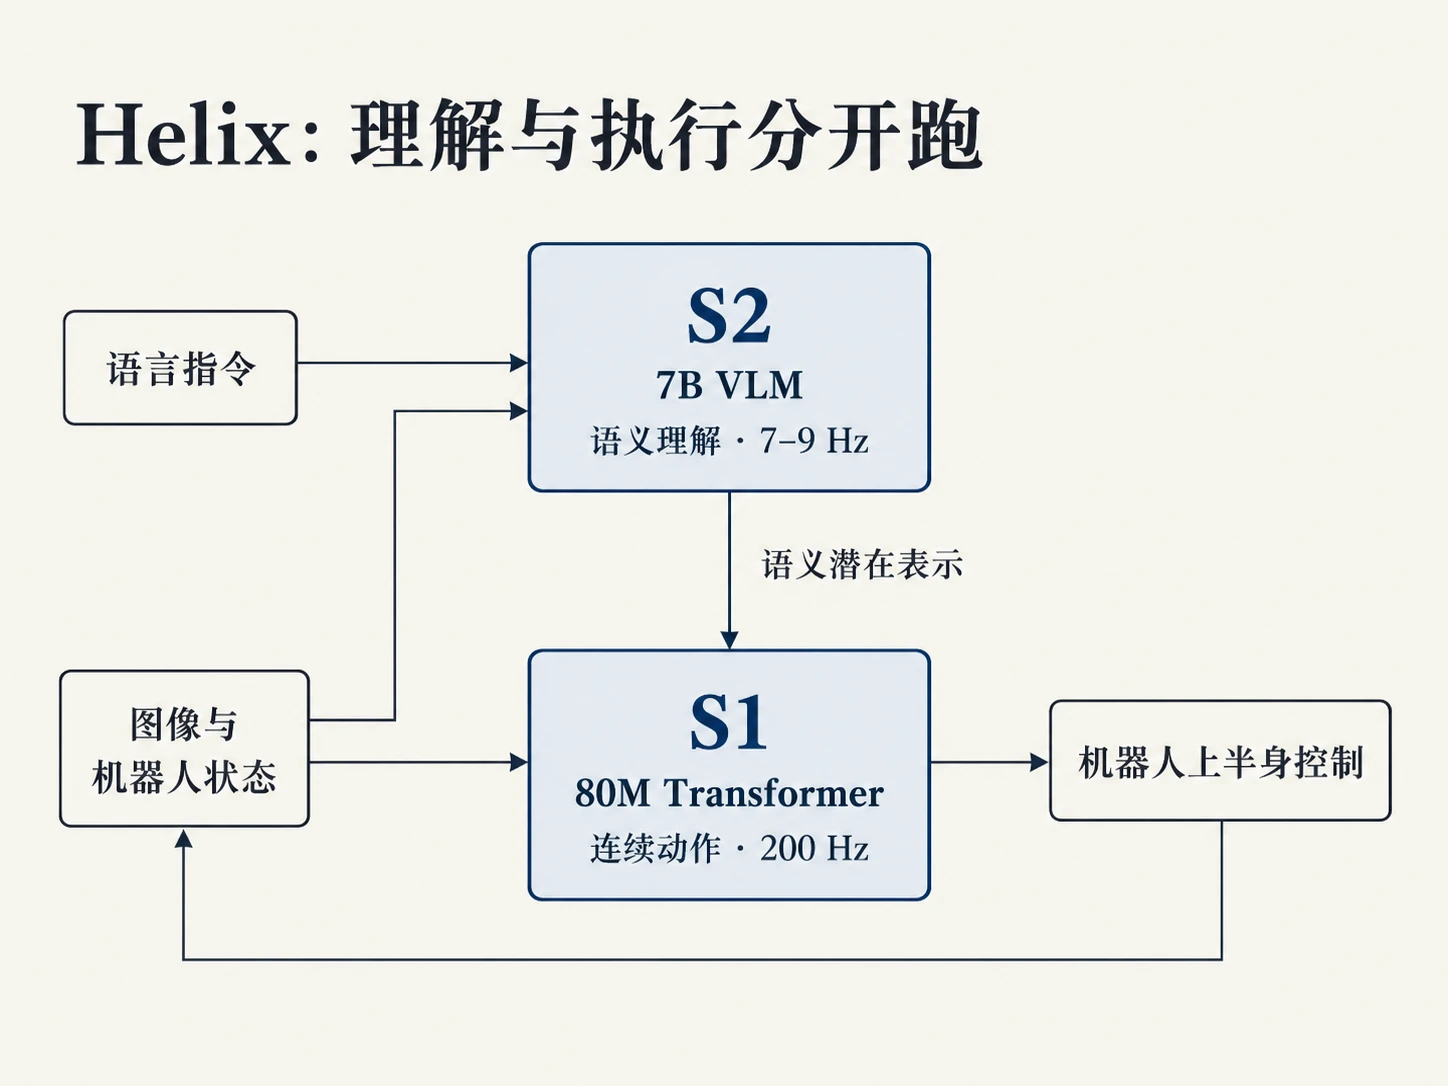
机器人大脑的难点,除了听懂话,还得考虑动作怎么表示。动作太粗抓不准,动作太慢控制不稳,一旦动作不连续,真实电机和接触又会把误差放大一截,最后效果就会偏得很明显。
如果要把机器人系统的控制层拆一下,我一般分成大脑、小脑、肢体三块,落到工程里,其实就是不同频率的控制问题。
| 层级 | 负责什么 | 典型时间尺度 | 常见技术 |
|---|---|---|---|
| 大脑 | 视觉理解、语言交互、任务拆解 | 100ms 到 1s | VLM、VLA、LLM、GPU/NPU |
| 小脑 | 轨迹生成、平衡、动作协调 | 1ms 到 50ms | MPC、RL、IK、实时 CPU |
| 肢体 | 电机电流、编码器反馈、急停 | 微秒到 10ms | MCU、FPGA、EtherCAT、CAN-FD |
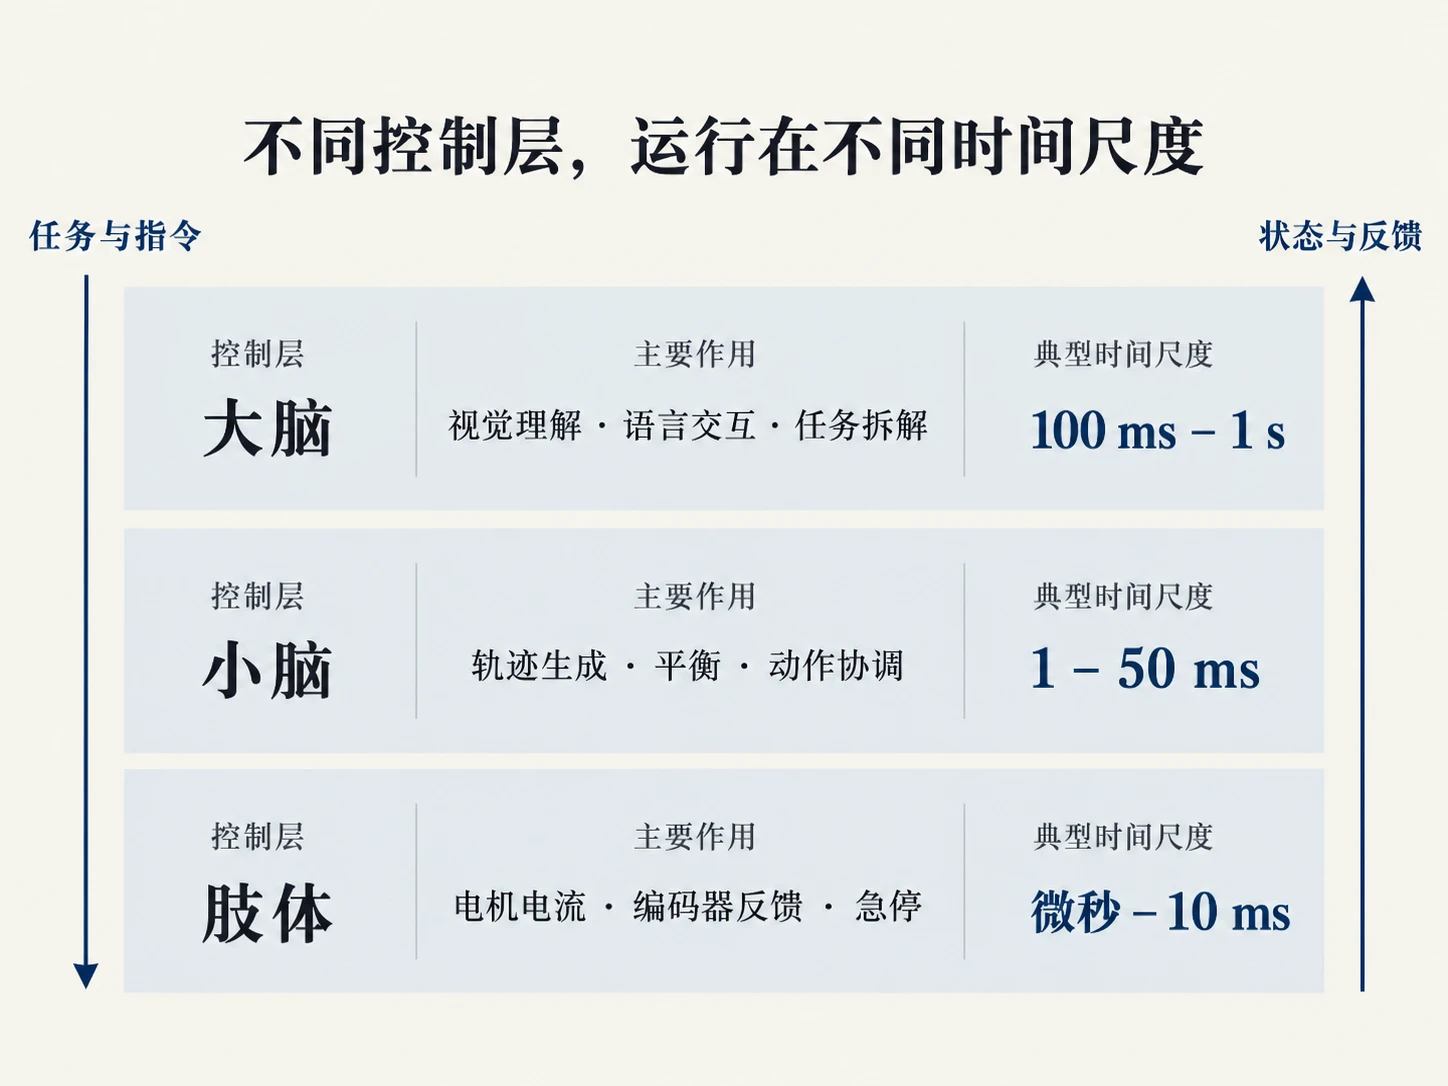
小机器狗里也有这个分层,不过是极简版本。DeepSeek 对话是大脑,STM32 里的步态序列是小脑,PWM 和舵机是肢体。它不做动态平衡,1-2 秒的云端响应也能接受,但换成人形机器人,1 秒的平衡延迟就足够让它摔倒。
大脑层慢一点没关系。机器人听到「把杯子放进水槽」,会把它拆成找杯子、走过去、抓起来、松手,这种语义活儿不需要 1kHz。但小脑不行,它得快。人站着走着其实就是个倒立摆,控制回路一般得跑 200Hz 到 1000Hz,低了一受扰动就出问题。
再往下到肢体层就更要硬实时。电机控制要看编码器、估速度、限电流,一旦不对就立刻停掉,很多系统干脆把这一块放到专用 MCU 或 FPGA 上,避开 Linux 这类调度带来的不确定延迟。
延迟出在哪一层,表现完全不同。大脑慢,你觉得反应迟钝;小脑慢,一碰就倒;肢体慢,电机先抖再发热。
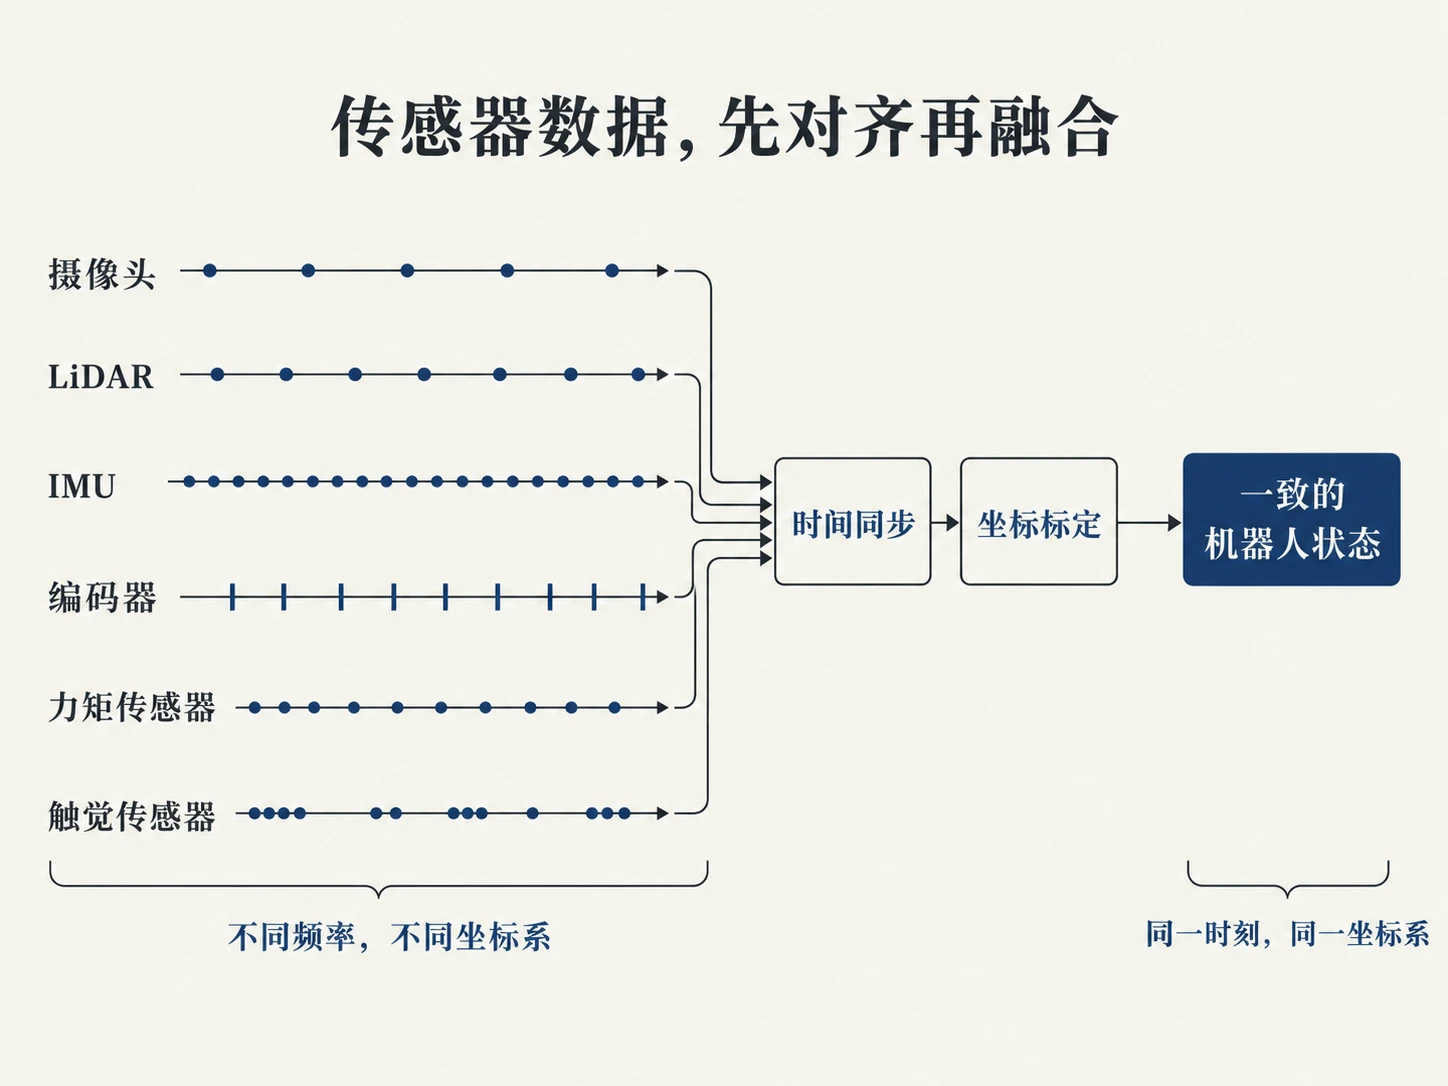
还有个容易被低估的坑,大脑、小脑各用各的坐标系,传感器又快慢不一(IMU 几百赫兹、摄像头几十赫兹、编码器上千赫兹),得靠标定和时间戳把它们对到同一个时间、同一套坐标上。标定一旦漂了,模型拿到的状态就跟真实世界对不上号,算法看着像是突然变笨,所以很多机器人 Debug 会先回到传感器、外参、零点和时间戳。
聊完时间,第二块就是能耗,机器人同样绕不开执行器和电池。一个人形机器人有几十个电机,电机、减速器、丝杠、编码器和驱动器往往是 BOM(整机的零件成本清单)里最贵、最难规模化的部分。
灵巧手尤其难。电机、腱绳、触觉、线束和散热全得塞进巴掌大的地方,所以很多公司反复打磨手部。人一天约 2000 kcal、折合 2.3kWh 就能活动很久,机器人没有骨骼韧带那套被动支撑,站着不动也得一直靠耗电撑着姿势。
第三块是训练数据,比普通大模型的数据难采太多了。文字能爬,图片能标,自动驾驶靠满街的车就能收一堆,可轮到机器人操作,你得有真硬件、有场地、有人看着,还得划好安全边界,这些都备齐了再开始采,成本直接高一个数量级。数据大致从这几个地方来:
| 数据来源 | 优点 | 短板 |
|---|---|---|
| 人类遥操作 | 动作质量高,任务语义清楚 | 一个人通常一次教一台机器人 |
| 真机自主运行 | 最接近部署分布 | 失败有硬件和安全成本 |
| 仿真数据 | 可并行、可复现、便宜 | 摩擦、形变、接触和视觉质感有差距 |
| 人类视频 | 规模大,覆盖真实物体 | 缺少机器人动作标签和本体状态 |
| 合成数据 | 容易覆盖长尾场景 | 需要证明能提升真机策略 |
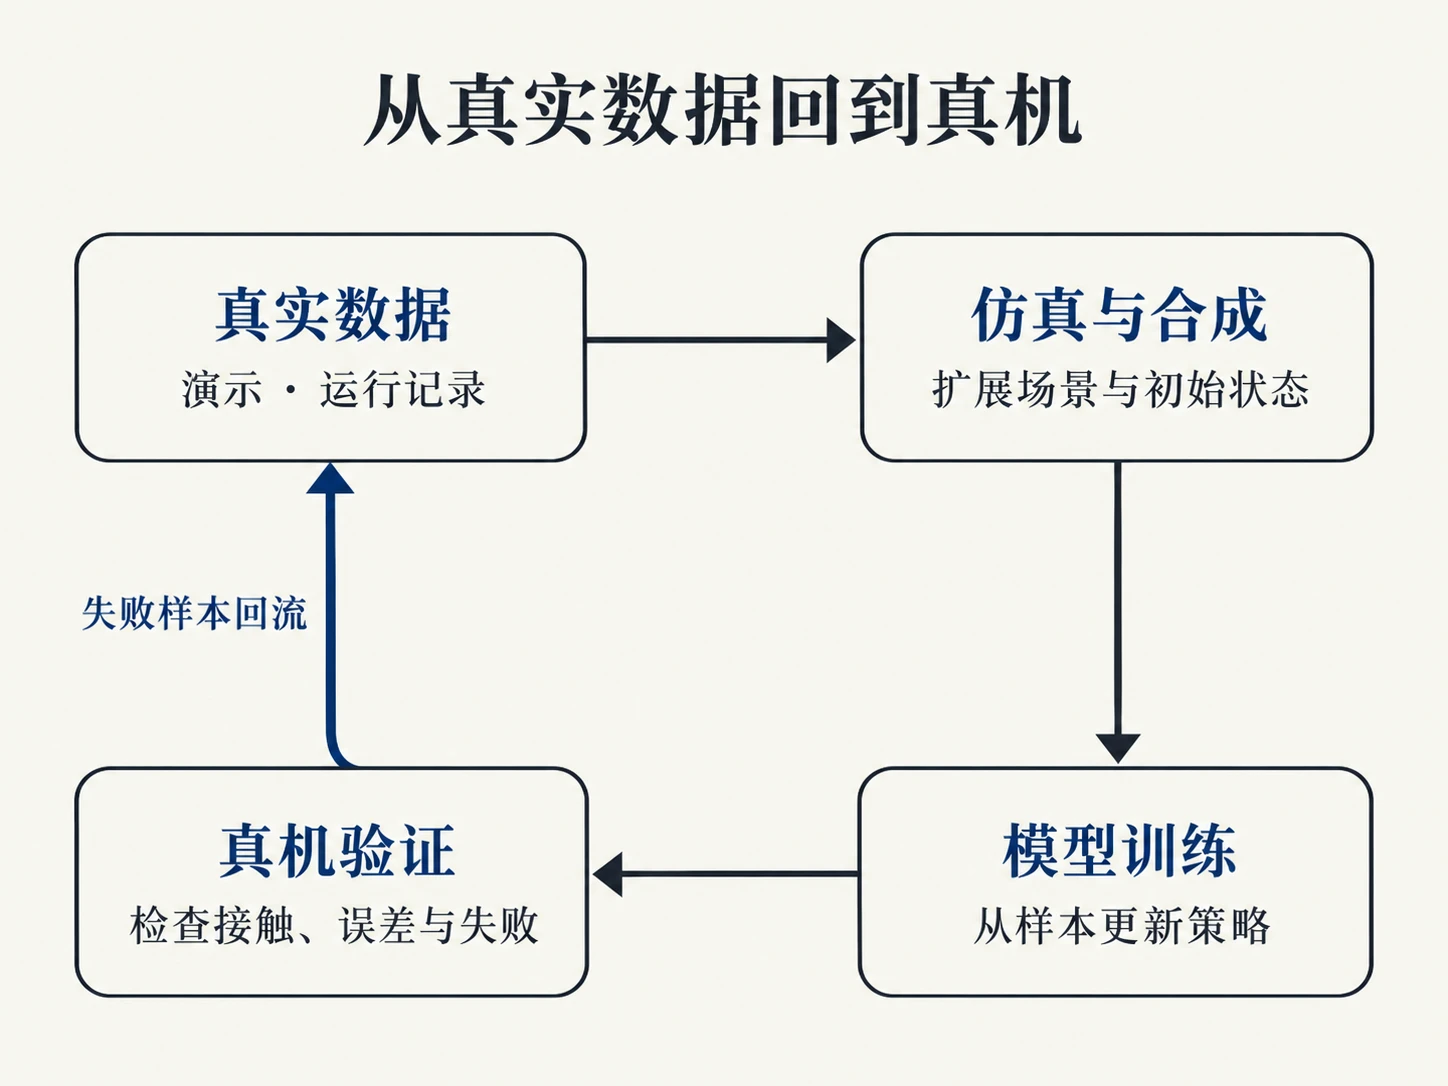
仿真本来想绕开采集的麻烦,但它和真机终究不一样。光照、摩擦、间隙、磨损、传感器噪声、电机发热,仿真里都很干净,真机上却全是。比较稳的做法是先在仿真里把策略练到不犯低级错误,再拿少量真机数据校一遍,把失败样本收回去再训。指望仿真一步到位的,基本都会低估接触和传感器的误差,光靠仿真那点数据其实远远不够。
我很喜欢 Tesla,也很早就买了它的股票,所以看 Optimus 难免带一点个人偏好。单独写 Optimus,是因为它把 FSD 迁移、纯视觉、端到端训练、自研执行器、工厂试跑和大规模制造放在同一台机器上。拆开研究它,手从演示灵巧走到长期可靠要多久,失败样本怎么补上接触数据,制造体系怎样把执行器、线束、传感器和电池做成可维护产品,这些问题都会更具体。
表里的数字来自 Tesla AI Day、财报电话会和第三方技术整理,主要是一些公开口径和目标。记得当年 AI Day 的 PPT 和视频被不少机器人公司一帧一帧研究,这件事本身就很有意思。
| 项目 | 早期公开口径 | Gen 3 相关口径 | 为什么重要 |
|---|---|---|---|
| 身体基础自由度 | AI Day 2022 披露 28 个基础 DoF,手另算 | 仍围绕 28+ 身体 DoF 展开 | 身体运动已经很复杂,主要变动集中在手和前臂 |
| 手部自由度 | 每只手 11 DoF,6 个执行器 | 下一代手和前臂公开提到 22 DoF,第三方整理提到每手 25 个执行器 | 灵巧操作空间变大,线缆、散热、寿命和标定一起变难 |
| 计算平台 | 躯干内运行类似车端 FSD 计算机 | AI5 被公开口径描述为面向后续更大模型和端侧推理 | 长期依赖云端会受限,端侧能效比会很早限制产品形态 |
| 成本目标 | AI Day 2022 给过低于 2 万美元的长期设想 | 财报电话会继续把 2 万美元级别作为规模化目标 | 这取决于执行器、磁体、线束和装配良率,模型只是其中一项 |
| 部署阶段 | 先在 Tesla 工厂内部测试 | 多次财报口径提到内部使用、设计迭代和后续产线目标 | 工厂更像训练场和验证场,外部销售时间表仍要谨慎看 |
手部升级看着是小改动,放在机器人里其实很大。工厂里的「拧螺丝、插连接器、搬零件、贴标签」和家庭里的「拿杯子、开门、叠衣服」,只靠手臂大范围运动很难做好。手指要有足够多的接触点,也要知道物体是否滑动、是否易碎、接触面在哪里,这些都得一起考虑上。

2026 年 4 月 16 日,第三方拆解提到一组 WIPO 公开的 Tesla 手和前臂专利。专利本身不等于量产设计,但其中 WO 2026/080693 很能看出结构取舍,Joint Assembly for Robotic Appendage,也就是机器人附肢关节组件。当时在推特看到这个报告,我印象很深。
拆解材料里的思路是绕开传统销钉铰链,用一块扁平复合件夹在两节指节之间,上下两层弹性体,中间夹一片很薄的增强片,材料候选里出现了 Vectran 和 Nitinol,前者是液晶聚合物纤维,后者是镍钛超弹性合金,用来做方向性刚度。

这个设计要控制的是弯曲方向,手指弯曲方向要软,拉伸、压缩、剪切、扭转、侧摆这些方向要硬,传统销钉靠几何结构限制多余自由度,这个方案靠各向异性刚度来限制。工程上它有三个潜在收益,指节之间能形成接近滚动接触、转动轴随角度移动,更像真实手指;弹性体自带回弹,不一定要额外回位弹簧;腱绳还能穿过中性面,减小反复弯曲带来的疲劳。
这个案例看着像结构设计,背后其实牵连了灵巧手里一连串问题,一个关节结构会影响手指回弹、腱绳走线、腕部布局、前臂空间、装配公差和维修方式,它能不能在一天几千次抓取后还保持一致,演示里看不出来,得放到工作现场长期用才知道有没有问题。
Optimus 和 FSD 同源是 Tesla 反复强调的技术点,AI Day 2022 提到,机器人躯干里的计算机来自车端 FSD 计算机,软件栈也复用了车辆里的目标识别、occupancy network、室内导航和运动规划,也有第三方把 Optimus 描述成 8 个摄像头输入,输出到 78 个执行器的端到端系统。
Tesla 其实不是「单一端到端神经网络」,FSD 完整构建涉及 48 个网络,更准确的说法是,Tesla 是追求端到端可学习的统一系统,工程实现更可能是共享表示的多任务 multi-head 架构。
| 层 | 公开资料里常出现的能力 | 对机器人有什么用 |
|---|---|---|
| 视觉输入 | 8 个自动驾驶级摄像头,纯视觉路线 | 降低传感器成本,代价是深度和冗余要靠数据与模型补 |
| 3D 表示 | Occupancy Network、深度估计、3D 重建 | 把 2D 画面转成可通行区域、障碍物和物体位置 |
| 任务理解 | Grok 或语言层处理指令 | 把用户语言或工厂任务转成可执行步骤 |
| 运动与操作 | 运动规划、操作规划、平衡控制 | 把目标位姿变成身体和手的连续动作 |
| 执行输出 | 第三方整理提到 28 个身体执行器 + 50 个手部执行器 | 高维动作空间,调试和安全比自动驾驶更难 |
自动驾驶的动作空间其实不算大,方向盘、油门、刹车这几样基本就概括了。但人形机器人完全是另一回事:Optimus 按 78 个执行器算,每一个时间步都得把身体、手臂、手指、平衡和接触一起兼顾到。杯子稍微滑一下,手指抓握力、手腕位姿、手臂轨迹和重心就得跟着同时调整。
端到端路线能省掉模块之间一堆手写接口,让视觉、语言、空间和动作通过统一训练互相影响,但出了错很难定位,抓错零件时,是深度估计错了,物体语义错了,动作头错了,还是执行器跟踪失败?工程系统仍然需要日志、状态回放、安全控制器和可解释的中间信号。
把 Optimus 放到工程系统里,我会先拆成四个接口,这样更容易看清楚它难在哪。
| 接口 | 输入 | 输出 | 怎么验收 |
|---|---|---|---|
| 视觉到 3D | 多摄像头图像、本体姿态 | occupancy、物体位置、可达空间 | 遮挡、反光、窄通道、低纹理物体下是否稳定 |
| 语言到任务 | 人类指令、工厂 SOP、当前场景 | 子任务序列和失败恢复策略 | 指令变化后是否仍然走合理流程,失败能否重新规划 |
| 任务到动作 | 子任务、末端目标、接触状态 | 身体、手臂、手指动作轨迹 | 频率、延迟、抖动、接触力是否在安全范围 |
| 动作到执行 | 关节目标、电流限制、传感器反馈 | 执行结果、故障码、急停状态 | 长时间重复操作后是否漂移,故障是否可定位 |
这四个接口放到小机器狗上也能对上,只是尺度差很多。我的狗只有「语言到固定动作」和「动作到 PWM」,少了视觉到 3D 和接触状态。Optimus 的难点是四个接口都要同时成立,而且任何一层出错都可能被统一模型吞进黑盒里。
Tesla 的优势常被概括成车队数据,这里只说对一部分,车队数据能给 Optimus 带来视觉常识、空间理解、光照适应、动态物体预测和 occupancy 表示,但汽车并不处理杯子摩擦系数,也不用手指判断纸箱是否瘪了,其实现在机器人最缺的是真实物理世界的接触数据。按目前公开资料,Tesla 的 Optimus 数据主要来自这四类:
| 数据源 | 它补什么 | 还缺什么 |
|---|---|---|
| 车辆 fleet | 视觉常识、空间理解、occupancy 表示 | 抓取、力控、触觉、接触失败 |
| 人类第一视角演示 | 任务语义、手部细节、工具使用 | 机器人本体状态和真实执行误差 |
| Digital Dreams / 神经网络世界模拟器 | 长尾场景、光照、物体位置、初始状态变体 | 生成数据的物理一致性仍要真机验证 |
| 工厂 Optimus 在线反馈 | 最接近部署分布的成功和失败样本 | 受机器人数量、任务边界和安全限制影响 |
所以才有了人类操作员带着头盔和背包相机去现场采集这种做法。前段时间我还看到国内的具身智能公司和家政公司合作,让阿姨带着传感器和摄像头去打扫卫生,这类合作也是在补物理世界接触数据。

机器人数据比自动驾驶慢得多,车队能靠满街的车每天一起采,遥操作通常一人一次只教一台,真机自主采更慢,失败还会磨损硬件、打断产线、带来安全风险,所以这事才这么难,但我还是挺看好这个方向。
机器人公司之间的差距,会慢慢体现在样本、训练和硬件改动的速度上,谁能更便宜、更稳定地采到失败样本,再把它们带进下一轮训练和硬件改动,谁的能力迭代就拉得更开。
数据是一道坎,量产是另一道。
Tesla 每次财报电话会都会聊不少 Optimus,作为投资人,我一般会把他们讲的和当前真做到的分开辩证看,把 2024 到 2026 年的连续口径连起来,能看出一些持续的变化,也能看出每次难点在哪里。
| 公开口径 | 卡在哪里 |
|---|---|
| 先在 Tesla 工厂内部使用 | 工厂是任务场,也是数据场和安全边界 |
| 机器人尚未 design-locked | 硬件定型还在推进,模型迭代速度代表不了整机迭代速度 |
| 目标产线从 1,000 台/月到更高规模 | 难点在执行器、电池、线束、装配和质检良率 |
| 目标在规模化后把成本压到 2 万美元以下 | 这依赖全新供应链,软件降本只占一部分 |
| 稀土永磁体供应被点名影响 Optimus | 执行器会被材料和供应链约束 |
交付年份之外,上面这些约束更难绕开。人形机器人很难等模型训好再开产线,硬件、数据、制造通常一起推进。手部一改设计,前臂结构、线束、触觉传感器、控制器和供应链都要跟着动,执行器良率不稳,产能目标就会被最慢的零件给拖住。
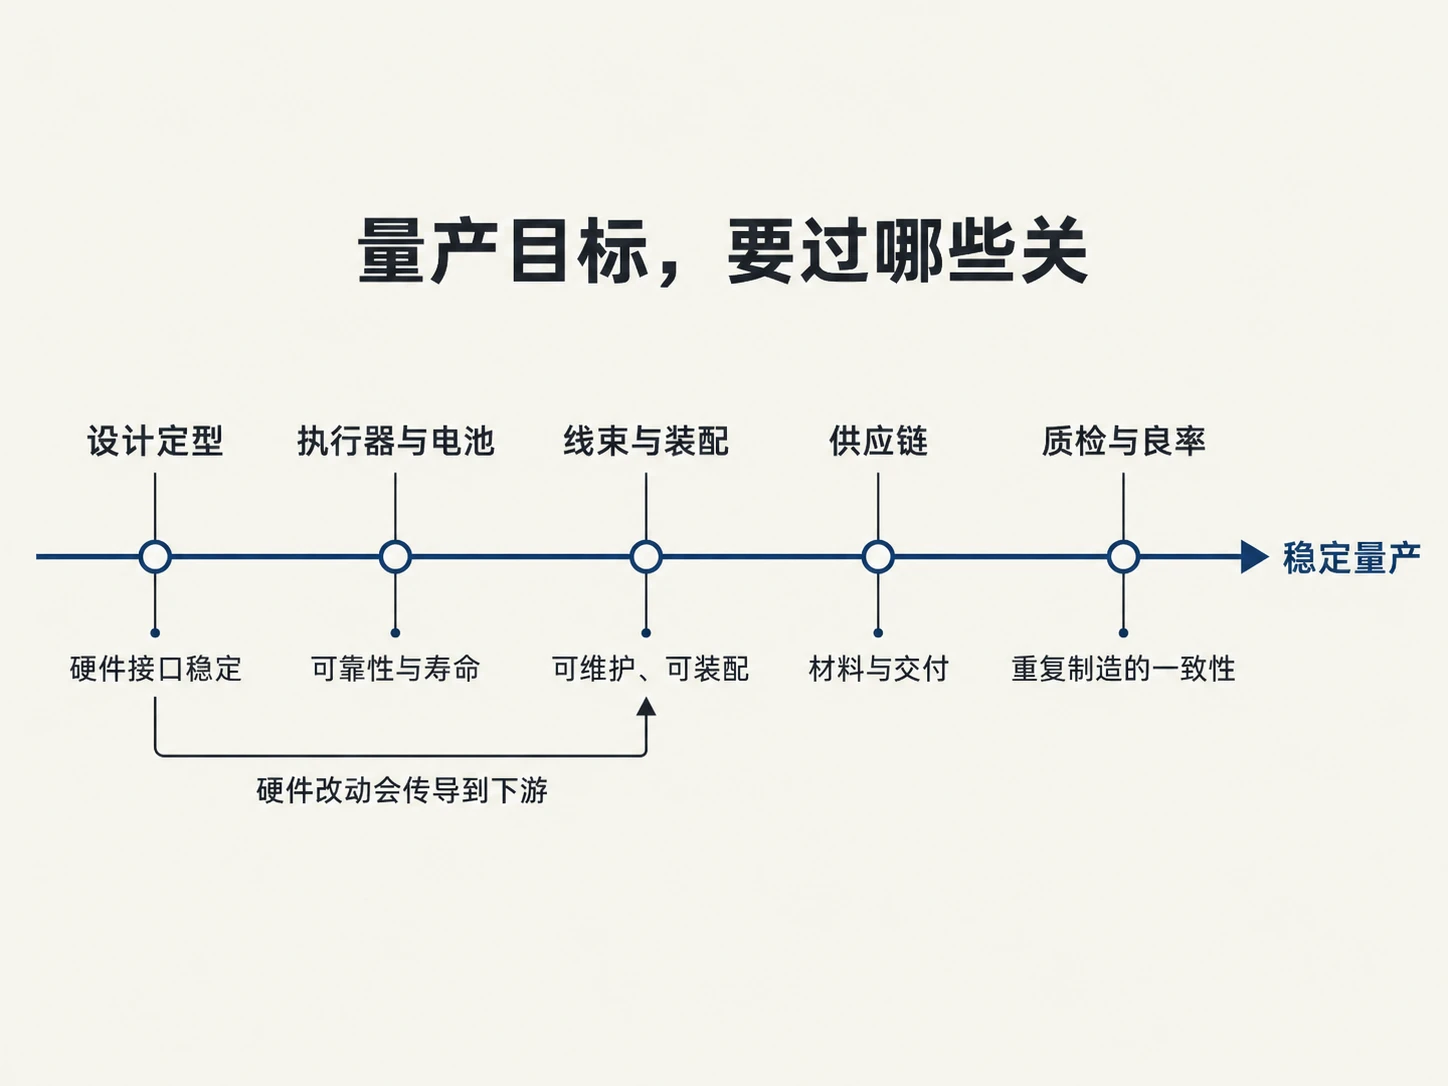
从公开资料看,Tesla 赌的是三件事的组合,真实场景数据、制造规模和垂直整合。FSD 给它视觉和训练基础设施,工厂给它受控任务和反馈,制造体系给它降本路径,但手部可靠性、执行器成本、安全保护和真实工位 ROI 只要有一项卡住,这些优势也很难落到产品上。
后续 Optimus 的验证点会集中在几件事上:手部结构的长期可靠性、失败样本回到训练和真机验证的速度、模型出错时能不能快速定位原因,以及产线目标背后的执行器与供应链支撑。Tesla 这套路线如果要真正跑通,得车队视觉经验、工厂任务、世界模拟器、训练集群和制造体系一起跟上。
现在做人形机器人的公司不少,路线和押的方向差别其实挺大。
| 玩家 | 路线 | 押的方向 | 观察点 |
|---|---|---|---|
| Tesla Optimus | 纯视觉、FSD 迁移、工厂试跑、自研执行器 | 失败样本和制造规模 | 手部、执行器成本、真实工位 ROI |
| Figure | Helix / Helix 02,全身 VLA 和工厂任务 | on-device VLA 和长程 loco-manipulation(边走边操作) | 演示外的稳定性、维护成本 |
| Google DeepMind | Gemini Robotics,高层 ER + 低层 VLA | 通用多步推理接机器人动作 | 伙伴硬件上的泛化和安全边界 |
| NVIDIA | Jetson Thor、Cosmos、Isaac、GR00T | 卖芯片、仿真、世界模型和基础模型工具链 | 生态是否能跨机器人稳定复用 |
| Boston Dynamics | 传统控制积累 + AI 增强 | 可靠运动控制和工业部署 | 成本、通用操作能力 |
| Unitree 宇树 | 高性价比硬件、运动能力、开发者市场 | 用低价格扩大硬件基数 | 软件生态和安全任务能力 |
| AGIBOT 智元 | 多形态产品、数据集、全栈平台 | 国内供应链和真实任务数据 | 公开可验证的任务覆盖和持续运行 |
这七家其实分两拨。一拨自己造整机,Tesla、Figure、宇树、智元都是从硬件到模型自己全包。另一拨不绑某一台机器人,Google DeepMind 做的是能接到不同本体上的智能层,NVIDIA 干脆把算力、仿真、世界模型和基础模型做成工具链卖给所有人。前一拨赌的是数据和制造能不能咬合,后一拨赌的是自己那层能不能跨机器人复用。

平台这条路听着省事,风险还是接口边界。上层指令太抽象下层接不住,下层失败说不清上层也没法重规划,跟前面 VLA 那章讲的问题很像。
其实也不是只有 VLA 一条路。Boston Dynamics 没有去蹭大模型叙事,靠电动 Atlas 和扎实的运动控制照样进工厂物流。工业现场看的是节拍、故障率和安全认证,而非演示效果好不好看。国内这边信号最实在的是价格和供应链速度,宇树 G1 官方起价 1.35 万美元,硬件基数能很快铺开,能不能做通用任务、能不能长期稳定还得持续来看。我那台小机器狗就停在最基础的固定动作层,这些路线对它来说都还太远。
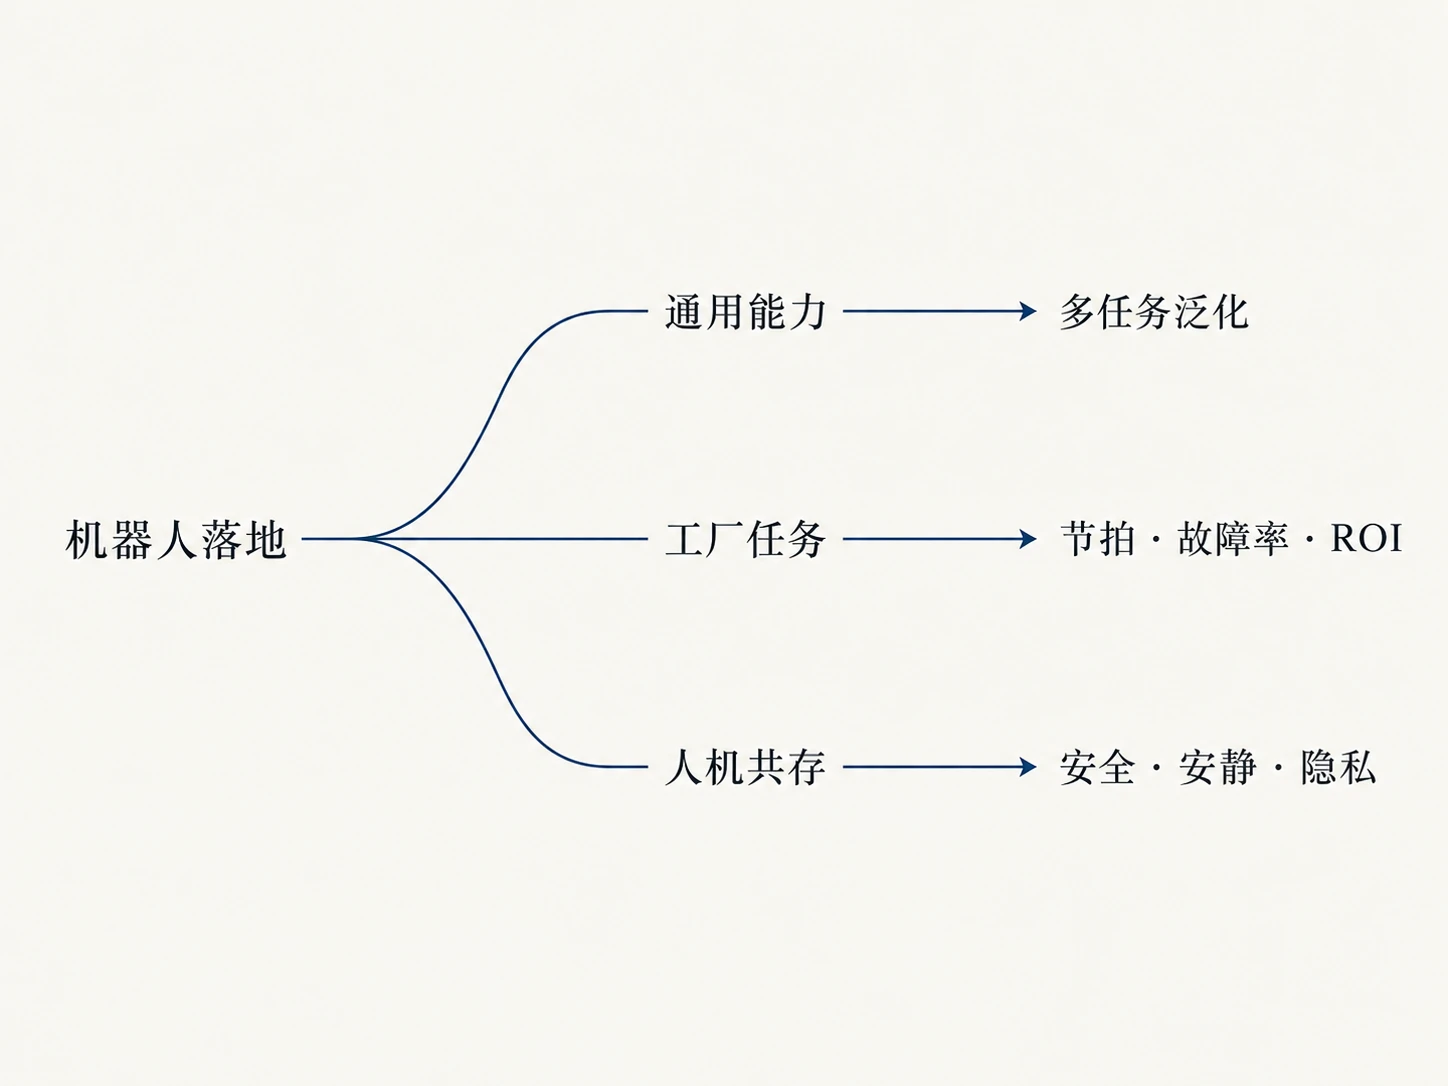
这些路线背后是三种取舍。工厂场景普遍被当成第一站,因为环境可控、ROI 算得清、任务边界能限定。家庭场景最难,环境乱、用户容错低,还得做到安静、安全、隐私可控。平台公司则选择先卖工具链,因为大多数机器人公司本身就缺数据、仿真、边缘算力和训练框架。
如果你也是偏软件的工程师,想继续往下看具身智能,下面这些系统层知识绕不开。
放到一张图里,它是从芯片、执行器、传感器一路往上到算法和系统的一整个栈。单独看模型,很多问题根本看不出来;对着完整技术栈图看,每一块大概在哪一层会清楚很多。
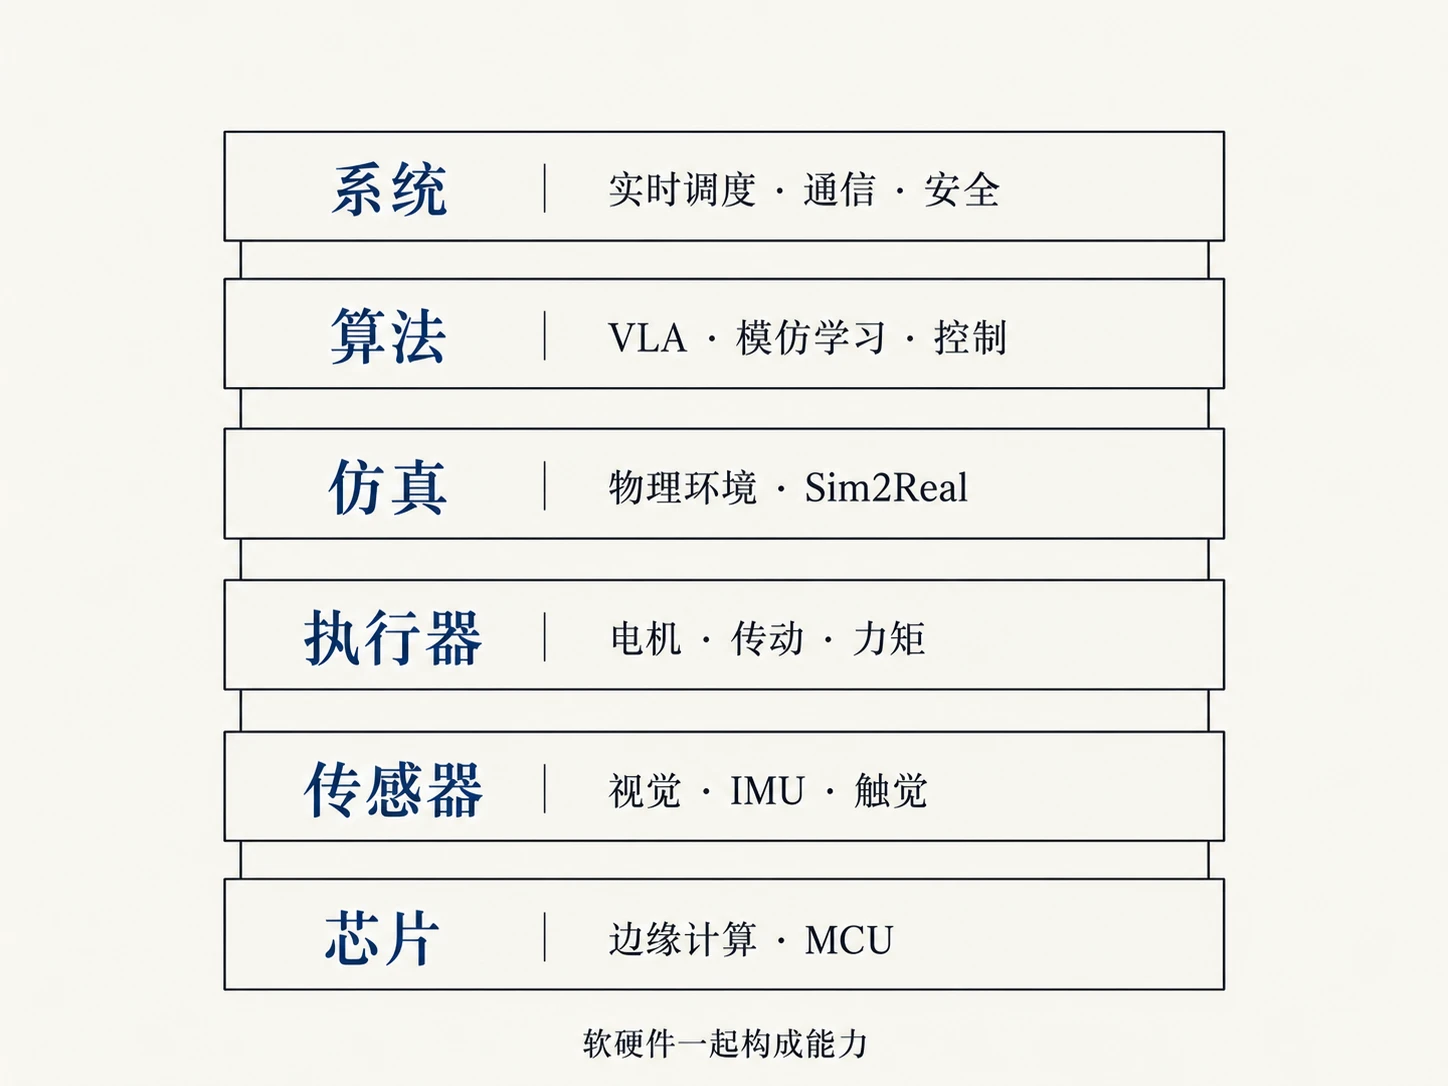
资料串起来大概是这个顺序。先从小机器狗这类硬件项目入手,因为它们刚好能把「端云协同 + 本地动作」连起来。唤醒、联网、模型调用、能力描述、串口协议、动作执行、状态回传都能在一个小系统里遇到。项目不大,但每个环节都可能真实失败,一个个解决的过程,反而最有探索感。
端云协同和 MCP 跑过一遍后,再看 ACT / ALOHA,会更容易理解低成本遥操作和 action chunking;接着看 Diffusion Policy,动作为什么要建模成分布会更清楚;再到 RT-1、RT-2、Open X-Embodiment、OpenVLA 这条线,VLA 和跨具身数据就能接上;最后看 π0、π0.5、SmolVLA、Gemini Robotics、Helix、GR00T N1.5,产业界怎么把高层推理、低层动作和边缘部署拼到一起,也会落到更具体的问题上。
要我说具身智能的重点,就「感知、空间、动作、力矩」这四个词,大致也是难度从轻到重。感知 AI 已经够强,空间还在补课,动作刚学会一点,到力矩这一层,就要面对电机、结构、接触和供电这些实打实难做的东西。AI 越靠近物理世界,能靠模型解决的部分越少,剩下的更多是硬件的事。
模型与算法
产业、硬件与工具链
想接着看 AI 工程这一类,我之前几篇 X 长文可以按这个顺序读:
初稿完成于 2026 年 5 月,6 月也在持续修订中,具身智能领域变化很快,部分数字和产品进展可能继续变化,发现错误欢迎指出。


