2026-10-12 11:49:06
由于工作原因,我突然接手了一个比较大的项目。
背景文档缺失严重,交接时拿到的主要就是一份代码。项目做什么、各个模块怎么配合、本地如何启动,都需要自己摸索。也没有可以随时请教的人。
虽然有开发经验,但面对陌生业务和一整个代码库,我还是有些焦虑。打开目录,每个文件似乎都能看懂一点,却很难把它们连起来。
于是,我开始尝试让 AI 帮我接手这个项目。
回头看,这个过程可以整理成五个阶段:
建立系统地图 → 跑通核心链路 → 验证自己的理解 → 建立交付保障 → 完成真实需求。
下面按我的五天经历展开。
刚开始,我最想解决的问题是:这个项目到底在做什么?
于是,我先让 AI 梳理五件事:
这里,“业务边界”尤其值得问。页面上出现某个功能,并不代表它已经完整实现。接手时需要分清:哪些流程已经能运行,哪些只有部分代码,哪些只是产品设想。
我的提示词类似这样:
请在不修改代码的情况下,帮我建立一份项目地图。
说明项目用途、主要用户、现有功能、技术栈、运行服务、目录职责和数据流向。
每个结论都给出对应的文件依据。区分已经实现的功能与尚未完成的功能;不确定的地方单独列出。
要求 AI 给出依据,是这一阶段很重要的一步。
如果它说系统使用了任务队列,我就可以继续问:任务在哪里创建?由哪个进程消费?失败后怎样处理?这样才能把架构图上的方框与实际代码联系起来。
接着,是搭建本地开发环境。
这个项目包含 Go 后端、Next.js 前端和 PostgreSQL 等组件。仅仅安装依赖还不够,环境变量、认证配置和数据库初始化都会影响启动。
我就遇到了这样的错误:
invalid admin authentication configuration
其实,拿到一串启动命令,不代表已经知道怎样运行项目。
后来,我要求 AI 按下面的方式指导:
请一步一步带我搭建本地开发环境。
每一步说明三个内容:为什么要做、如何操作、怎样确认成功。
如果失败,告诉我应该检查什么。先跑通必要服务,再接入外部依赖。
第一天结束时,我希望得到的是一张能继续使用的地图:知道系统由哪些部分组成,也知道本地启动需要哪些条件。
有了项目地图,接下来仍然有一个问题:今天应该先做什么?
可以学的东西太多了。前端、后端、数据库、任务队列、数据源,每一项都值得深入。但如果目标只是“熟悉整个项目”,到了晚上也很难判断自己到底完成了多少。
这时,我用了 grill-me 这个 skill。
它的作用是通过连续追问,把模糊的计划拆成明确的选择。我当时问的是:
为了快速接手这个项目,你建议我今天应该做些什么?请先追问我的目标、可用时间和当前条件,再帮我制定计划。
这轮沟通中,有一个变化很有代表性。
AI 最初建议用四小时跑通完整的数据处理流程。我告诉它,我只有两小时。
随后检查又发现,本地的外部采集器没有启用。于是,我们把范围缩小到:手工录入一条测试数据,完成审核、发布和前端展示。
这个目标具体多了,也更容易验证。
完成标准包括:我能找到每一步对应的页面、API、后端模块和数据库表,并解释数据为什么会出现在那里。
这里的 MVP 是一个帮助理解系统的小模型。业务范围和数据量都缩小,只保留需要学习的关键机制。
这样做之后,我可以更清楚地观察:
原项目的复杂度很容易遮住这些基础关系。小模型则让我有机会亲手把它们连接起来,再回头对照原项目。
这一阶段也可以让 AI 帮忙:
请根据现有架构,设计一个用于学习的小型 MVP。
只保留理解核心机制所必需的组件。说明每个组件对应原项目的哪一部分,以及哪些能力被省略了。
“省略了什么”同样重要。例如,小 MVP 可能没有处理并发、重试和权限,这些仍然需要回到原项目继续学习。
我用来判断自己是否理解的标准也变了:能解释各部分存在的原因,能预测一次输入会得到什么结果,也能说出小模型的局限。
代码可以在本地运行之后,我开始梳理 GitHub 上的 CI/CD 流程。
这个项目部署在 AWS Lightsail 上,通过 Docker 运行。但知道服务器在哪里,还不足以掌握项目的交付方式。
我还需要弄清楚:
整个流程可以先理解为:
提交代码
 ↓
自动检查
 ↓
构建并发布镜像
 ↓
服务器部署
 ↓
运行验证
这一阶段,AI 帮我解释了 GitHub Actions、SSH、GitHub Secrets、镜像仓库和部署脚本之间的关系。
我发现,一个很有效的问题是:
请说明这一步在哪台机器上执行、读取什么配置、产生什么结果,以及失败后应该查看哪里。
因为本地电脑、GitHub Actions 的运行环境和 Lightsail 服务器是三个不同的执行位置。分清楚之后,原本难懂的配置就容易理解了。
接手项目也需要接手它的交付方式。只有知道修改如何经过检查、如何进入运行环境,后续开发才更有把握。
开始处理新需求之后,我发现另一个难点:产品描述往往很粗。
例如,“加一个用户验证弹窗,填写邮箱后才能访问”,听起来像一个界面需求,实际却留下了很多问题:
这是收集用户信息,还是建立登录系统?要保护整个网站,还是只保护部分功能?信息存在哪里?用户的数据是否需要相互隔离?
后来,需求又变成了社交账号登录,还要继续明确:不同登录渠道的身份是否合并,历史匿名数据如何处理,没有配置的渠道是否展示。
这些问题不先回答,代码很容易做到一半再改方向。
所以,我再次使用 grill-me,让 AI 帮我把需求细化成规则和验收标准。
可以这样提问:
请先检查现有流程,再追问这项需求中的歧义。
优先明确用户场景、访问范围、数据归属、异常处理和验收标准。需求明确后,再制定实现计划。
经过这次实践,我发现,AI 已经能根据一个比较模糊的需求,快速生成代码并编写测试。但要让这些代码可靠地进入生产环境,还需要建立一套明确的质量保障流程。
这次接手项目,我总结了三层检查:
此外,还可以每天使用 retro skill,让 AI 回顾当天的改动,找出重复逻辑、不必要的复杂度,以及可以精简或合并的代码。如果发现了问题,就把经验补充到项目规则或测试中,减少同类问题再次发生的机会。
2026-08-21 22:27:42
用过云端大模型的人,大概都撞过两堵墙:一是账单——哪怕用最便宜的 DeepSeek,持续调用也是一笔固定支出;二是隐私——有些资料、有些数据,你并不想让它走出自己的电脑。
于是问题自然浮现:能不能把大模型搬回本地,自己跑?
第一是成本。 上云再便宜,也是持续的支出;本地一次投入硬件,之后调用几乎零边际成本。
第二是安全。 本地的一些资料、内容,本来就不便公开分享。数据不出本机,就是最彻底的「不外传」。
第三是开放。 有些时候,我们想利用大语言模型没有围栏的那些特性,让它的输出尺度更宽、内容更开放。这一点,云端服务很难满足。
除此之外,从工程角度看,使用本地的模型既可以作为断网情况下的一种保障方案,也可以在不改变工作流程的情况下,把本地模型作为一个测试开发环境。
本地跑大模型的第一个坎,是内存。
大模型最初是用 16 位浮点数训练的。一个 70 亿参数(7B)的 16 位模型,光是加载进内存,就要大约 14GB。
所以你在下载模型时,会看到 Q4_K_M、Q8_0 这样的标签——这就是量化。Q4 把权重压缩到 4 位,内存需求直接减半甚至更多。还是那个 7B 模型,它的 Q4_K_M 版本,只需要约 4.5GB 的 RAM。
量化通过牺牲部分精度,换取了将大模型部署在普通电脑上的可能。虽然模型在准确性上,和云上的所谓“满血版”相比,会稍有折扣,但在本地场景下完全具备实用价值。
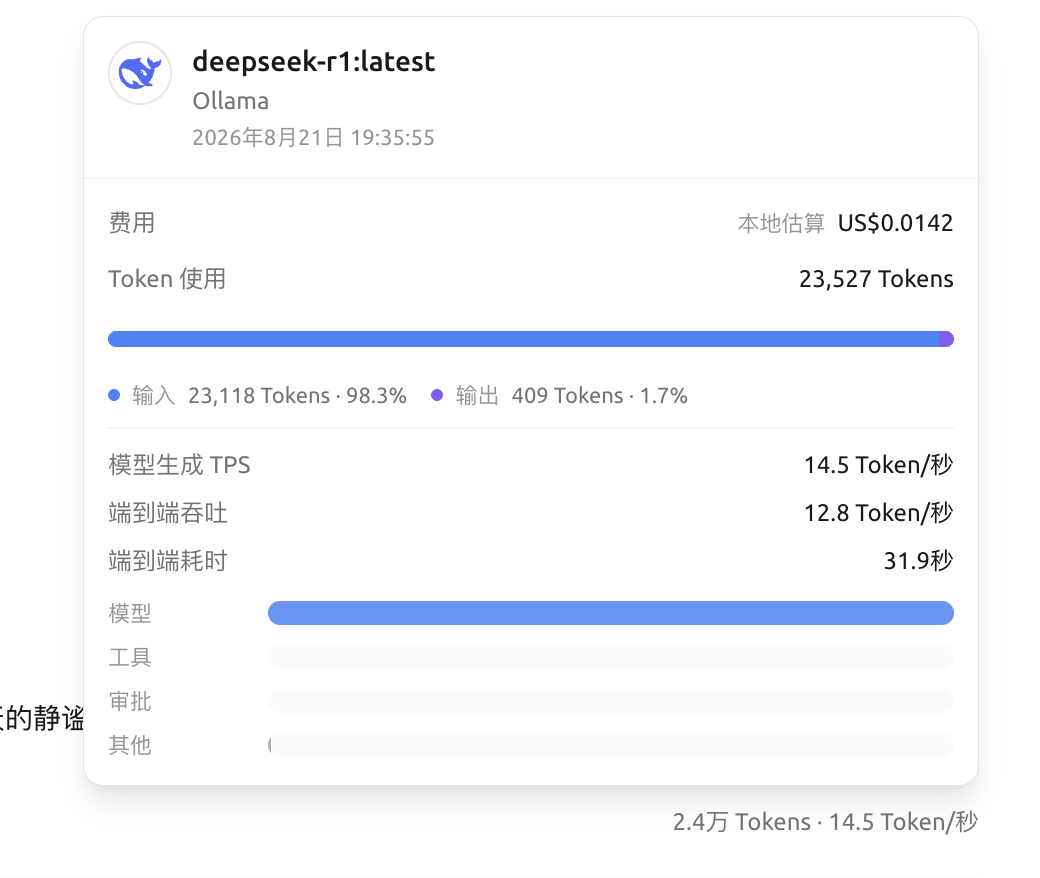
技术上的可行,不代表日常的可用。在本地开始使用某个大语言模型之前,建议先进行基准测试。在本地机器上运行以下脚本,若聊天模型的每秒词元数(Tokens/sec)低于 15,则建议更换更小的模型或更高的量化级别。运行该脚本后,将输出首个词元延迟(TTFT)、总词元数以及每秒词元数:
import time
from ollama import chat

PROMPT = "Write a Python class that implements a thread-safe LRU cache."

start = time.perf_counter()
token_count = 0

stream = chat(
 # model="qwen2.5-coder:7b",
 model="deepseek-r1:latest",
 messages=[{"role": "user", "content": PROMPT}],
 stream=True,
)

first_token_time = None

for chunk in stream:
 content = chunk["message"]["content"]
 if content:
 if first_token_time is None:
 first_token_time = time.perf_counter()
 token_count += 1
 print(content, end="", flush=True)

elapsed = time.perf_counter() - start
ttft = (first_token_time - start) if first_token_time else 0

print(f"\n\n--- Benchmark ---")
print(f"Time to first token : {ttft:.2f}s")
print(f"Total tokens : {token_count}")
print(f"Total time : {elapsed:.2f}s")
print(f"Tokens/sec : {token_count / elapsed:.1f}")
除了使用脚本的方式,还可以通过 Cherry Studio 加载本地模型,来查看模型的基准测试效果。
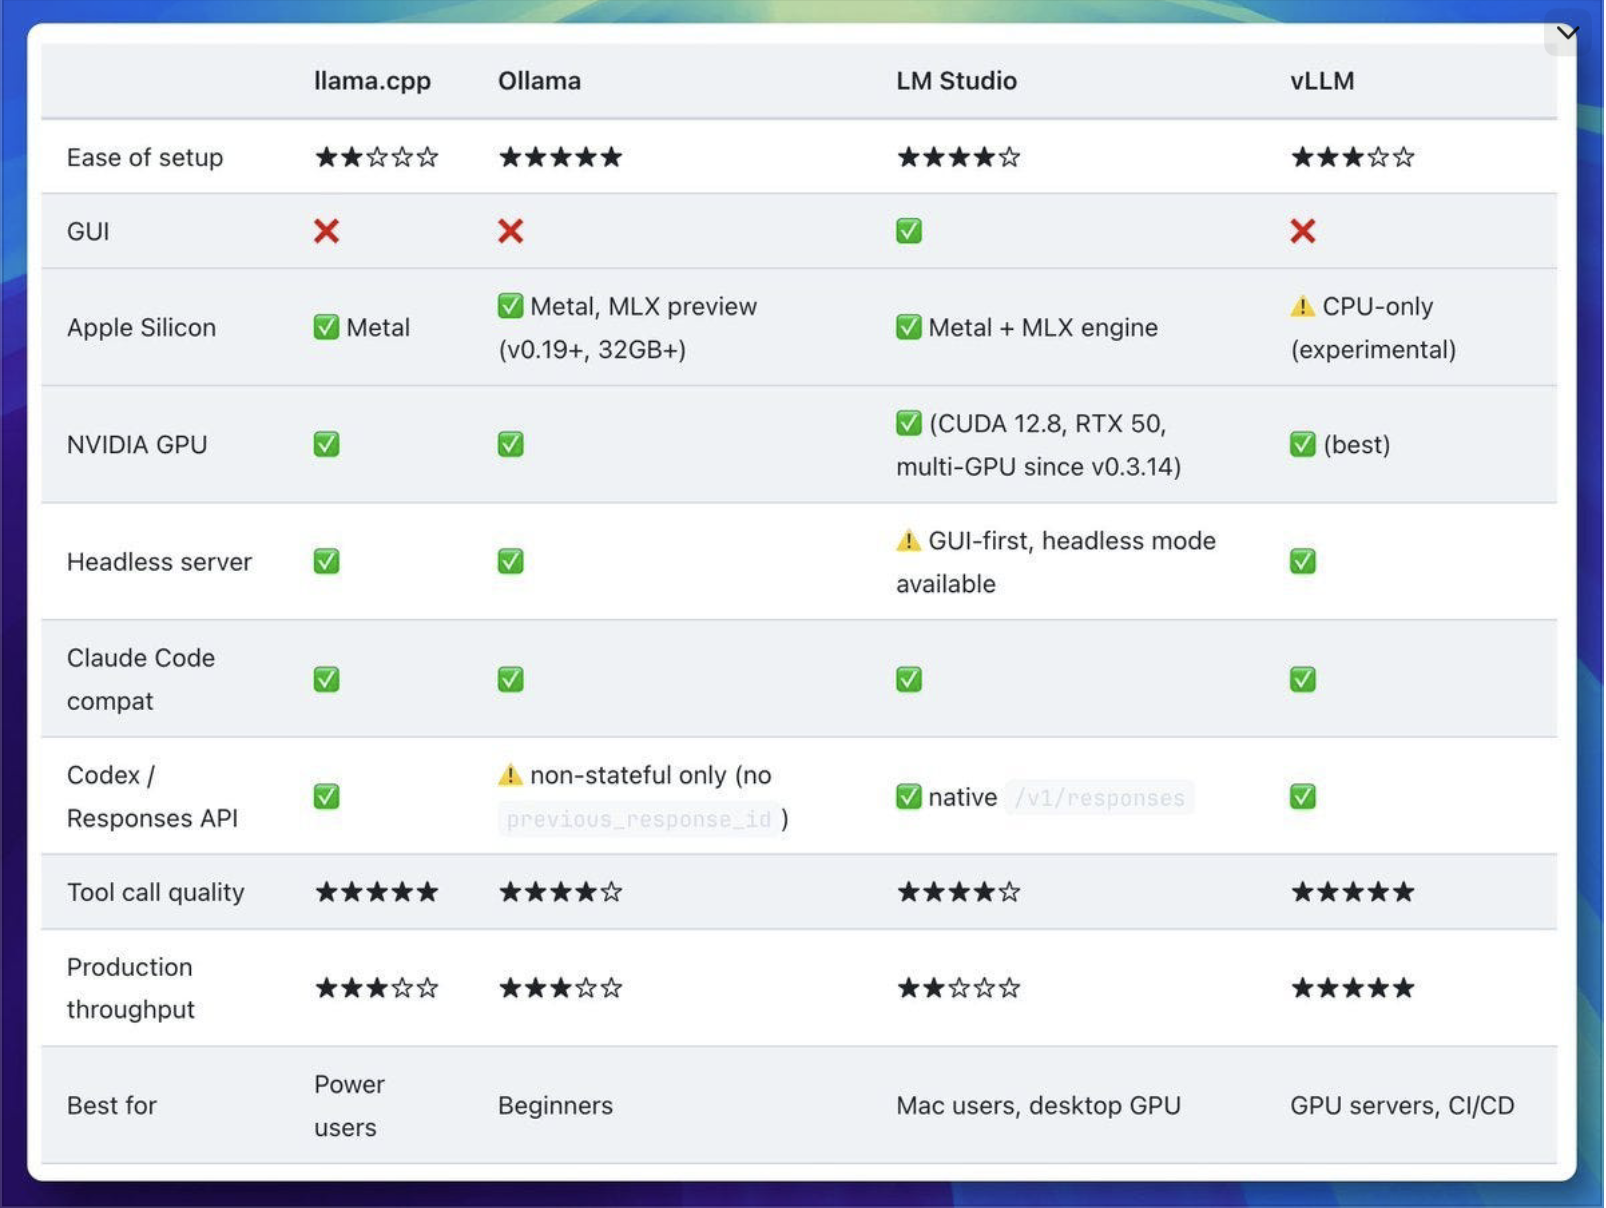
在众多推理工具中,LM Studio 和 Ollama 的底层引擎均基于 llama.cpp。
目前,Ollama 是大多数开发者的首选。它将复杂的推理引擎封装成一个简单的命令行工具。
Ollama 提供了与 OpenAI 兼容的 API 接口。这意味着,原本为云端模型编写的脚本或框架,只需更改 Base URL 即可直接无缝对接本地模型。
from openai import OpenAI

# Point the standard OpenAI client at your local Ollama instance
client = OpenAI(
 base_url="http://localhost:11434/v1/",
 api_key="ollama", # required by the SDK but not validated
)

response = client.chat.completions.create(
 model="qwen3-coder:30b",
 messages=[
 {"role": "user", "content": "Explain the difference between a mutex and a semaphore."},
 ],
)

print(response.choices[0].message.content)
此外,Ollama 也支持在命令行窗口中直接交互:
ollama run qwen2.5-coder:7b
ollama launch codex --model qwen2.5-coder:7b
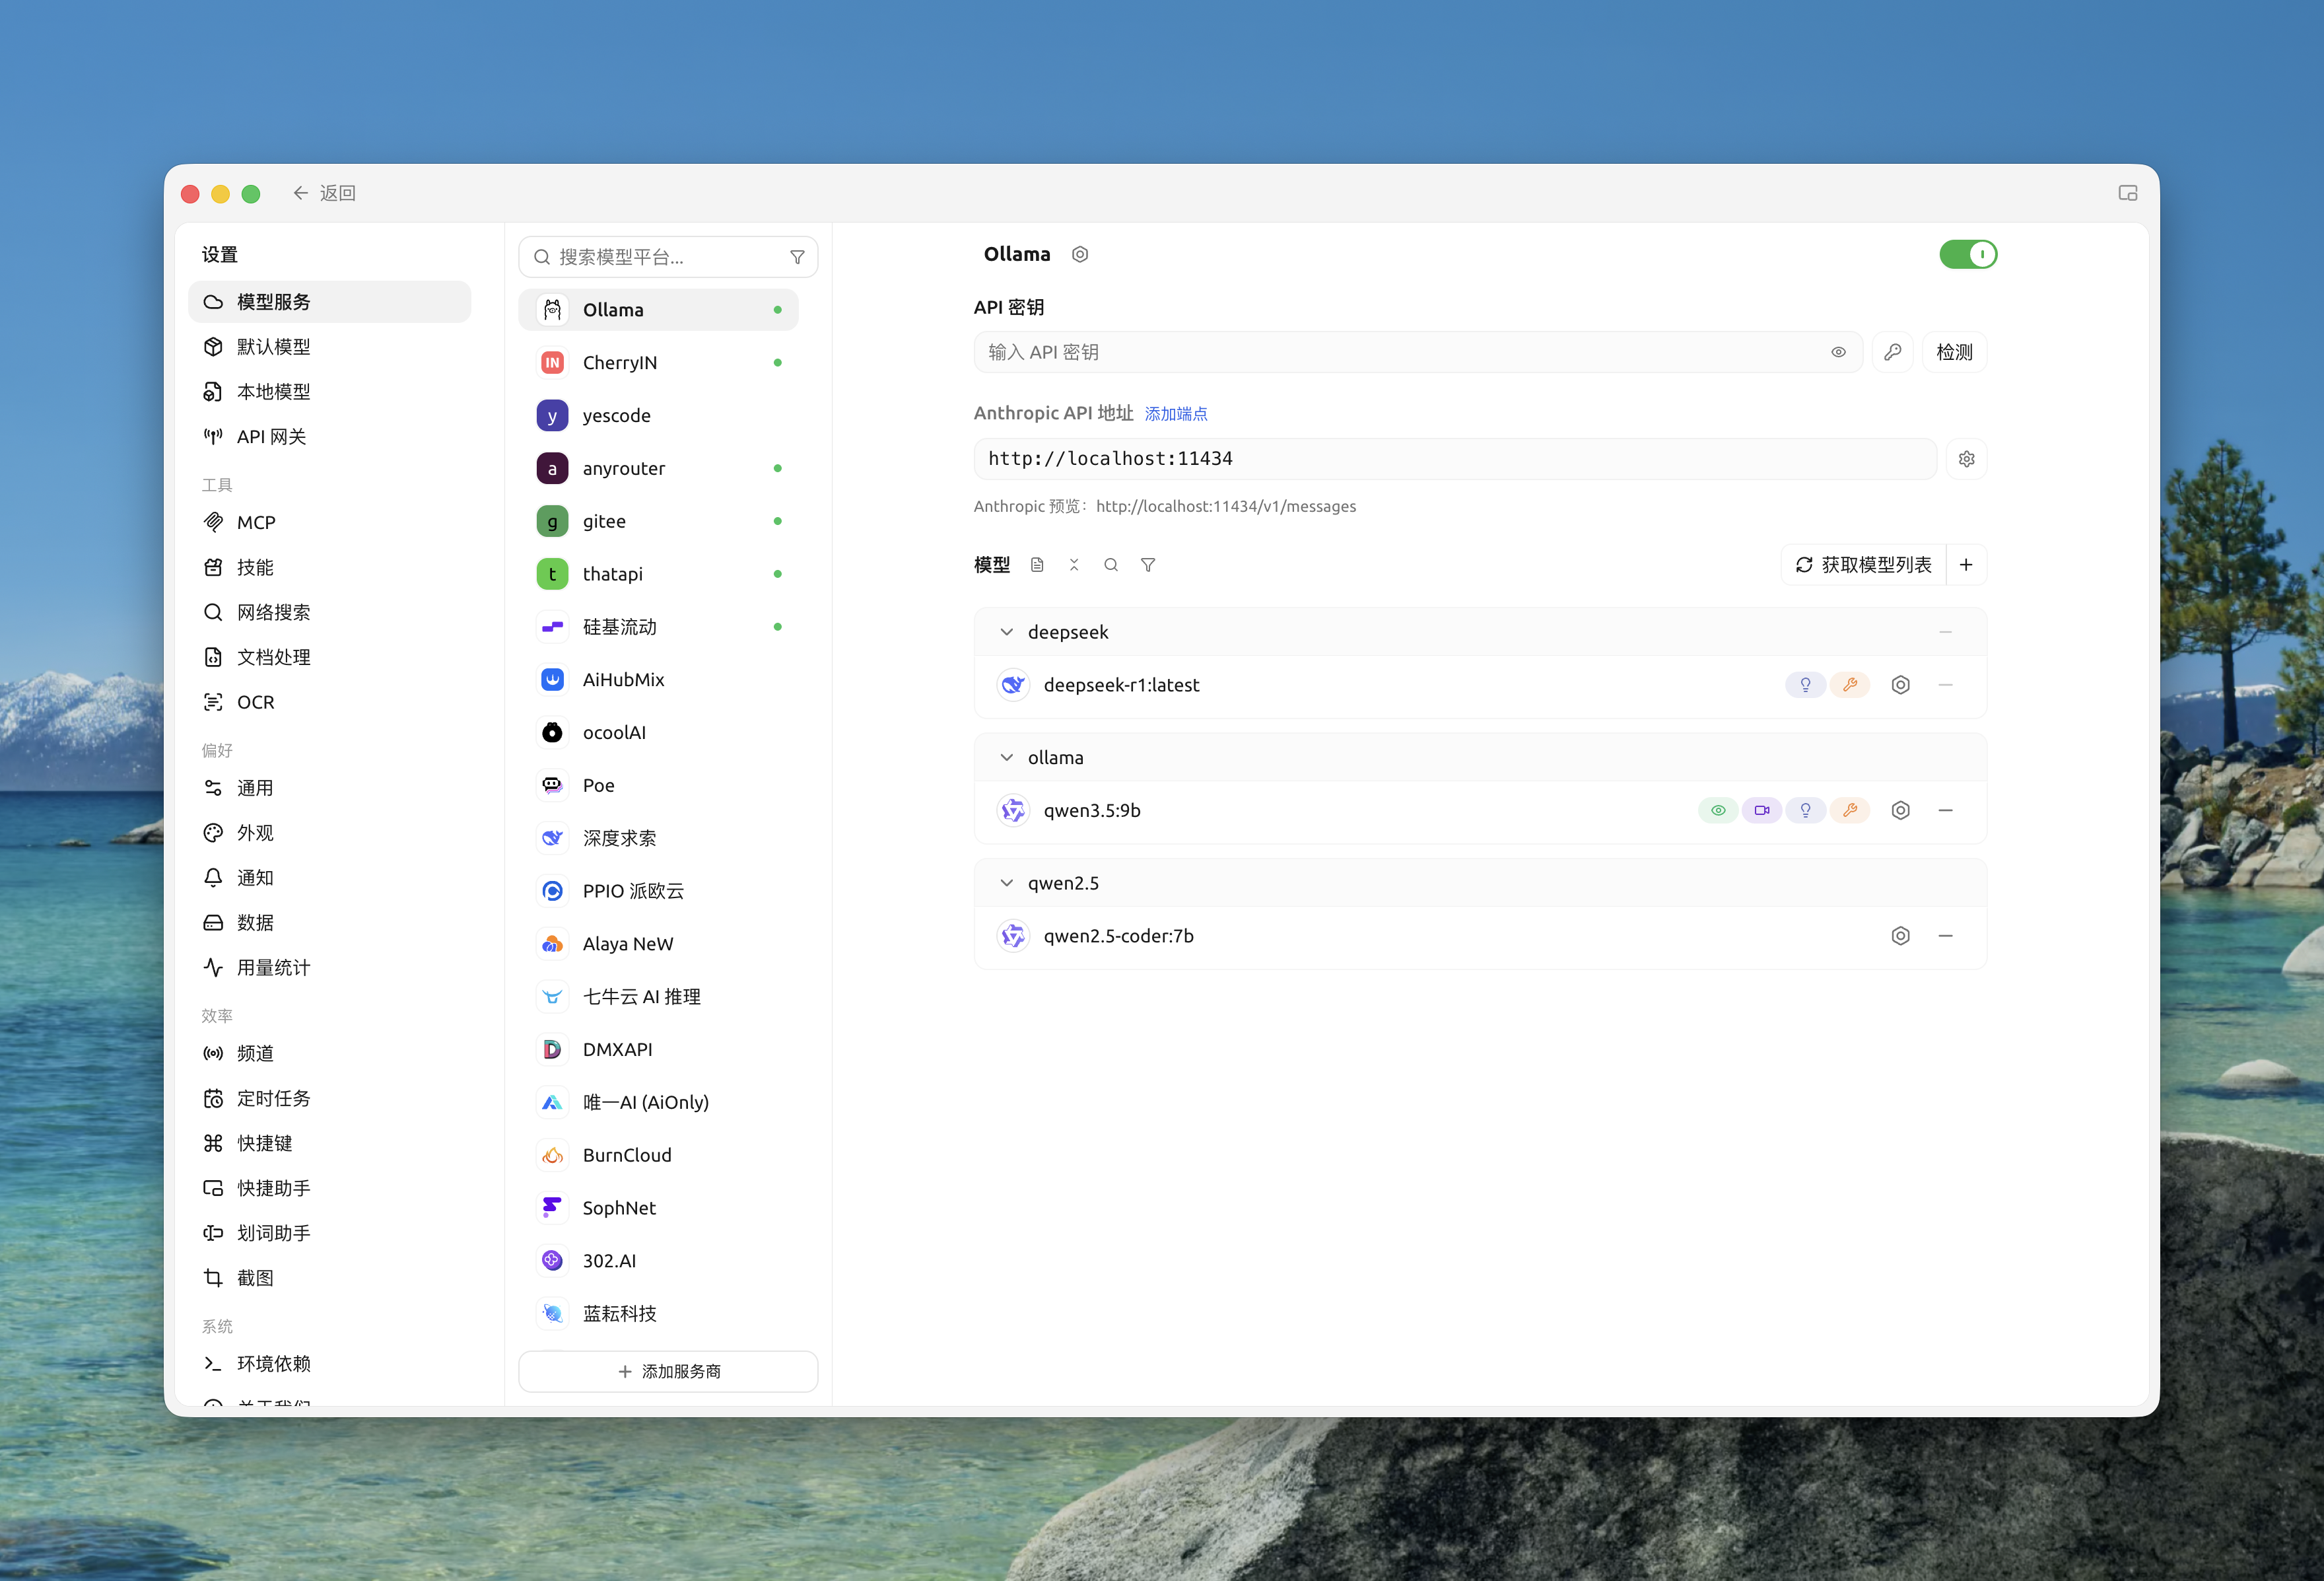
最后,Ollama还可以和图形化界面(Cherry Studio)结合使用。
通过Cherry Studio的模型服务,在 Ollama 配置页面添加对应的模型,即可实现直观的本地可视化交互与管理。
2026-08-07 14:57:11
传统的 LLM 只是一个文本语言模型,只能以 chat bot 的形式和我们进行对话。但是在日常工作生活中,浏览器是一个占据我们大多数时间的工具,如何让大语言模型也具备操作浏览器的能力呢?
最近我做了一个小实验:用 Agent + Playwright,让大模型自己打开网页、看懂页面结构、决定点哪个按钮,最终完整处理了一个客服工单。这篇文章把原理、落地过程整理出来。
从宏观上看,给 LLM 配置上工具、组成一个 Agent,就能实现与浏览器的交互。这个 Agent 不断执行「观察 + 执行」的循环:
Agent 接受任务和当前浏览器状态
根据任务分析当前状态,决定下一步操作
把操作交给工具执行
执行后浏览器产生新的状态,作为下一次循环的输入
循环一直持续,直到 Agent 认为任务完成。
为了使循环正常工作,我们需要在代理和浏览器之间建立两个连接:
| 方案 | 观察方式 | 操作方式 | 对 LLM 的要求 | token 消耗 |
|---|---|---|---|---|
| 方案一 | 屏幕截图 | 基于坐标的鼠标键盘操作 | 图像识别能力 | 高 |
| 方案二 | 结构化页面状态 | 元素定向操作 | 基本文本能力 | 低 |
方案一需要 LLM 具备图像识别能力,方案二只需要基础文本能力。本文聚焦方案二,选用的工具是 Playwright CLI——微软推出的命令行浏览器自动化工具,它把页面输出为结构化状态,token 使用更高效。
1.安装 playwright cli
npm install -g @playwright/cli@latest

playwright-cli --help
2.playwright cli 的使用
# 有头模式:可视化调试,便于观察页面自动化访问过程

playwright-cli open google.com --headed
有头浏览器,可视化的方式展示前端页面的自动化访问,便于调试。
默认为无头模式,不加 headed 参数即可,节省内存但看不到页面。在命令行里跑的时候建议用无头模式,减少干扰,运行更清爽。
3.持久化会话
playwright-cli open google.com --headed --persistent
Cookie 等信息会存储在本地,下次访问自动复用登录状态,适合需要登录的站点。
playwright cli 是微软推出的一个命令行工具,大模型并不知道如何使用,但是搭配上 skill 这个说明文档之后,大模型就可以立即掌握工具的所有用法。
方式一:安装 skill
playwright-cli install --skills
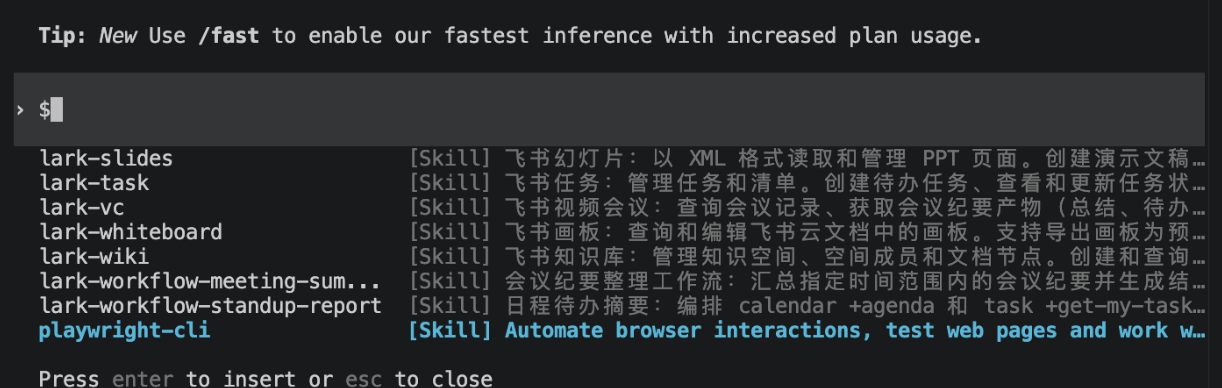
skill 会直接安装到当前项目的 .claude/skills/playwright-cli。如果要适配 Codex,只需把 .claude 改成 .codex,在 Codex 命令行下输入 /skill 即可验证。
方式二:挂载 MCP
另一种方式是把 Playwright 以 MCP 的形式挂进大模型的工具列表。注意这里用的是官方独立的 @playwright/mcp 包,和上面的 skill CLI 是两条路径:CLI 是给工具配说明书,MCP 是直接把工具接进 Agent 的工具箱。下面的实战场景 2 用的就是 MCP 方式。
这是我本地启动的一个网页前端,我让 LLM 帮我实现更改标题颜色。
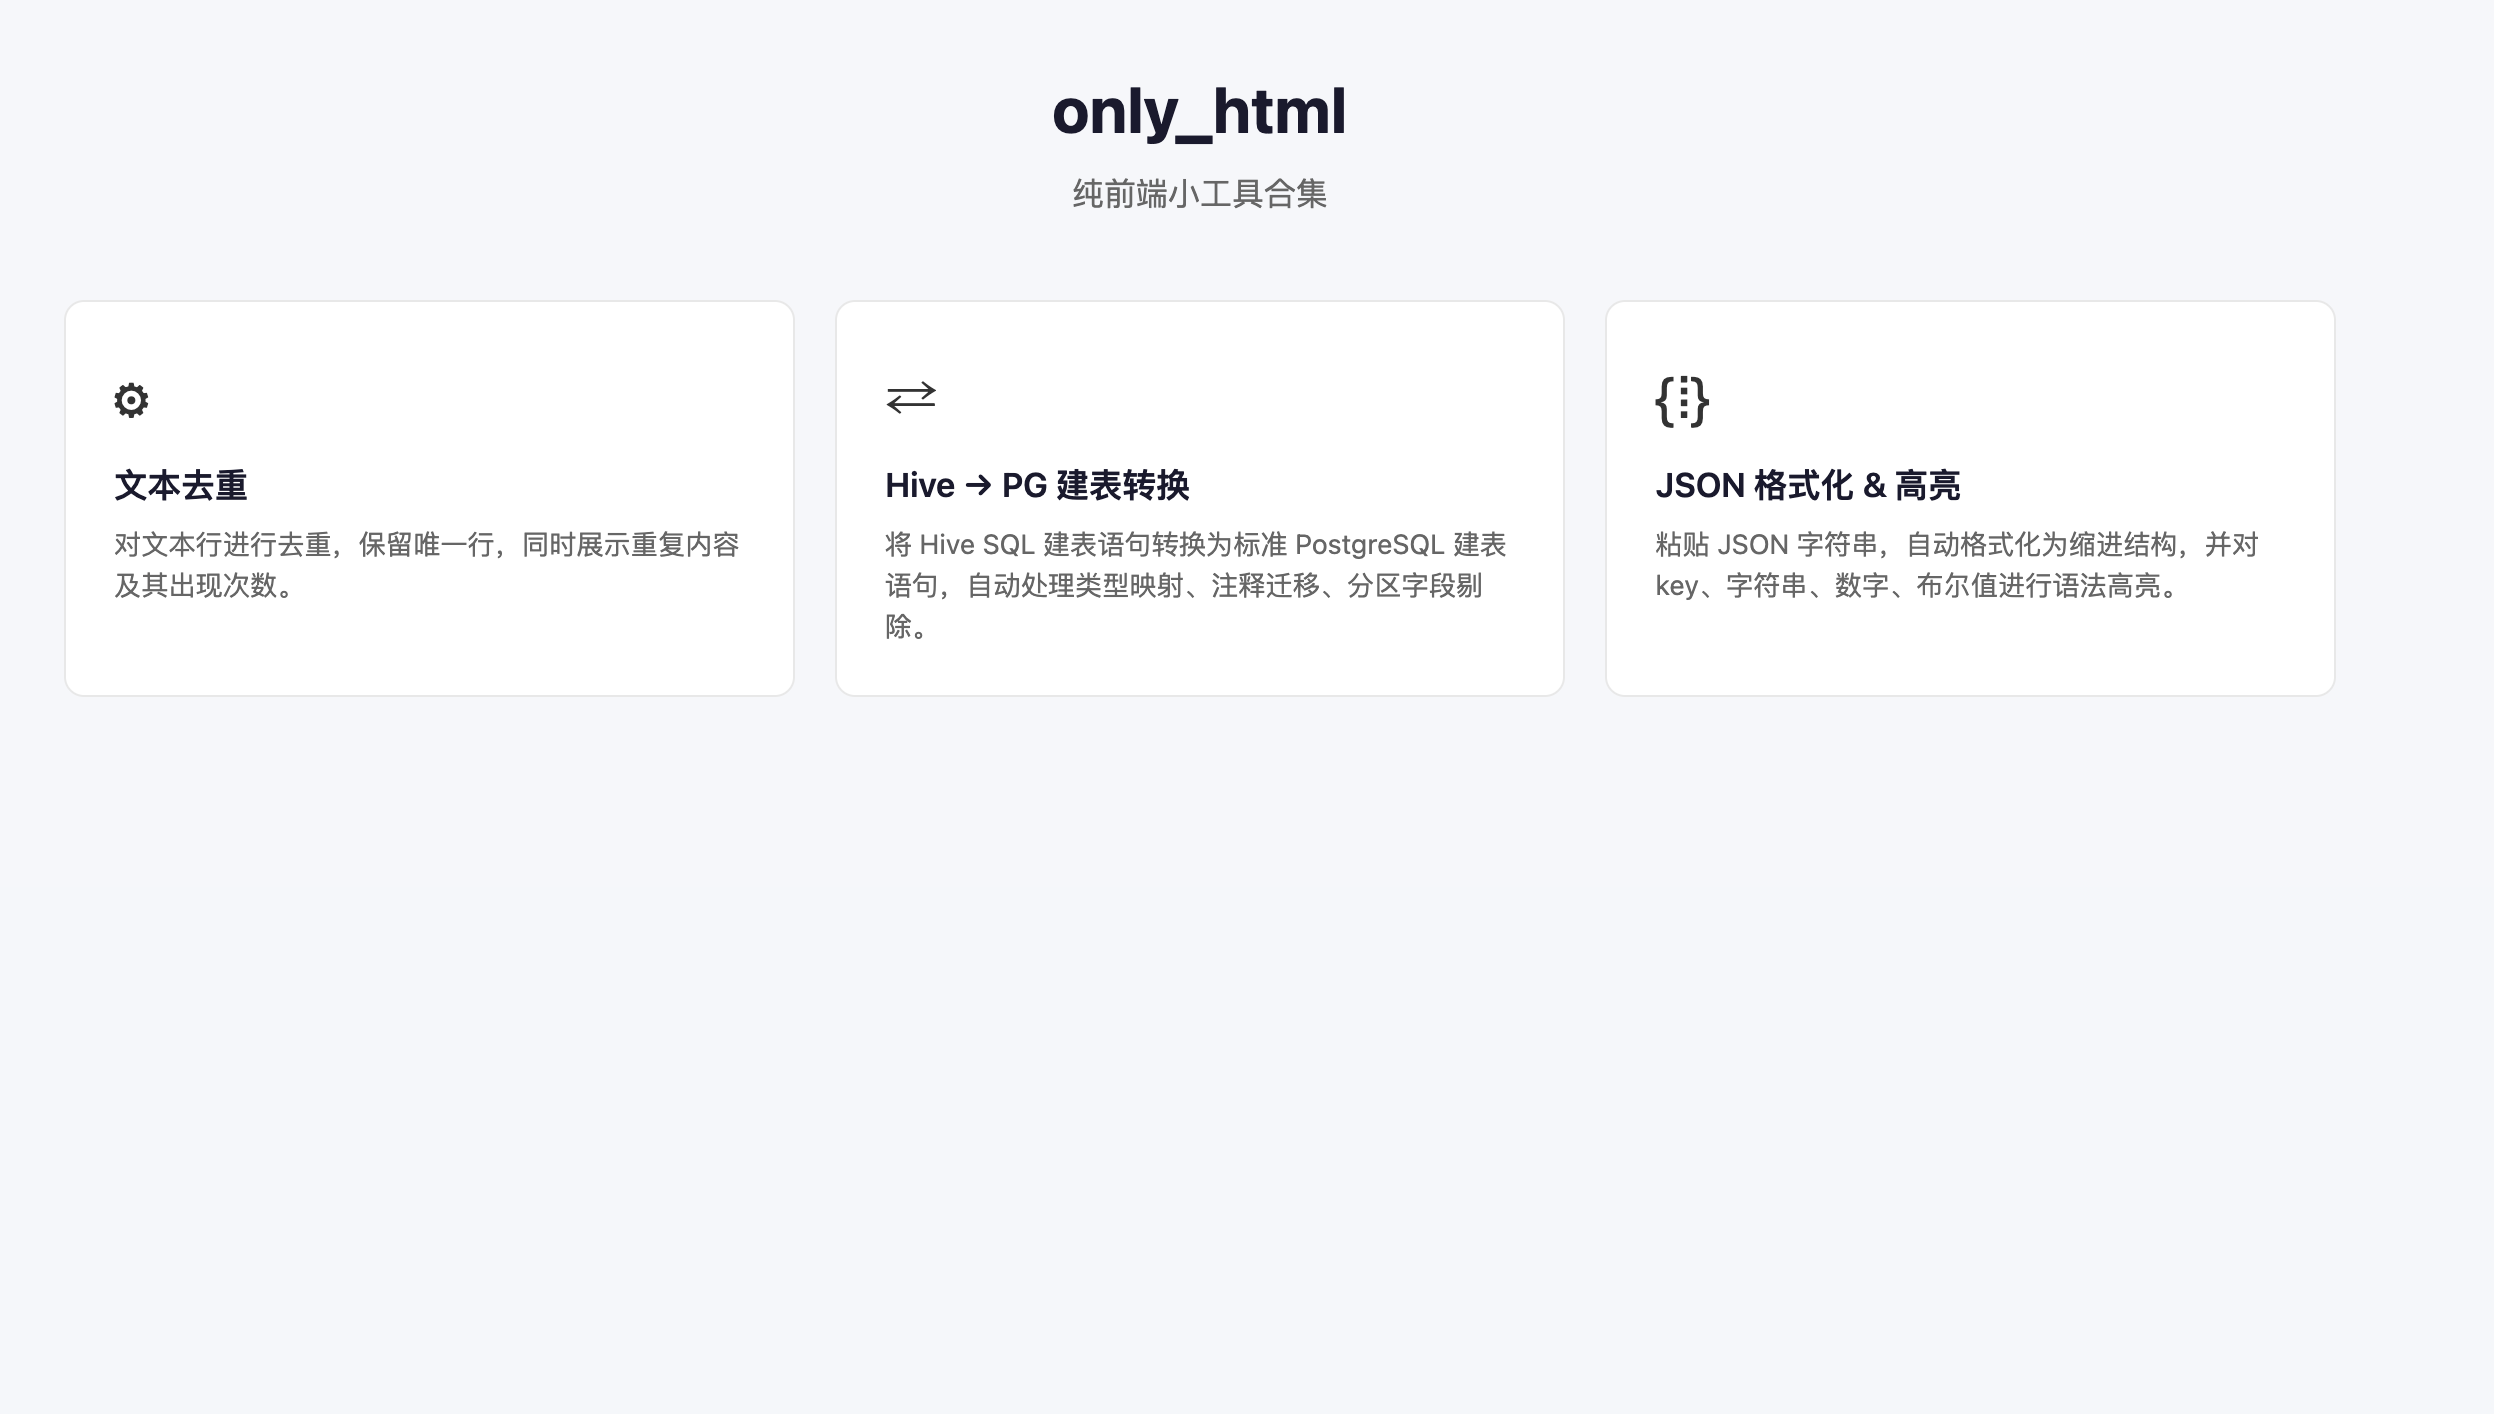
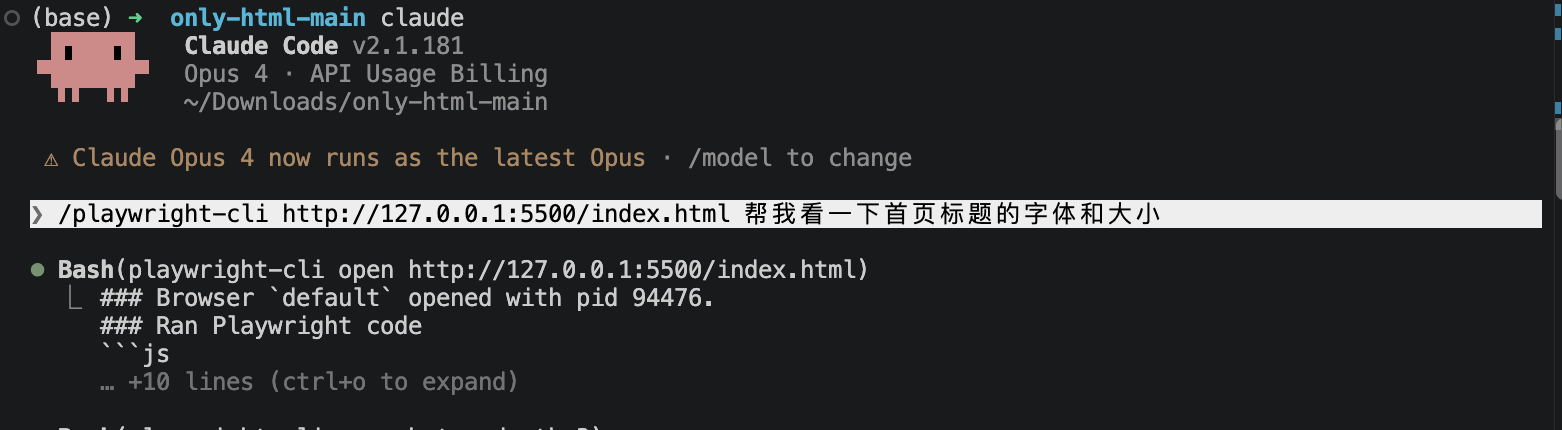
先校验大模型能否看到网页内容——这是观察通道是否打通的第一关:
确认可见之后,下达修改指令:让大模型帮我更改标题的颜色。
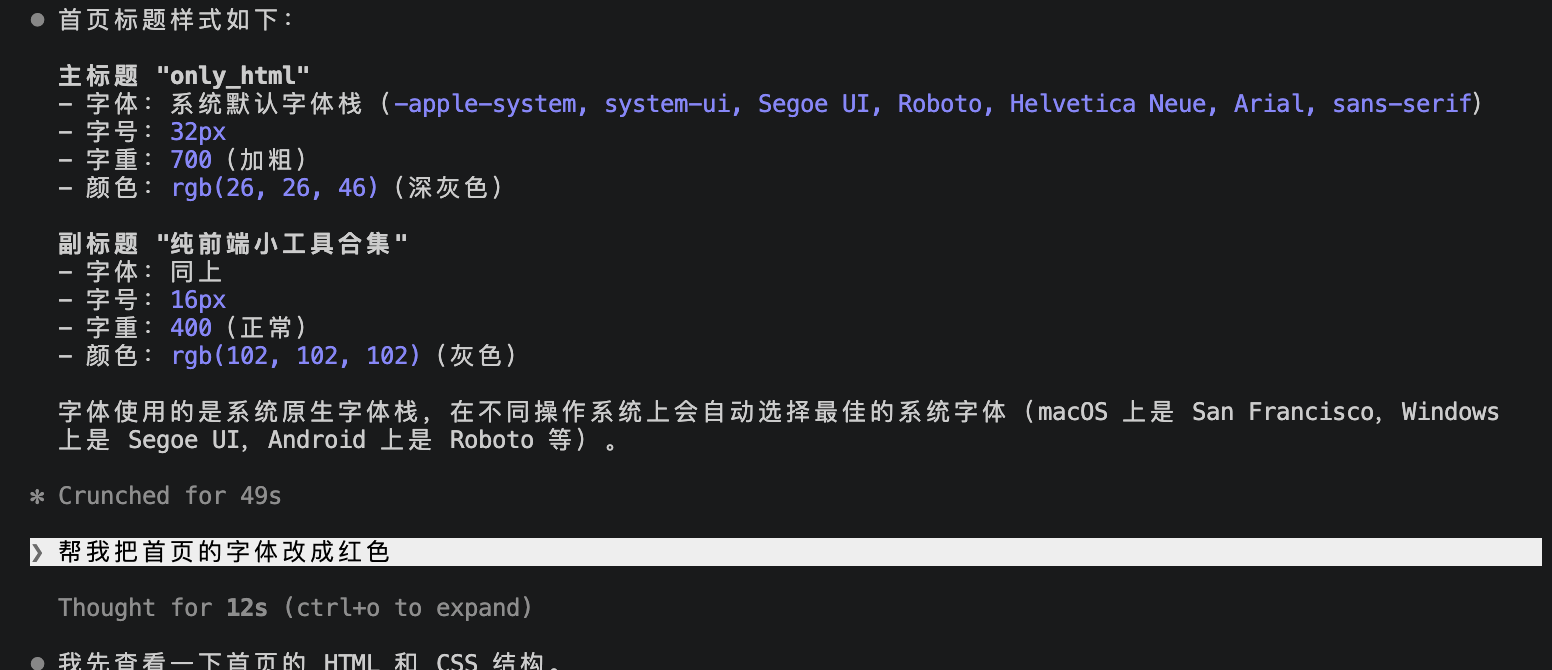
改完后刷新页面确认标题颜色已生效,「观察 → 执行 → 验证」的闭环就完整了。

通过 Playwright MCP 操控 Chrome 浏览器,打开本地客服控制台,自主完成以下任务:
ORD-1048(客户投诉收到了错误的商品)关键点:Agent 收到的只是业务目标(“解决 ORD-1042 工单”),不包含任何操作步骤。它需要自己看页面结构、理解内容、决定点哪个按钮——这是 LLM Agent 和传统自动化脚本的本质区别。
前端的客服控制台是一个简单的 html 页面。
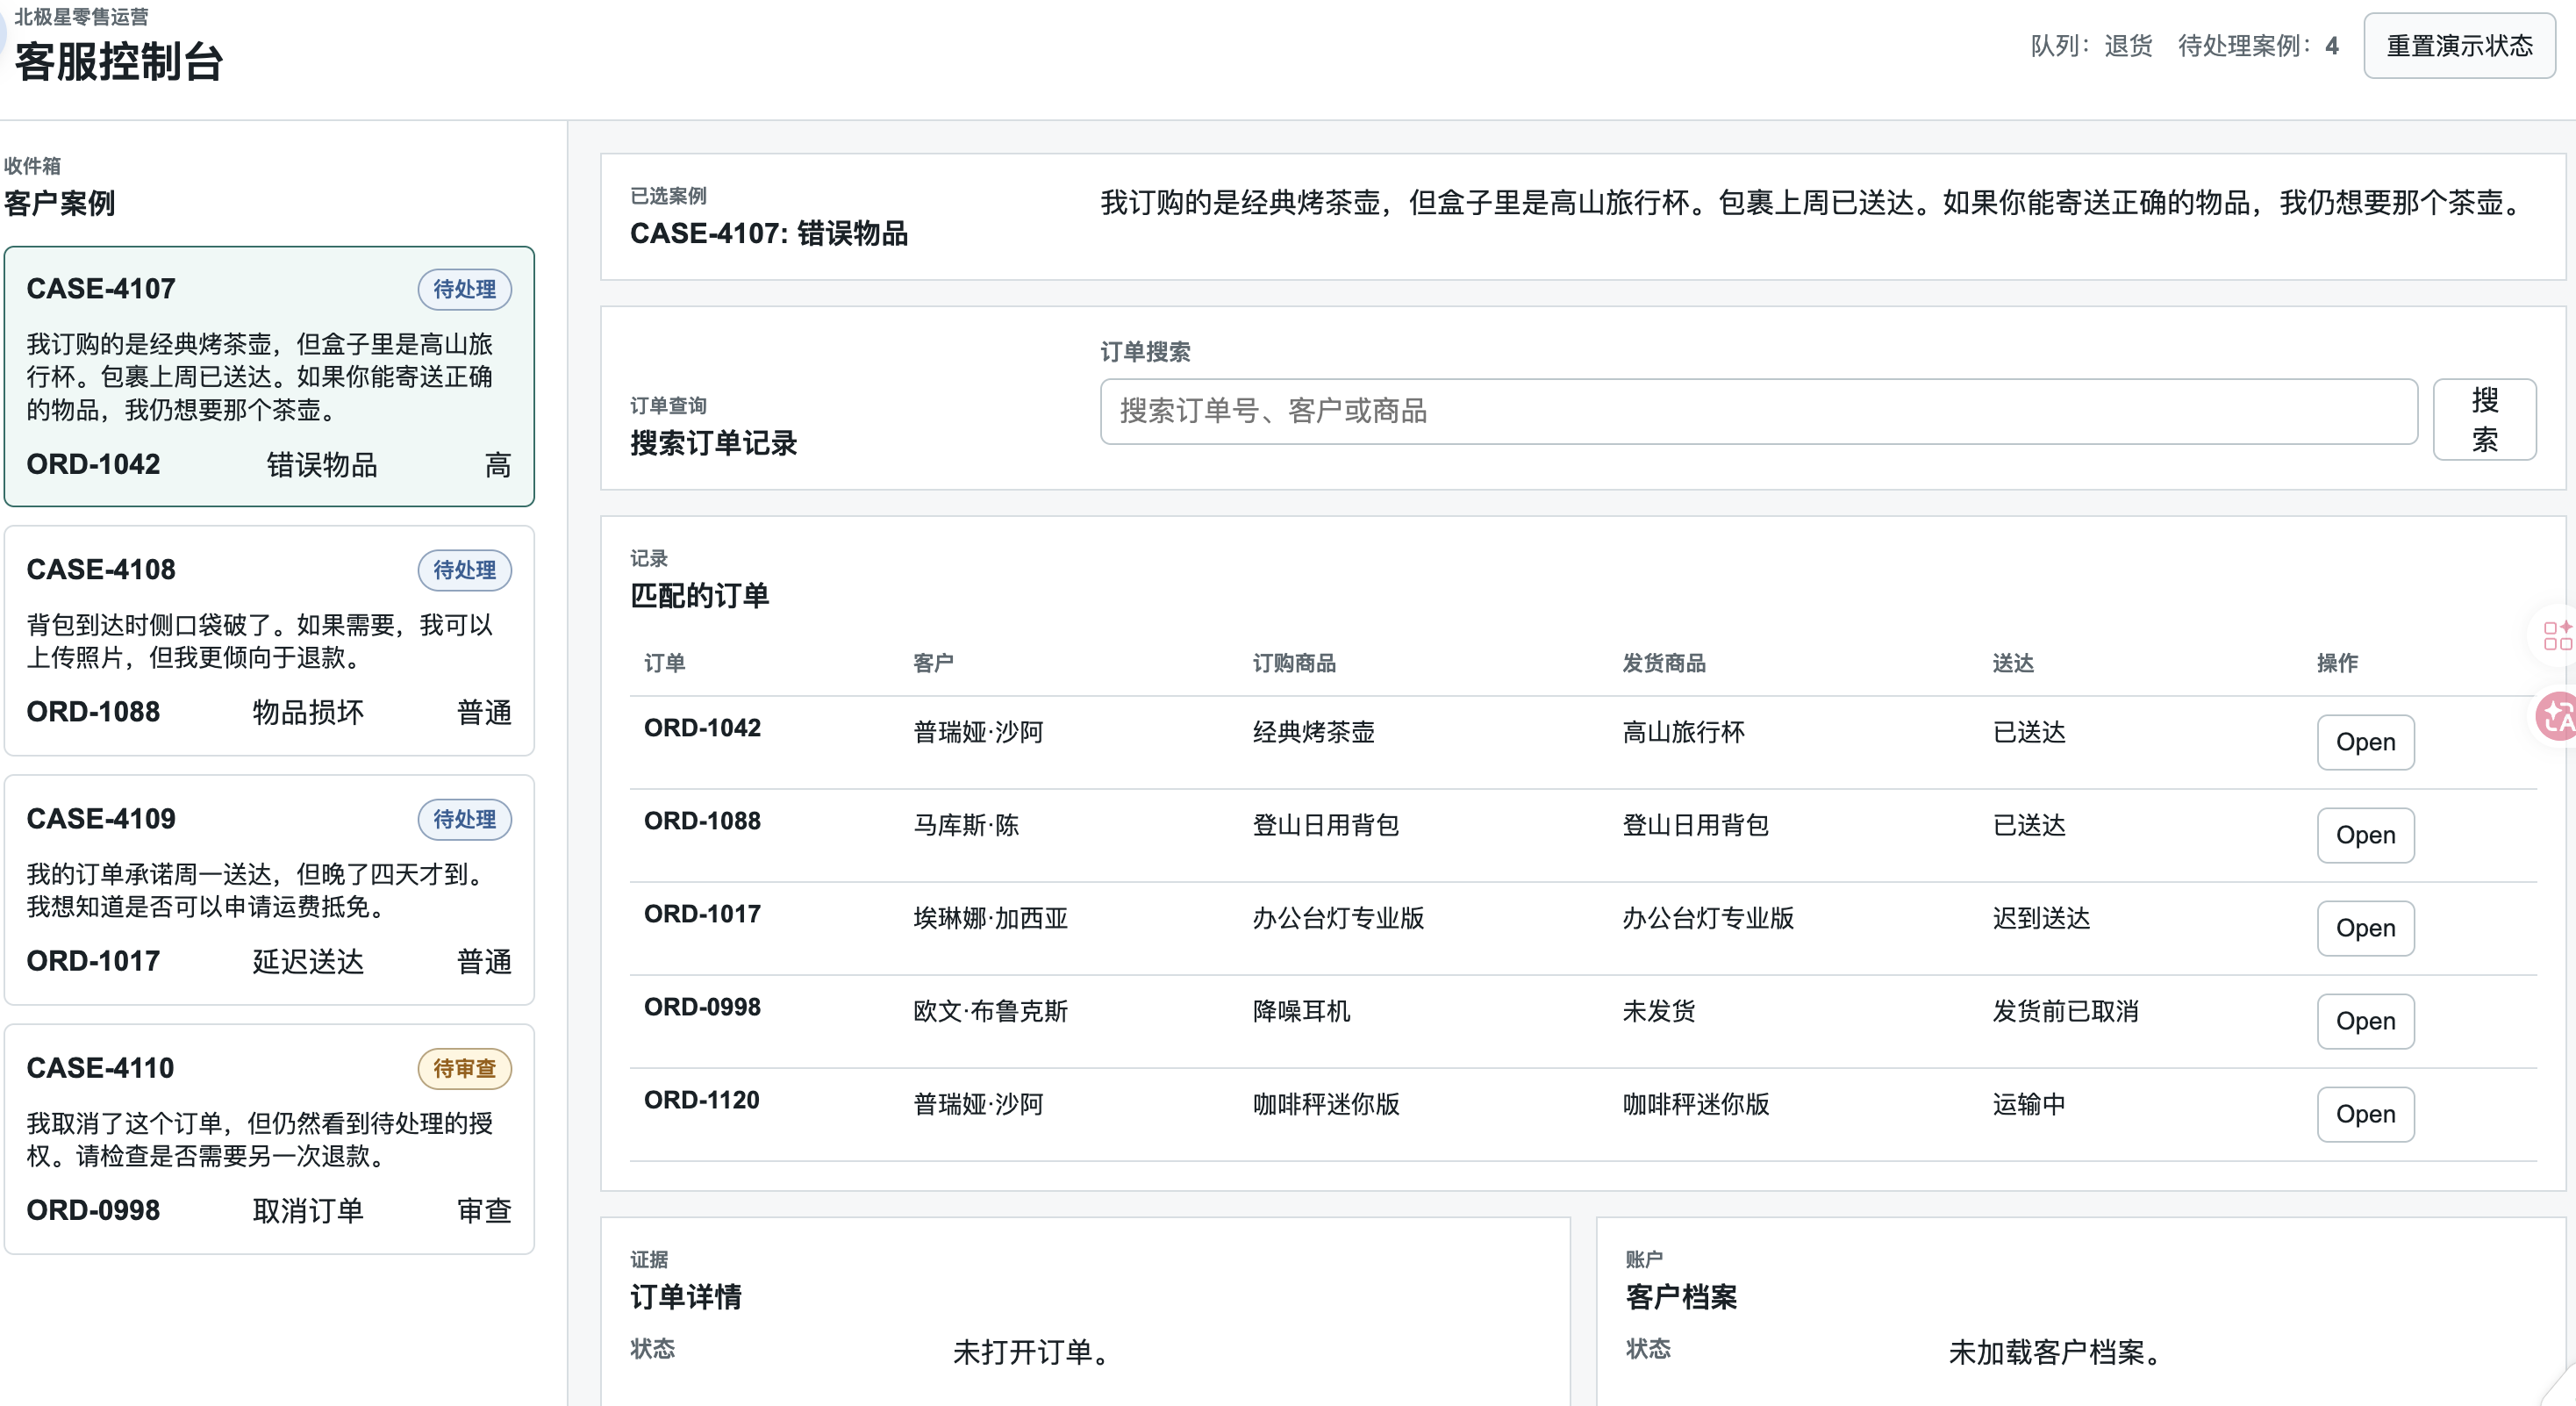
整体的技术架构如下:
用户任务 → Agents SDK(工具循环引擎)
 ↓
 Playwright MCP(浏览器操作能力)
 ↓
 Chrome 浏览器(实际操作页面)
关键代码:
 TASK = f"""
 打开 {APP_URL},处理订单 CASE-4108 的客服工单。
 请利用系统内现有信息判定并执行合适的解决方案;
 添加简洁的内部备注,并确认处理结果已成功保存。
 任务完成后汇报你的操作过程。
 """.strip()

 print("\n[agent] 启动 Playwright MCP server...")
 # async with 保证 agent 跑完后自动关闭 MCP 子进程,不留残余 Chrome
 async with ScriptMCPServerStdio(
 name="Playwright MCP",
 params={
 "command": "npx",
 "args": ["-y", "@playwright/mcp@latest", "--browser", "chrome"],
 },
 client_session_timeout_seconds=60, # 首次 npx 下载安装依赖可能慢,给足超时
 ) as playwright_server:
 print("[agent] MCP server 已连接,创建 agent...")

 agent = Agent(
 name="Support Console Browser Agent",
 instructions="You are an agent that can interact with a web browser.",
 model_settings=ModelSettings(), # 浏览器任务用默认设置即可
 mcp_servers=[playwright_server], # ← 浏览器工具来源

 )
 print(f"[agent] 任务: {TASK[:80]}...")
 print("[agent] 开始运行(Chrome 窗口会弹出,请勿手动关闭)...\n")

 try:
 result = await Runner.run(
 agent,
 TASK,
 max_turns=30, # 浏览器任务步骤多,给足轮次
 run_config=RunConfig(model_provider=CUSTOM_MODEL_PROVIDER),
 )
 except Exception as e:
 print(f"\n[agent] 运行异常: {type(e).__name__}: {e}")
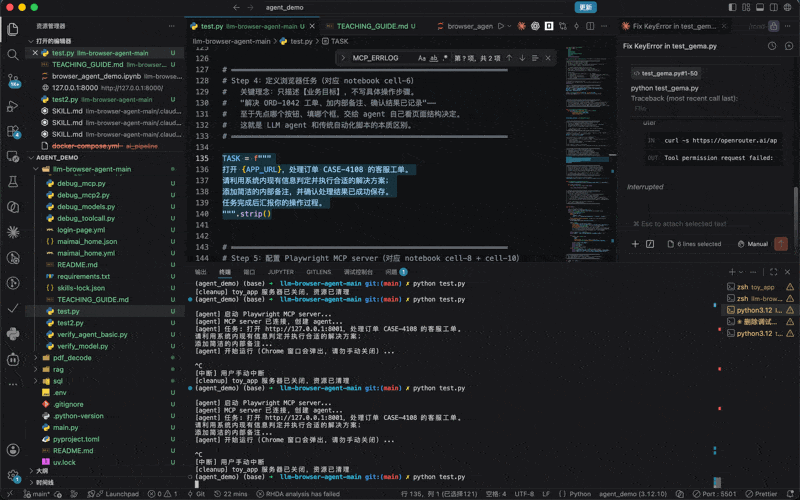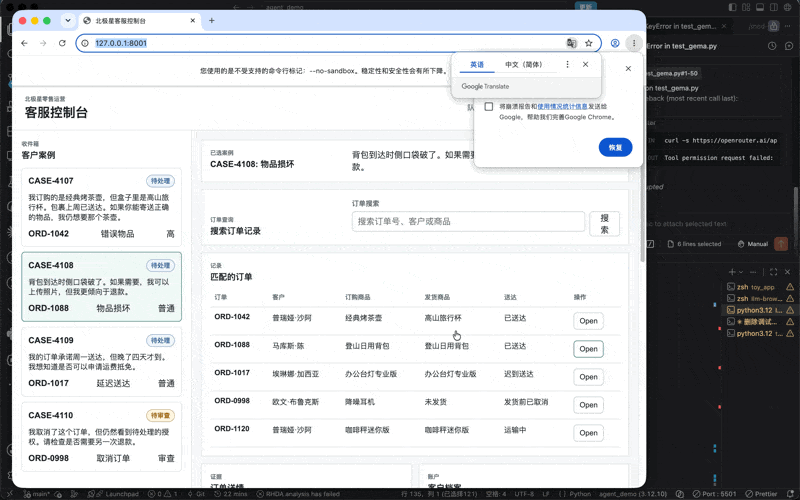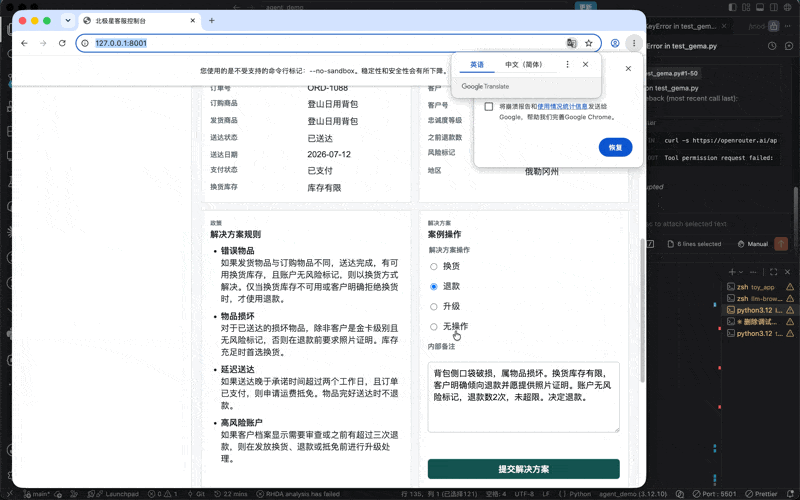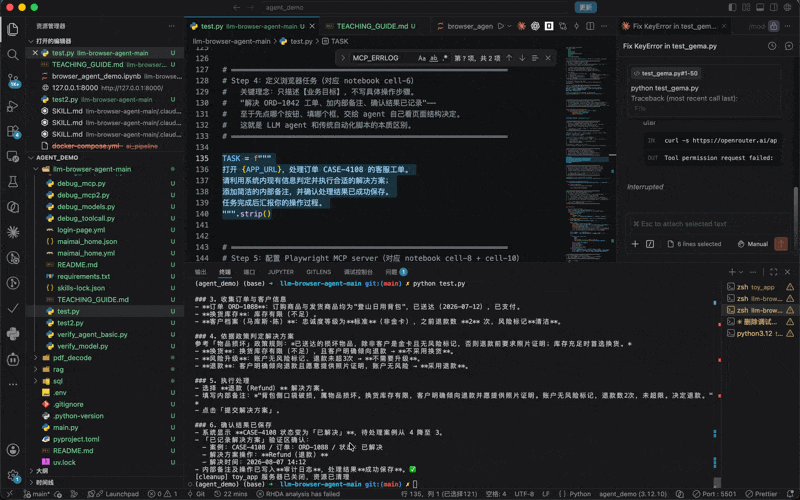
最后,Agent 打印出完整的执行过程。整个过程 Agent 没有收到任何一步操作指令,全靠自己读页面、做判断——这就是 Agent 与传统脚本的分水岭。
[agent] 运行完成!
============================================================
Agent 汇报:
============================================================
工单处理已经成功完成。让我确认一下处理结果:

1. **CASE-4108 状态已变为"已解决"**:在收件箱列表中显示"CASE-4108, 物品损坏, order ORD-1088, 已解决"
2. **待处理案例数从 4 减少到 3**:证明该案例已处理完毕
3. **"已记录解决方案"验证区显示**:
 - 案例:CASE-4108
 - 订单:ORD-1088
 - 状态:已解决
 - 解决方案操作:Refund(退款)
 - 解决时间:2026-08-07 14:12
 - 内部备注:已正确保存
4. **审计日志**也记录了该处理

处理结果已成功保存。让我向用户汇报整个操作过程。

---

## 操作过程汇报

我已完成 **CASE-4108** 客服工单的处理,以下是完整的操作过程:

### 1. 打开系统
- 访问了北极星客服控制台(http://127.0.0.1:8001),进入退货队列。

### 2. 定位并查看工单
- 从收件箱中选择了 **CASE-4108(物品损坏)** 工单,涉及订单 **ORD-1088**。
- 客户描述:**马库斯·陈** 的登山日用背包到达时侧口袋破损,客户倾向退款,并表示需要时可上传照片。

### 3. 收集订单与客户信息
- **订单 ORD-1088**:订购商品与发货商品均为"登山日用背包",已送达(2026-07-12),已支付。
- **换货库存**:库存有限(不足)。
- **客户档案(马库斯·陈)**:忠诚度等级为**标准**(非金卡),之前退款数 **2** 次,风险标记**清洁**。

### 4. 依据政策判定解决方案
参考「物品损坏」政策规则:*已送达的损坏物品,除非客户是金卡且无风险标记,否则退款前要求照片证明;库存充足时首选换货。*
- **换货**:换货库存有限(不足),且客户明确倾向退款 → **不采用换货**。
- **风险升级**:账户无风险标记、退款未超3次 → **不需要升级**。
- **退款**:客户明确倾向退款且愿意提供照片证明,账户无风险 → **采用退款**。

### 5. 执行处理
- 选择 **退款(Refund)** 解决方案。
- 填写内部备注:*"背包侧口袋破损,属物品损坏。换货库存有限,客户明确倾向退款并愿提供照片证明。账户无风险标记,退款数2次,未超限。决定退款。"*
- 点击「提交解决方案」。

### 6. 确认结果已保存
- 系统显示 **CASE-4108 状态变为「已解决」**,待处理案例从 4 降至 3。
- 「已记录解决方案」验证区确认:
 - 案例:CASE-4108 / 订单:ORD-1088 / 状态:已解决
 - 解决方案操作:**Refund(退款)**
 - 解决时间:2026-08-07 14:12
- 内部备注及操作已写入**审计日志**,处理结果**成功保存**。✅
2026-07-22 10:48:46
最近梳理了一下自己在 onsidian 上记的笔记,发现过去很多记的笔记都比较零散,记到电脑或者手机上之后,就很少再会查看或者利用了。
为了让自己过去的笔记内容不再荒废,为了让现在的我支援未来的自己,我研究了一下如何让笔记流动起来的方法。
市场上常用的笔记组织方法有 2 种,PARA 记录和Zettelkasten记录。
1/ PARA
笔记的目录结构分为 4 类:
项目(project):有明确截止日期的进行中项目(例如,“第三季度上线公司网站”)
领域(area):持续负责的领域,没有截止日期(例如,“健康”、“财务”、“XYZ 团队”)
资源(resource) :按兴趣分类的参考资料(例如,“机器学习”、“斯多葛哲学”)
存档(archive) :以上三个类别中的非活跃项目
2/ Zettelkasten
Zettelkasten 的核心是原子笔记(每条笔记只记录一个想法)。
Zettelkasten 的核心原则:每张永久笔记都必须至少与其他一张笔记关联;无法与任何笔记关联的笔记,或许就不该作为独立笔记存在。
笔记的目录结构分为 3 类:
我的笔记组织结构核心想法是不想太复杂,目录结构尽量不要嵌套多层,这是我以前的苹果备忘录的组织结构:
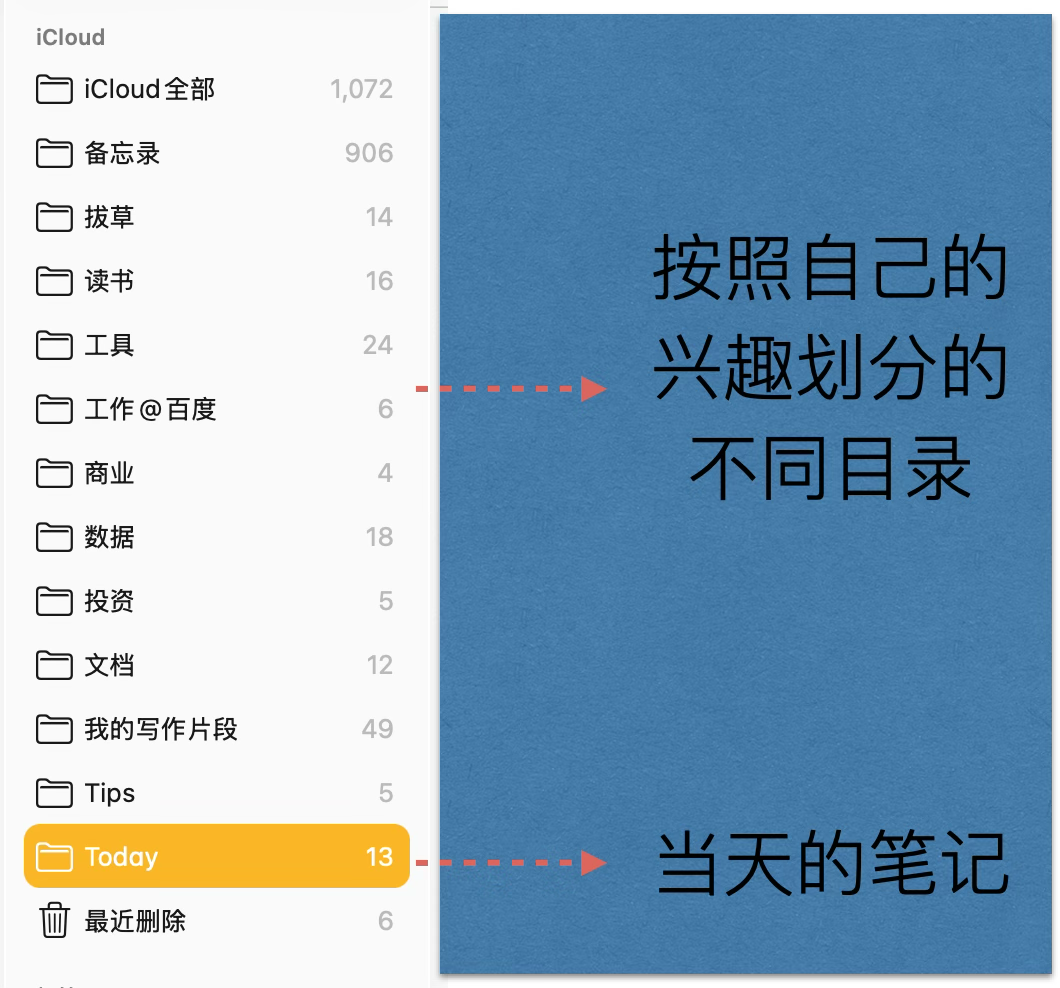
整体看,整个目录结构并不像 PARA 那样相互独立,比如有的笔记既可以放在商业目录下,也可以放在数据目录下,其实这种情况用「标签」的方式组织或许会更好。
除了结构简单,我对笔记系统的核心速求是要用起来,可以有产出。于是,在纸上勾勾画画之后,我总结了整体的框架如下:
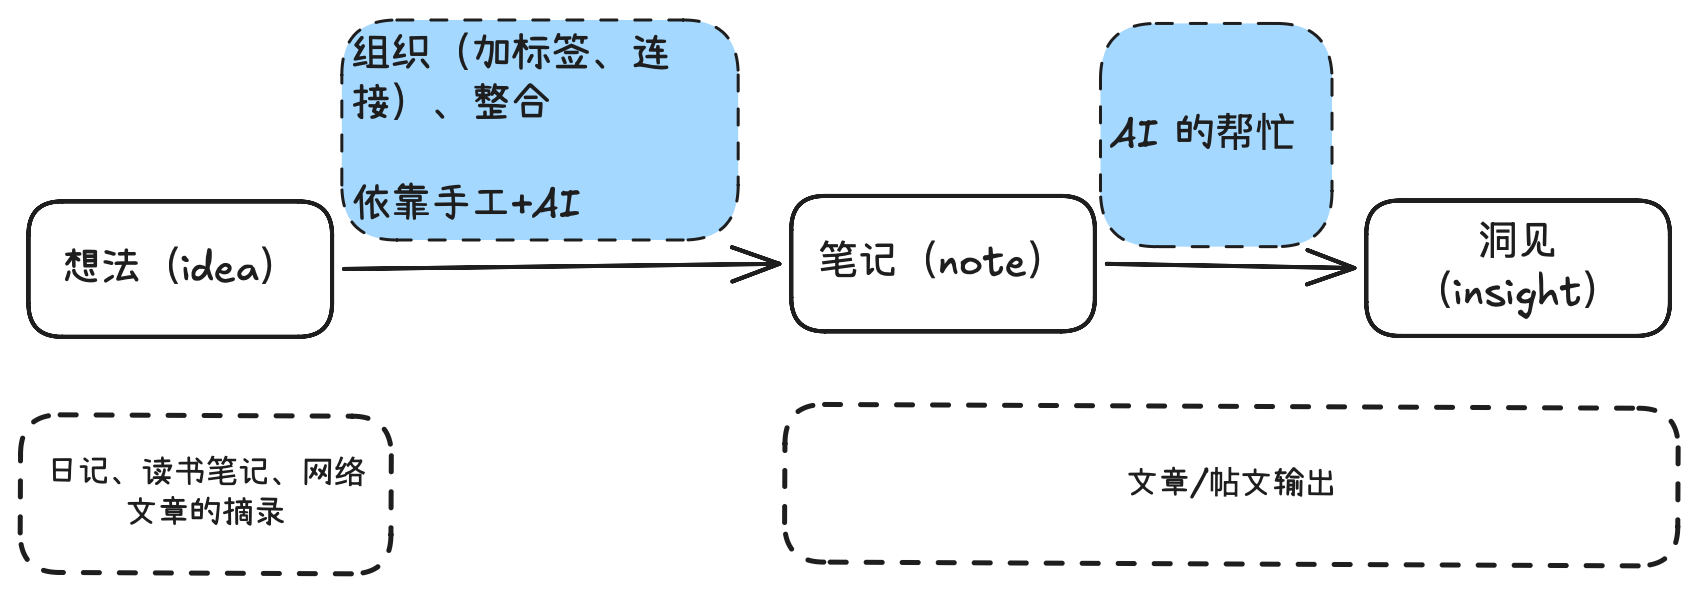
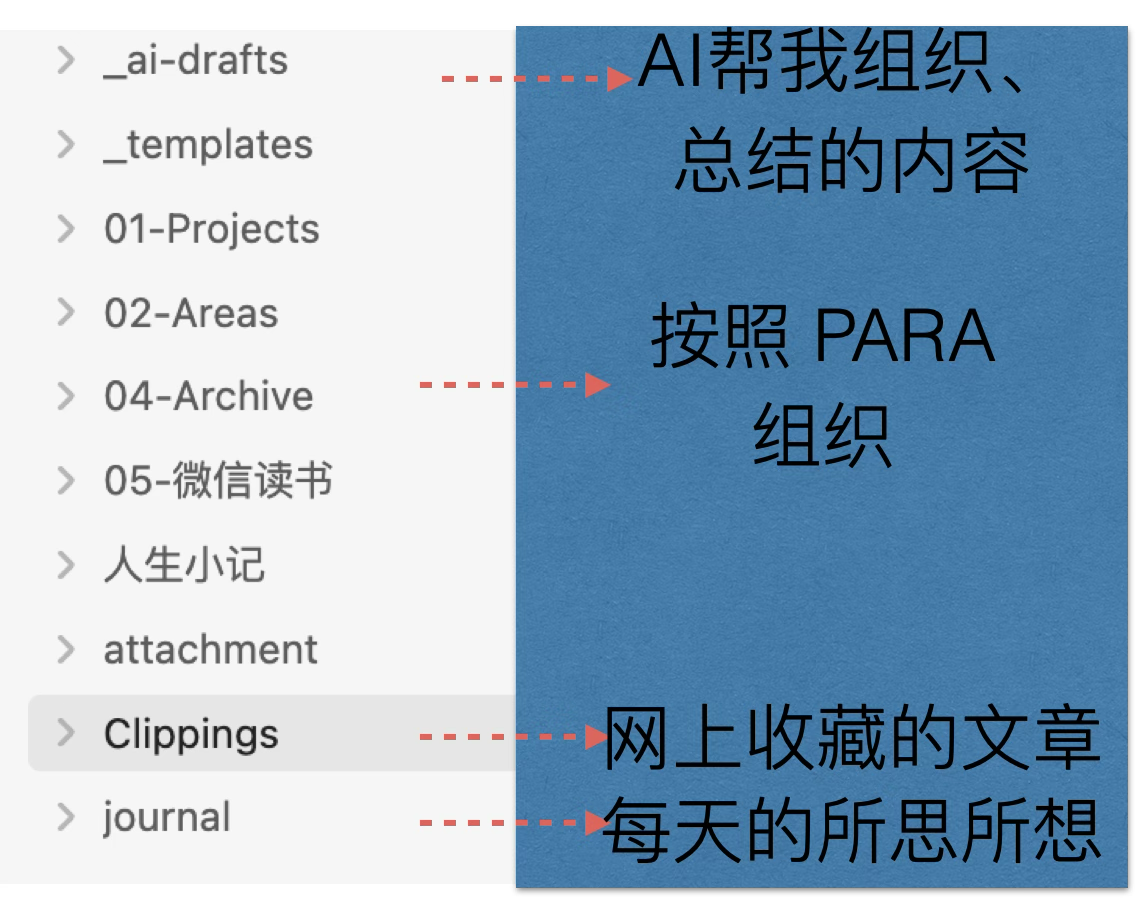
基于上面的思考,我重新设置我的obsidian 的目录,结构如下:
2026-05-28 11:33:02
注册使用过的第三方中转站太多了,如何管理成了一个问题。
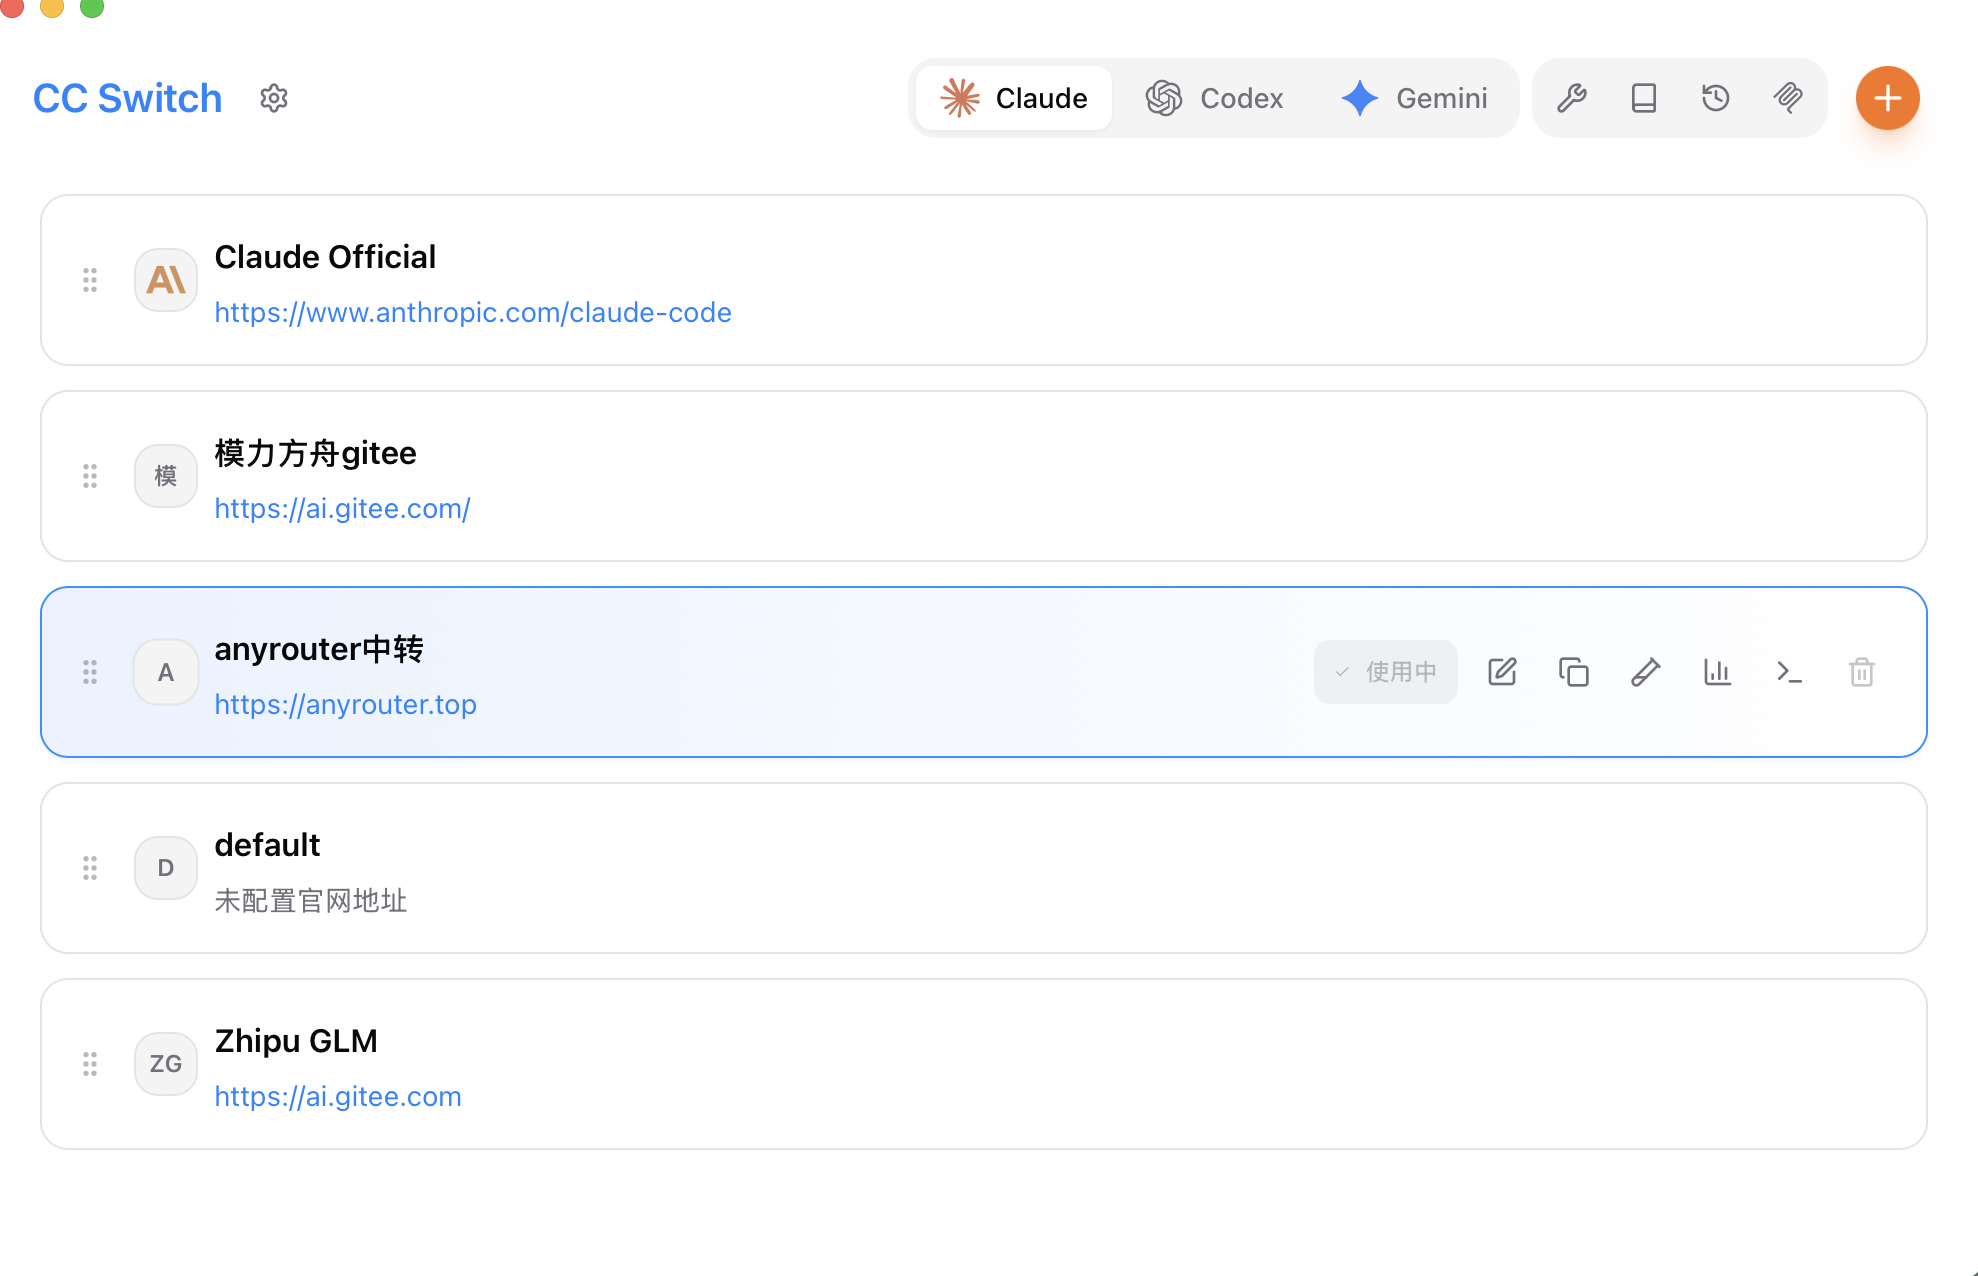
今天调研使用了一下 cc switch,感觉还可以。
下载地址:https://github.com/farion1231/cc-switch/tree/main 5万多个 star,应该还算靠谱
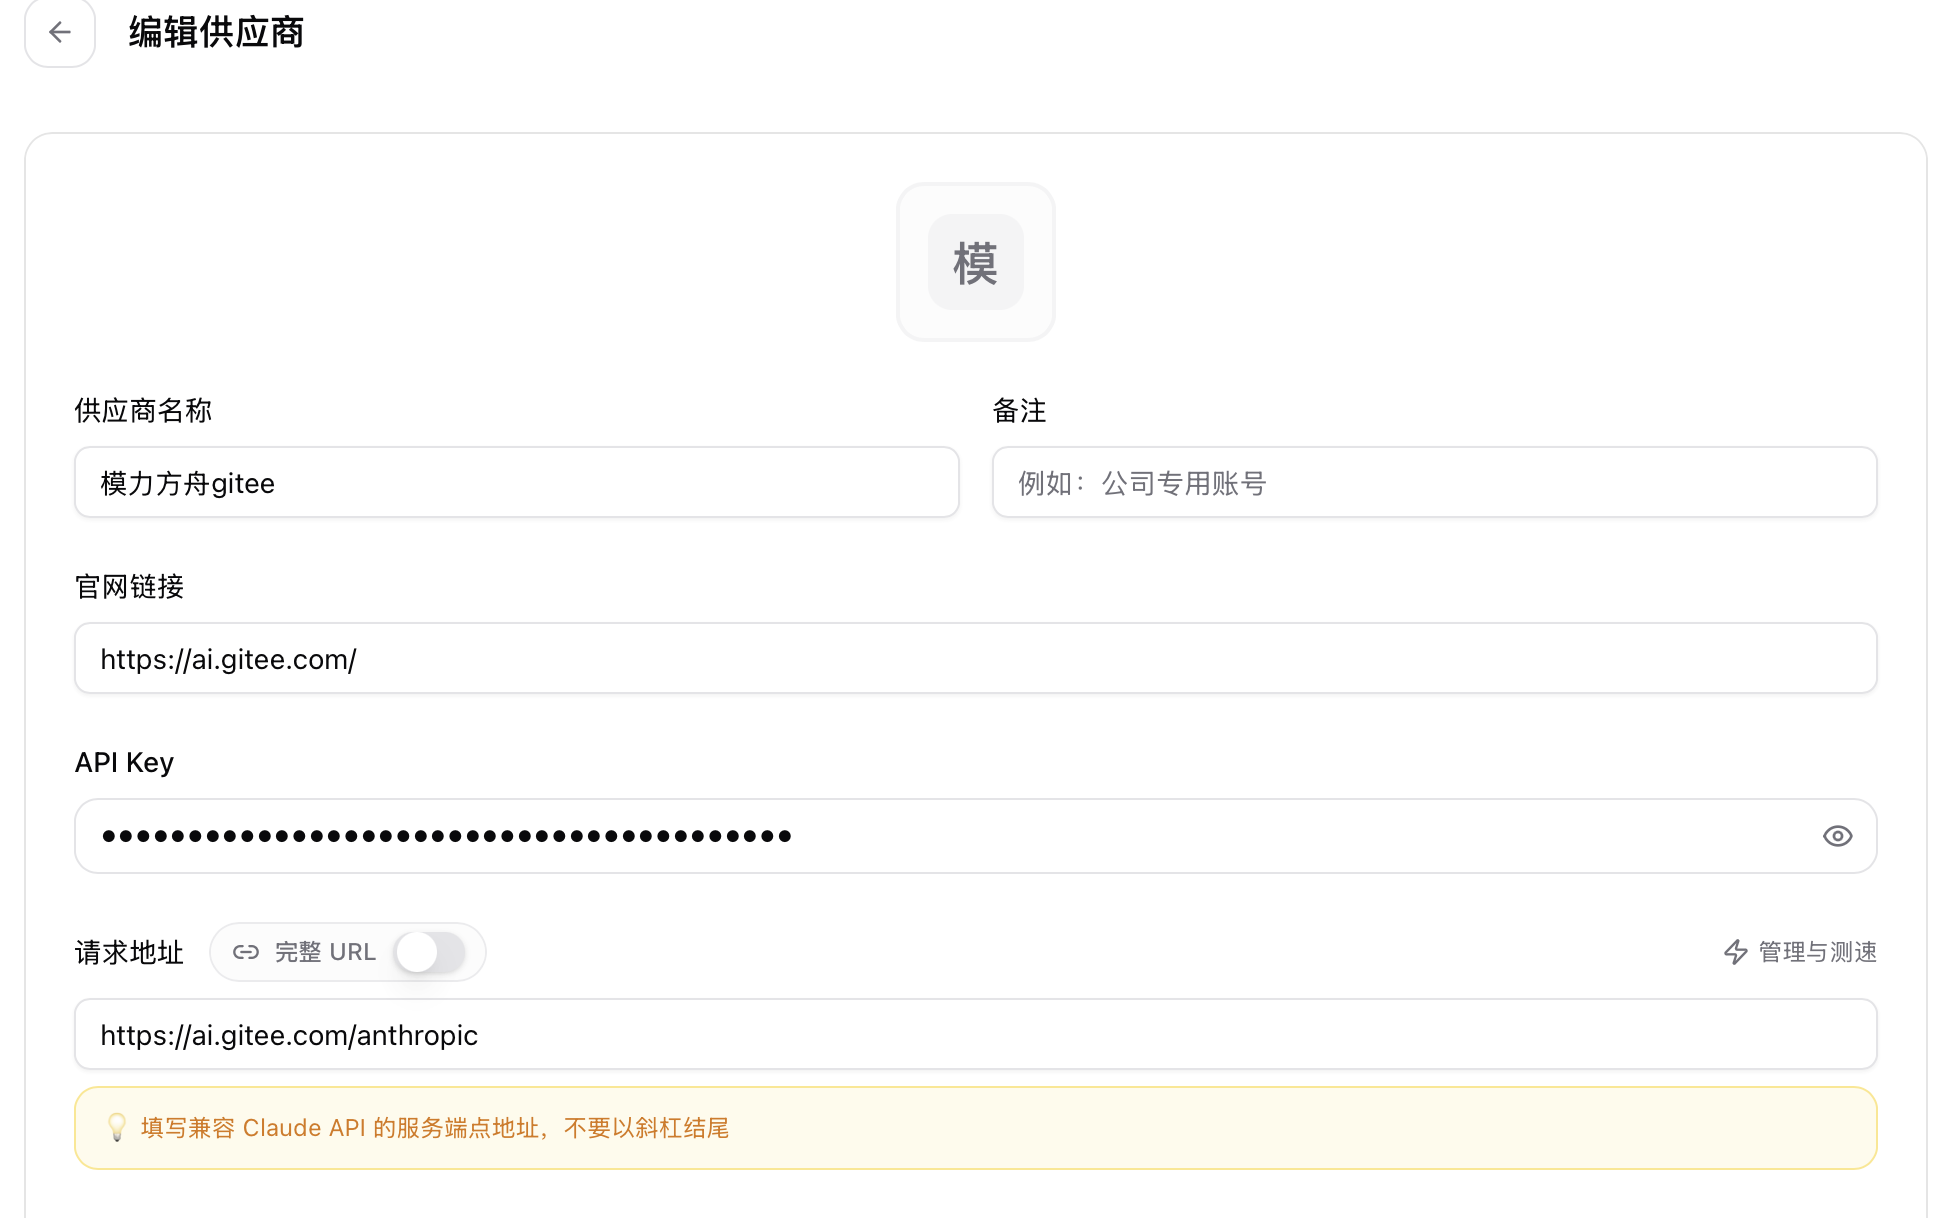
1/ 添加基本配置,主要是 API Key 和请求地址
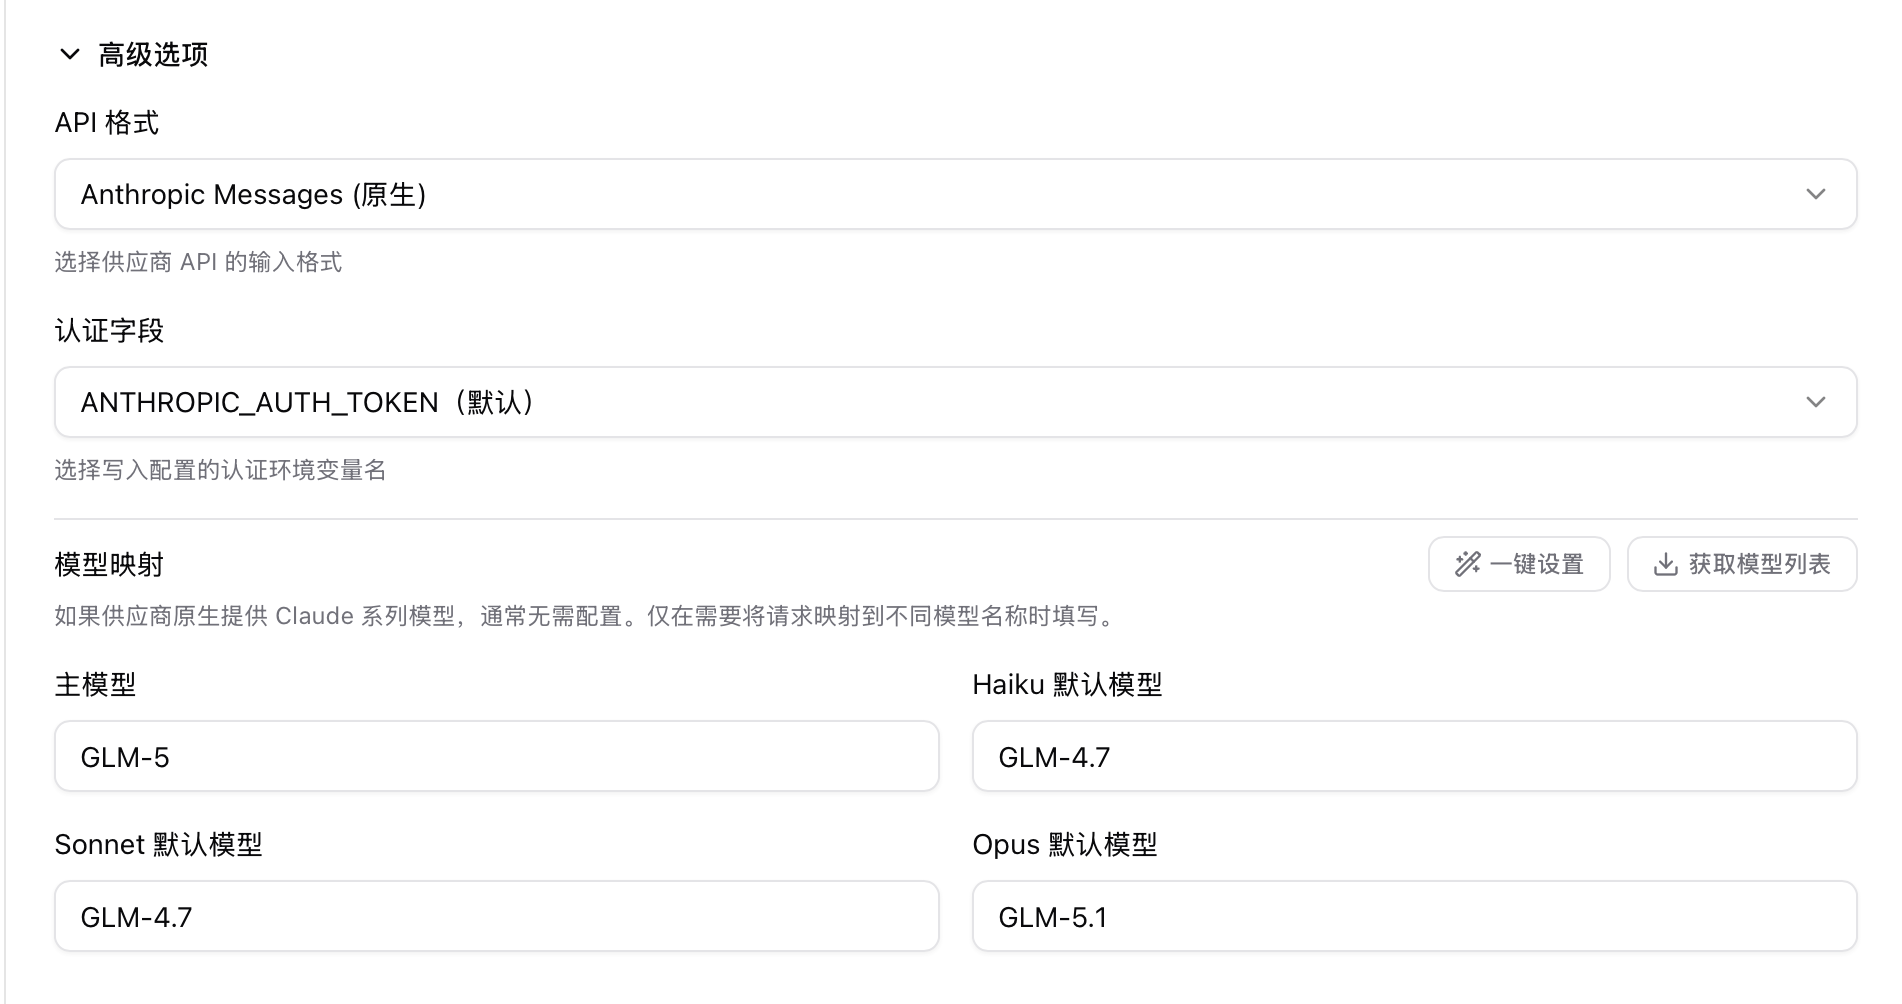
2/ 配置一下模型映射
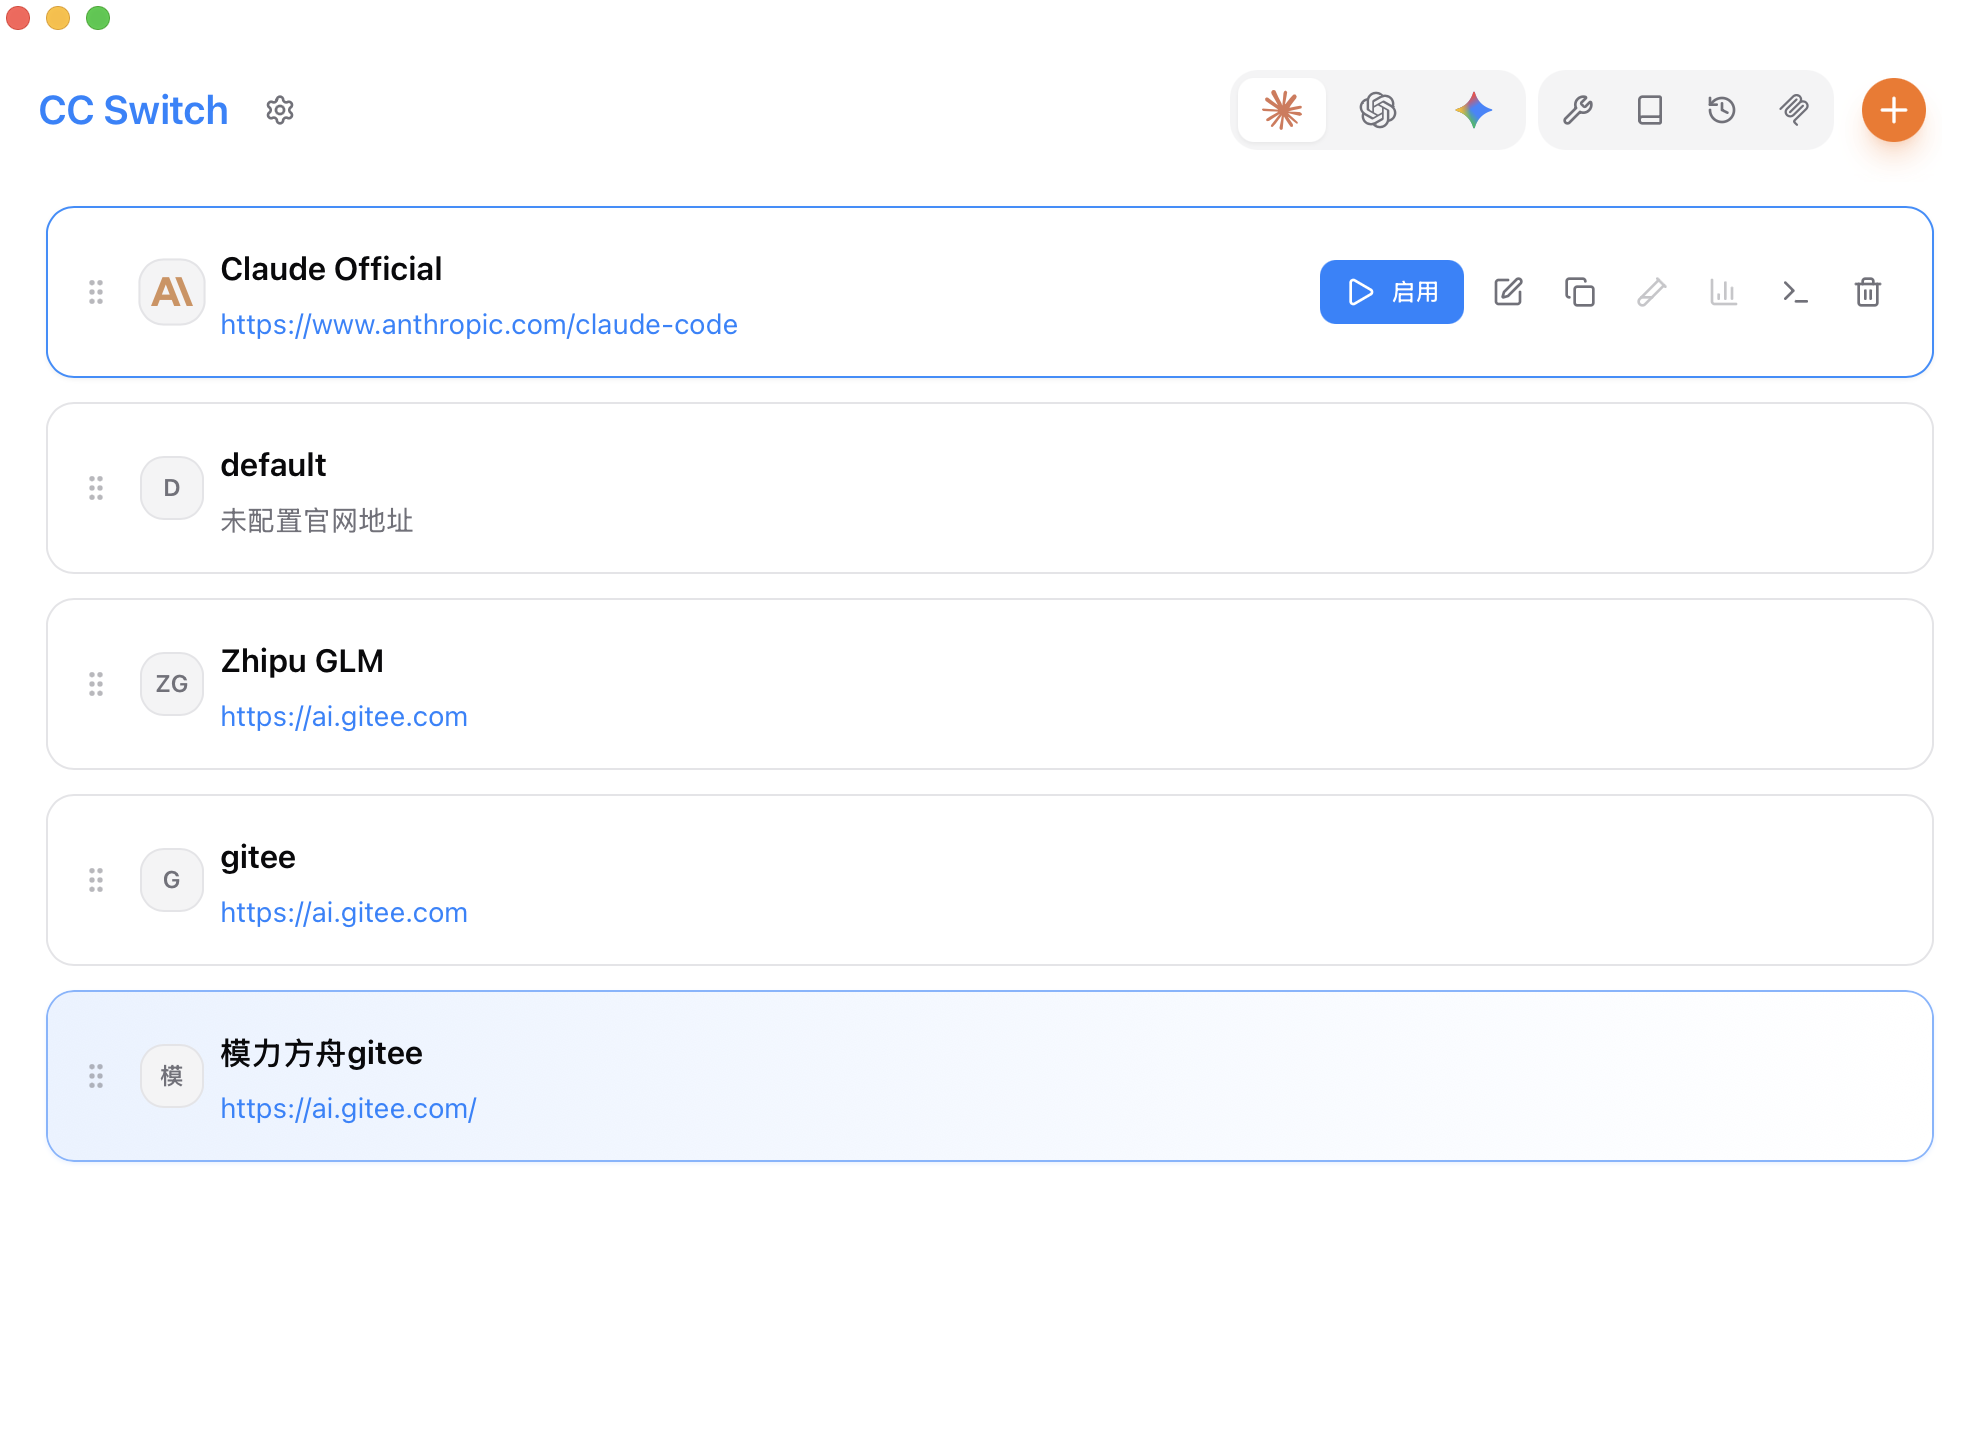
3/ 点击一下"启用"按钮就可以正常使用了
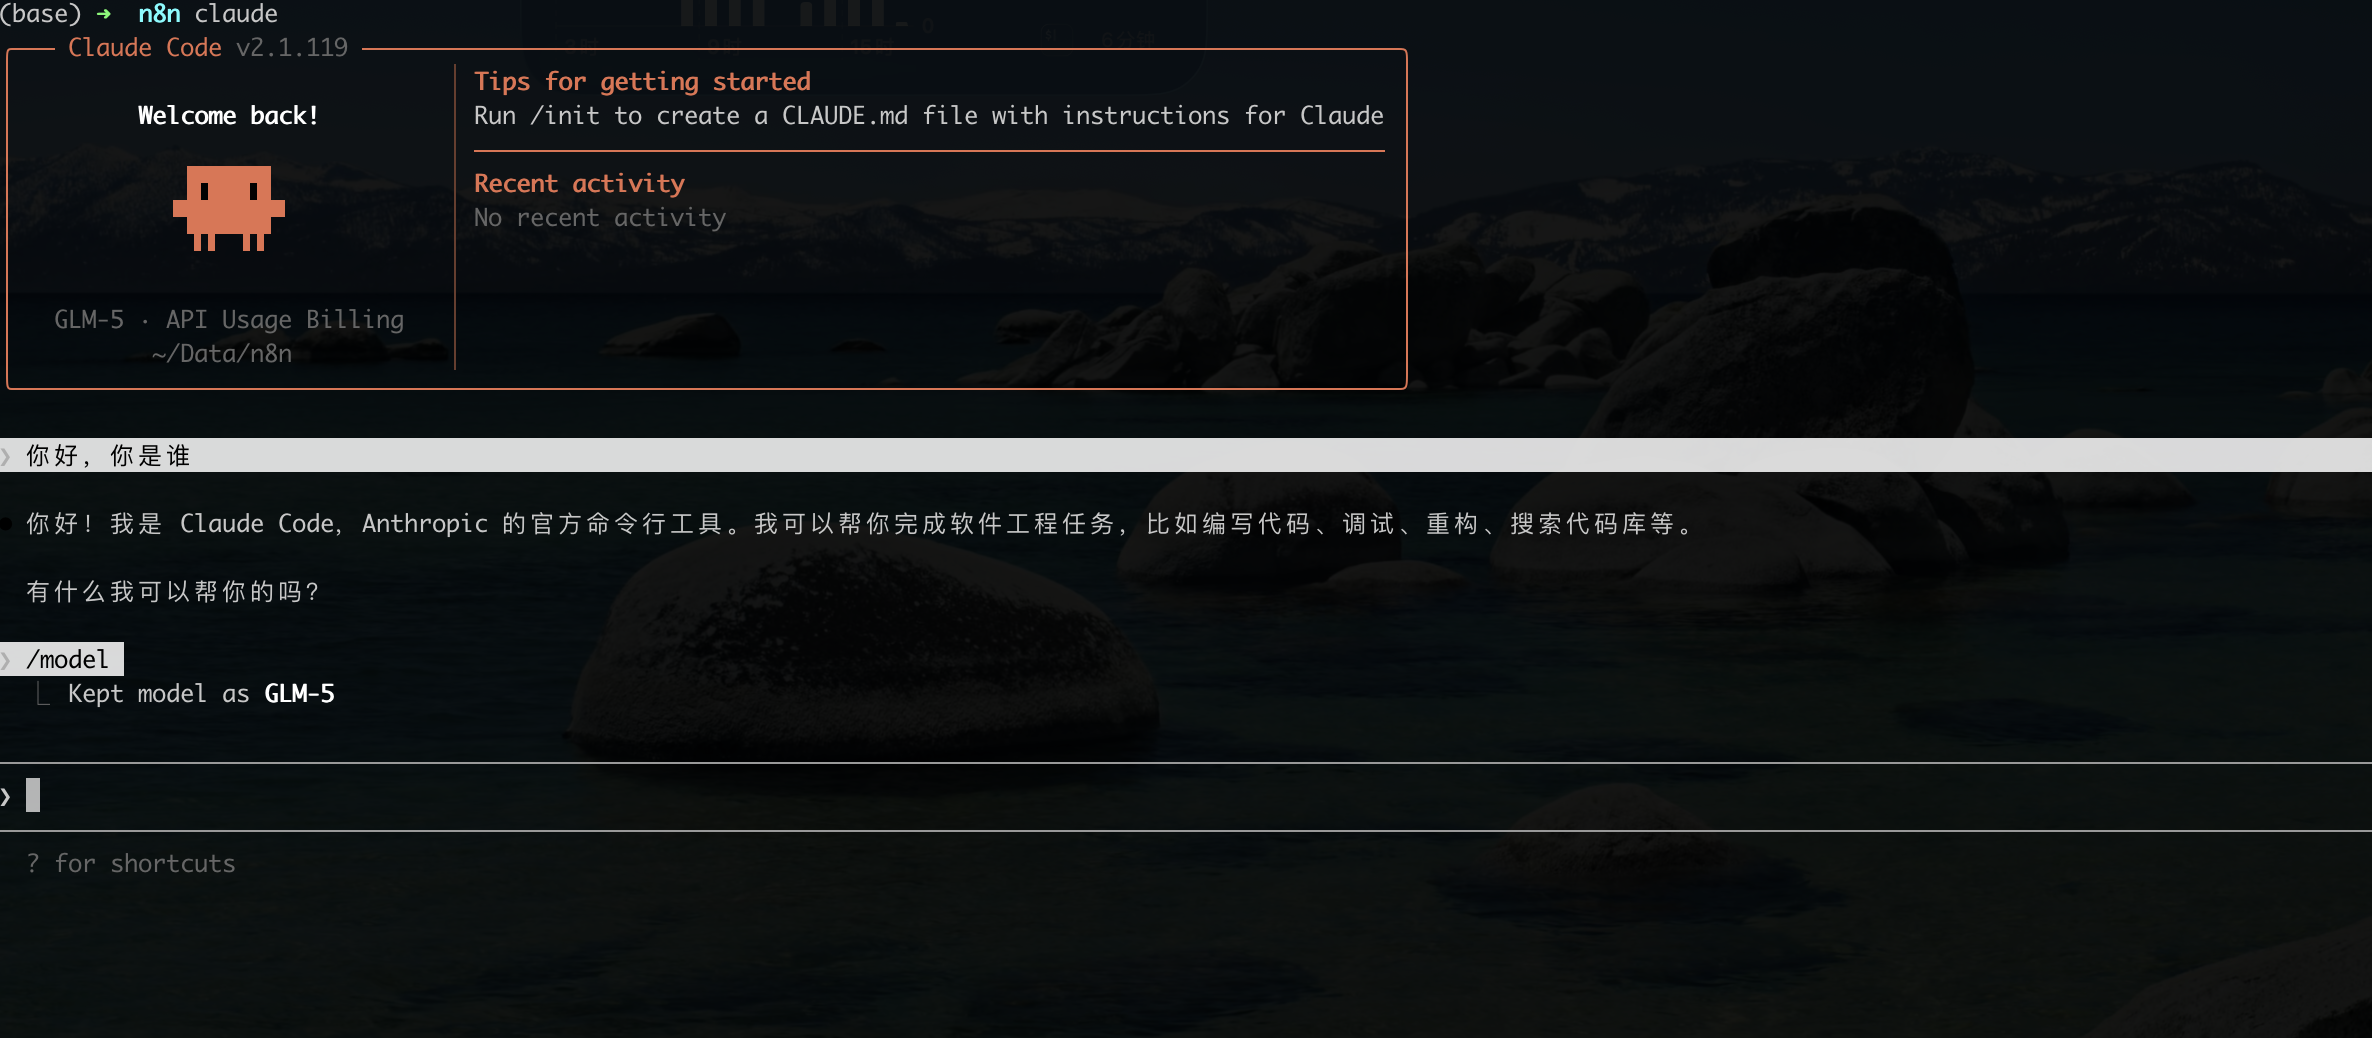
cc-switch 是实时热加载配置,即改即用。目前主要使用 anyrouter 的中转站,效果还不错,可以把以前在 ~/.zshrc中手动添加的配置注释掉了。
2026-01-22 17:56:41
作为 Anthropic 官方推出的命令行编码助手(coding assistant),Claude Code 本质上是一个通过大模型(LLM)执行复杂任务的工具。通常情况下,它需要连接云端 API。但随着 Ollama 宣布兼容 Anthropic Messages API,我们现在可以轻松地将 Claude Code 与本地模型集成。
从工程角度看,使用本地的模型既可以作为断网情况下的一种保障方案,也可以在不改变工作流程的情况下,把本地模型作为一个测试开发环境,极大节省 Token 开销。
1.安装 Claude Code 和 Ollama
npm install -g @anthropic-ai/claude-code@latest
Ollama 可以通过官网https://ollama.com/下载安装包安装。
注意:Ollama 版本v0.14.0+,Claude Code版本v2.1.12+,可以通过下面命令验证
claude --version
ollama --version
Ollama 安装后会自动作为后台服务运行。应该可以在 http://localhost:11434 上看到它运行。
2.下载大模型
可以通过 Ollama 的 WebUI 页面直接下载,如下图。
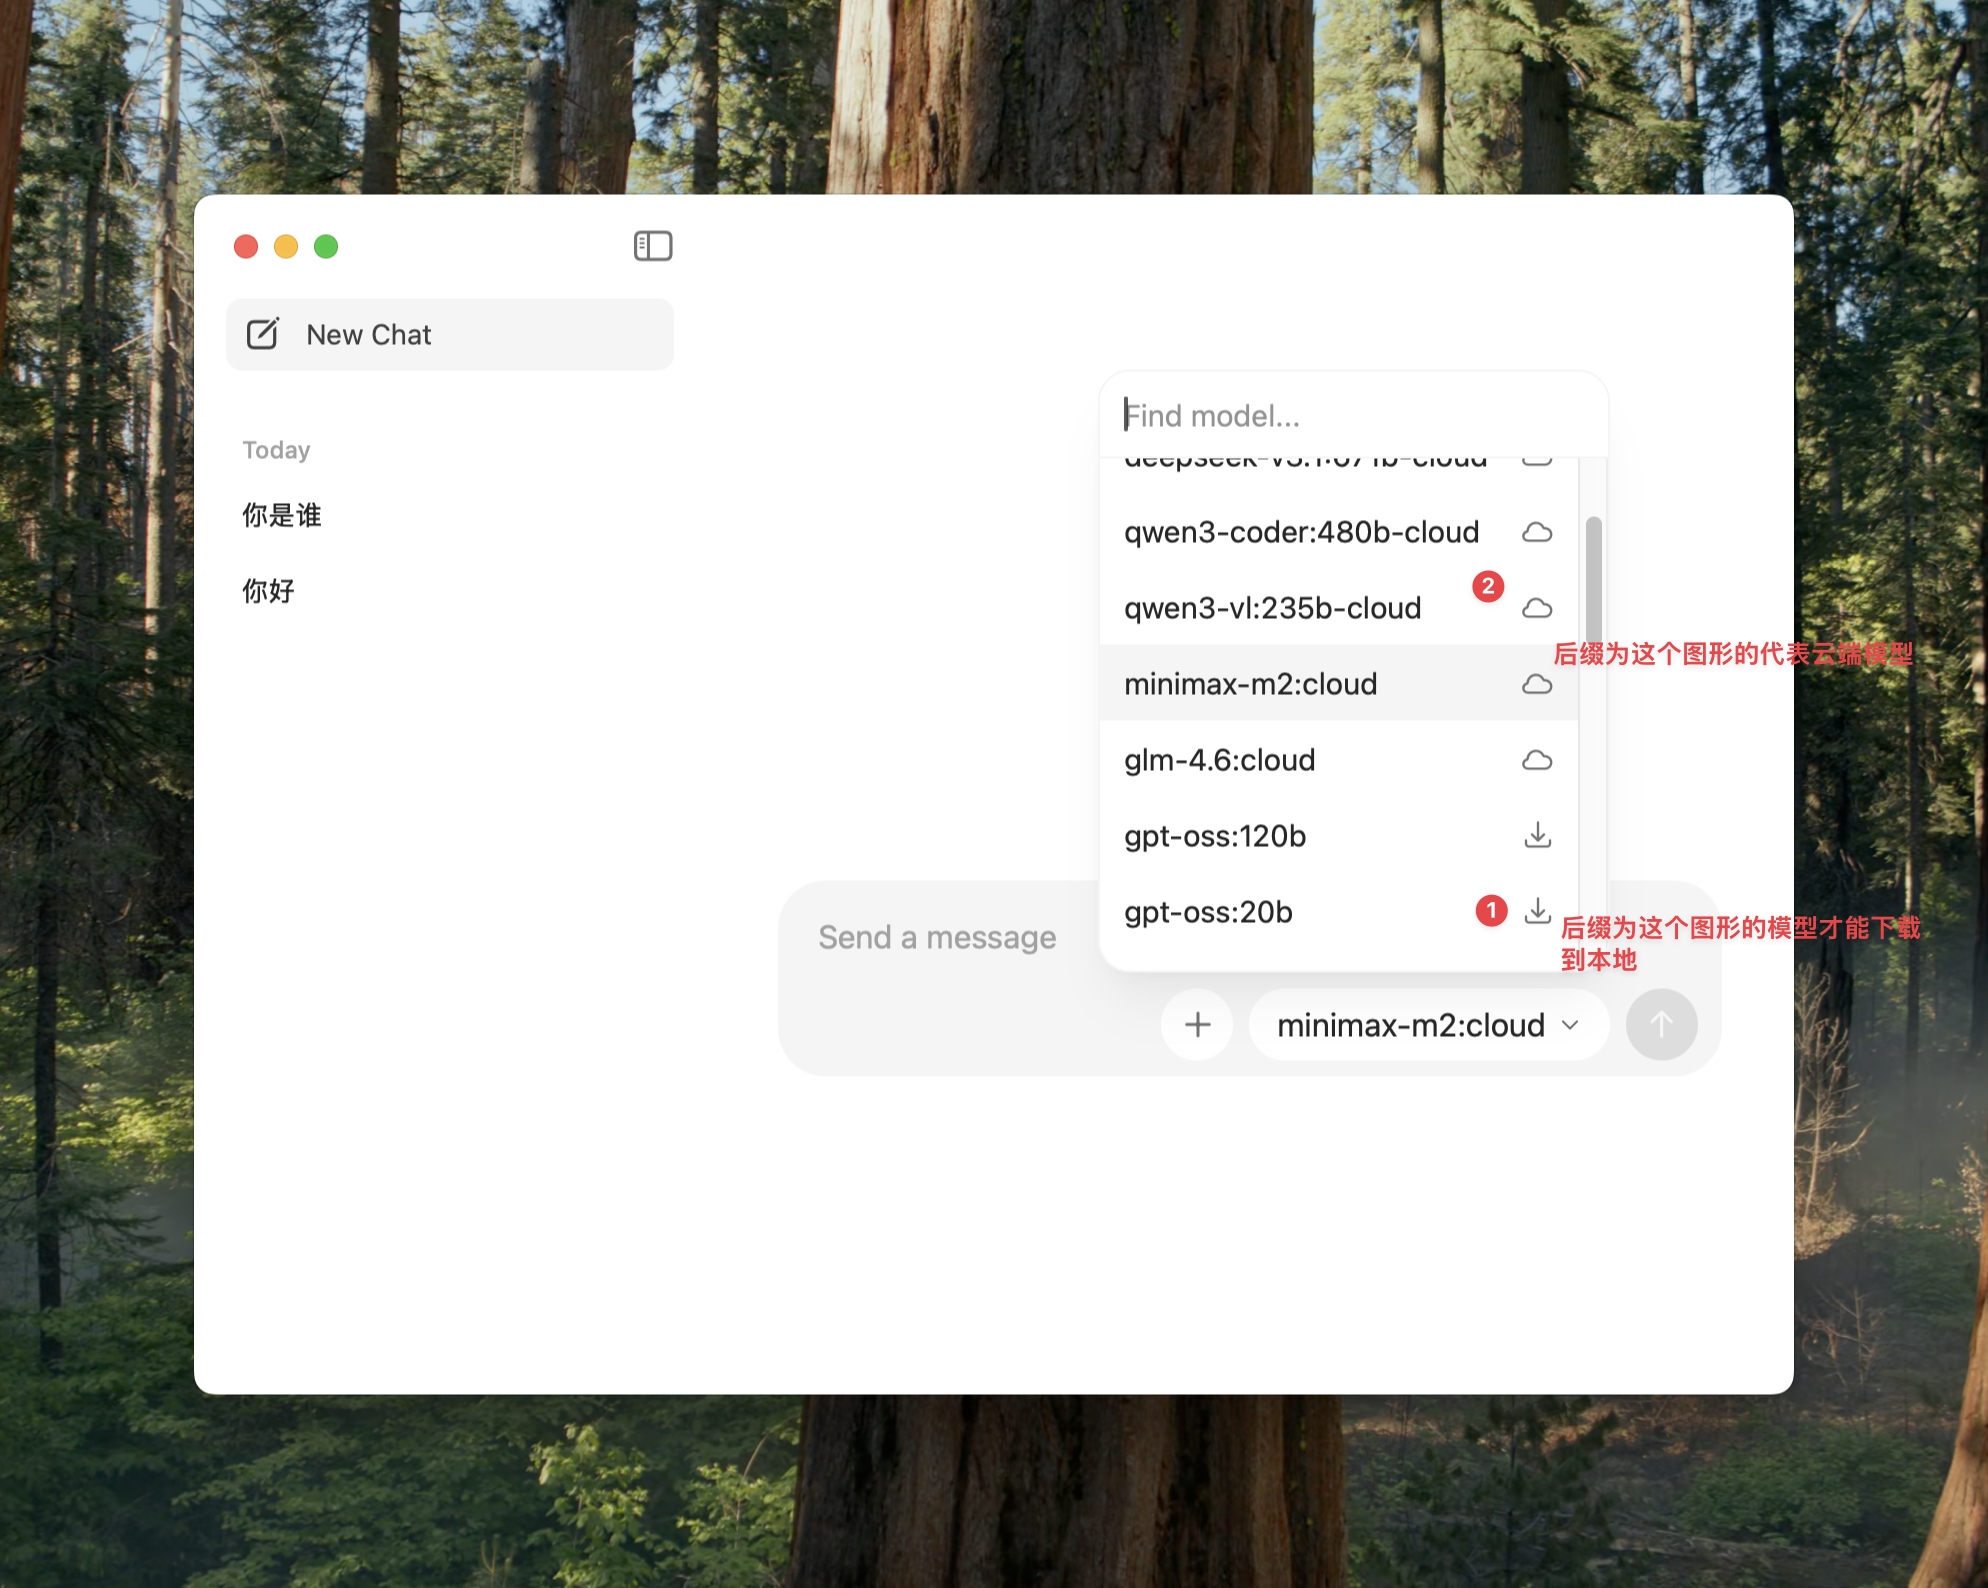
也可以通过命令行快速拉取适合编码的模型。
#查看本地模型
ollama list

#下载新模型
ollama pull qwen2.5-coder:7b

#删除模型
ollama rm qwen2.5-coder:7b

#查看模型基本参数
ollama show qwen2.5-coder:7b
3.配置 Claude Code 连接本地 Ollama
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_BASE_URL=http://localhost:11434
# 启动 Claude Code 并指定本地模型
claude --model qwen2.5-coder:7b

# 如果想使用云端模型,命令类似
claude --model glm-4.6:cloud
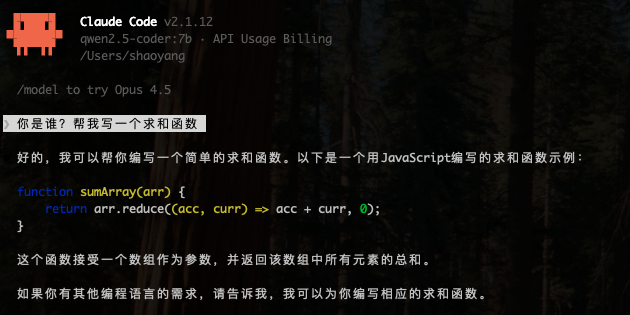
注意:如果你开启了系统代理,可能会遇到
API Error: Connection error。这是因为流量被转发到了代理服务器而找不到 localhost。请先在终端执行:
unset https_proxy
unset http_proxy
4.使用Anthropic SDK
如果我们想更精准的把控程序的执行流程,可以使用官方的 SDK。
import anthropic
import httpx
http_client = httpx.Client(
 proxy=None,
 trust_env=False,
)

client = anthropic.Anthropic(
 base_url='http://localhost:11434',
 api_key='ollama',
 http_client=http_client,

)

with client.messages.stream(
 model='qwen2.5-coder:7b',
 max_tokens=1024,
 messages=[{'role': 'user', 'content': 'Count from 1 to 10'}]
) as stream:
 for text in stream.text_stream:
 print(text, end='', flush=True)
这里再说一个调试的技巧:在配置过程中,不要死磕枯燥的错误堆栈信息。一个高效的调试技巧是:向 AI 描述你的完整环境和所做的工作,而不仅仅是报错代码。
此前我按照文档编写代码时,一直遇到 InternalServerError (503) 错误。我直接把错误代码粘贴给 chatgpt ,它尝试了很多方法但始终没有解决。
Traceback (most recent call last):
 File "/Users/shaoyang/Project/stock_demo/day09/anthropic-demo.py", line 12, in <module>
 message = client.messages.create(
 File "/Users/shaoyang/Project/stock_demo/.venv/lib/python3.10/site-packages/anthropic/_utils/_utils.py", line 282, in wrapper
 return func(*args, **kwargs)
 File "/Users/shaoyang/Project/stock_demo/.venv/lib/python3.10/site-packages/anthropic/resources/messages/messages.py", line 932, in create
 return self._post(
 File "/Users/shaoyang/Project/stock_demo/.venv/lib/python3.10/site-packages/anthropic/_base_client.py", line 1361, in post
 return cast(ResponseT, self.request(cast_to, opts, stream=stream, stream_cls=stream_cls))
 File "/Users/shaoyang/Project/stock_demo/.venv/lib/python3.10/site-packages/anthropic/_base_client.py", line 1134, in request
 raise self._make_status_error_from_response(err.response) from None
anthropic.InternalServerError: Error code: 503
于是,我换了一种思路,不是直接粘贴错误代码,而是前置一步,客观地描述了一下当前的环境。
import anthropic

client = anthropic.Anthropic(
 base_url='http://localhost:11434',
 api_key='ollama', # required but ignored
)

message = client.messages.create(
 model='qwen3-coder',
 max_tokens=1024,
 messages=[
 {'role': 'user', 'content': 'Hello, how are you?'}
 ]
)
print(message.content[0].text)

我是用的是mac电脑,本地配置了代理,我应该如何修改上面的代码保证可以运行。

js版本是可以执行的
import Anthropic from "@anthropic-ai/sdk";

const anthropic = new Anthropic({
 baseURL: "http://localhost:11434",
 apiKey: "ollama", // required but ignored
});

const message = await anthropic.messages.create({
 model: "minimax-m2:cloud",
 max_tokens: 1024,
 messages: [
 { role: "user", content: "写一个求和的 python 函数" }
 ],
});

console.log(message.content[1].text);
chatgpt立刻就发现了问题,并给到我正确的执行代码。
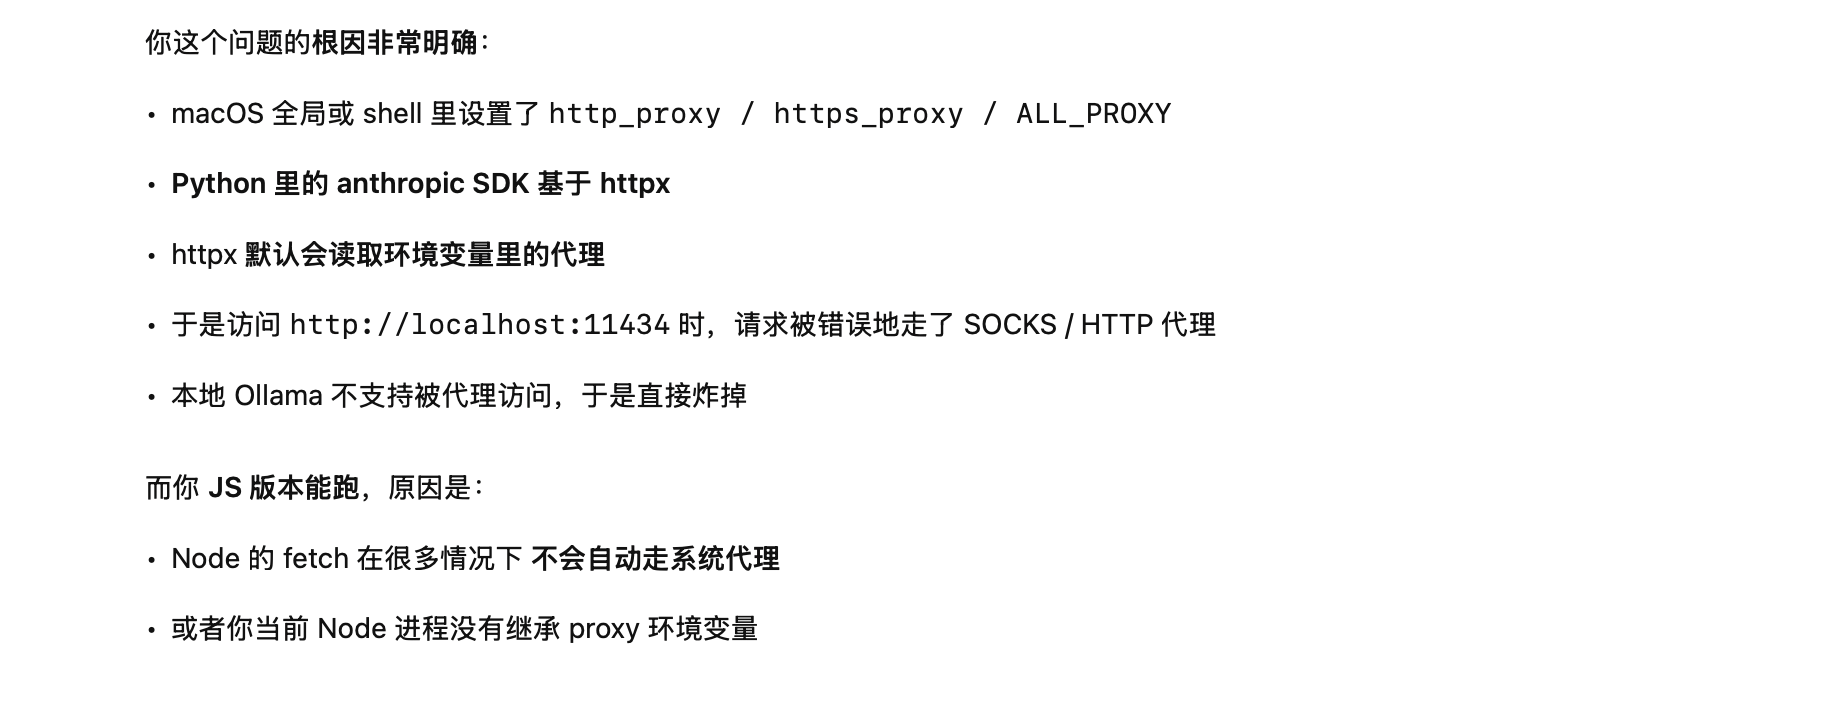
根据这次调试过程,大模型也帮我总结一个更有效的提问模板:
1.贴出当前代码。

2.描述环境(如:Mac 系统、本地有代理)。

3.提供一个对比参照(如:JS 版本可以运行,Python 不行)。


