2026-10-18 00:00:00
最近,我重新梳理了自己的工作方式。变化最明显的地方,是我开始把完整任务交给一个负责调度的统筹者,由它组织其他 Agent 推进,自己逐步退出逐个窗口盯进度的状态。
这篇接着八月那篇 AI Native 实践往下写:Stage 7 留下了哪些验证问题,迈向 Stage 8 时,我在调度上做了哪些尝试,以及实际跑起来以后遇到的新问题。
我用这张 Stage 1—8 演进图定位自己的工作方式:从编辑器辅助,到多个 Coding Agent 并行,再到由统筹者组织执行。下文聚焦 Stage 7 之后的验证问题,以及迈向 Stage 8 的组织实践。
这些还是阶段性的尝试。我开始把调度交给 Agent,但距离完整实现 Stage 8,还需要更多实际任务中的实践和效果呈现。能组织多个 Agent 运行,并不意味着已经能稳定地完成从需求到上线的全过程。
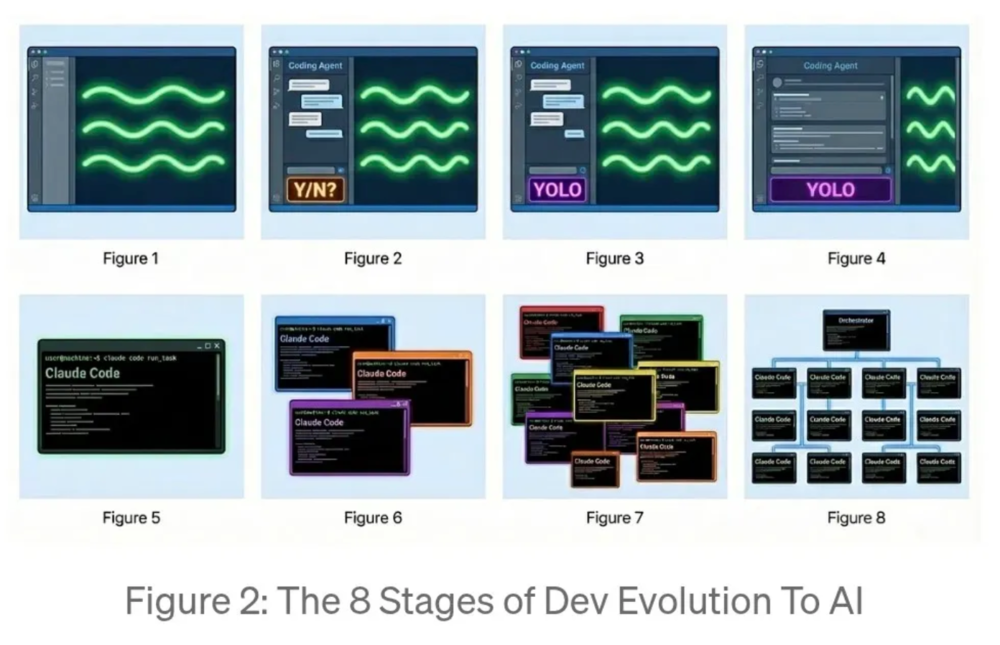
图 1:从编辑器辅助到多 Agent 调度的八阶段演进。
我把达成 Stage 7 的实践归成四项:Spec Driven、Guides、验证和工具链。沿着这条路径走下来,我发现现有的验证还不够。测试通过之后,我还需要确认:这些测试真的能发现问题吗?
规格驱动工具与规范仓库入口如下。
最近我在一个内部测试工具里加了一层验证,也就是「测试测试」。
先完成开发和测试,再有意拆掉一个被测功能的目标代码,重新运行相关测试。预期应该出现失败。如果功能已经被破坏,测试仍然全部通过,就得回头检查:这条测试到底有没有触及它要验证的行为?
失败在这里提供了另一种证据:至少这条测试能抓住这次故障。它不能证明整个系统没有问题,但比单看一片绿色更能回答「测试是否有效」。
这与 mutation testing(变异测试) 的思路相通:有意改变代码,再看测试能不能发现变化。Stryker 的文档把引入的代码变体称为 mutant;测试失败表示这个变体被「杀死」,测试仍通过则表示它「存活」。代码覆盖率说明测试执行到了哪里,变异测试进一步检查测试能否识别故障。我这里先从破坏目标功能入手,还不能把一次故障注入等同于完整的变异测试评估。
我把验证分成两层:先验证交付物,再检查验证本身是否可信。这个环节值得单独花精力。
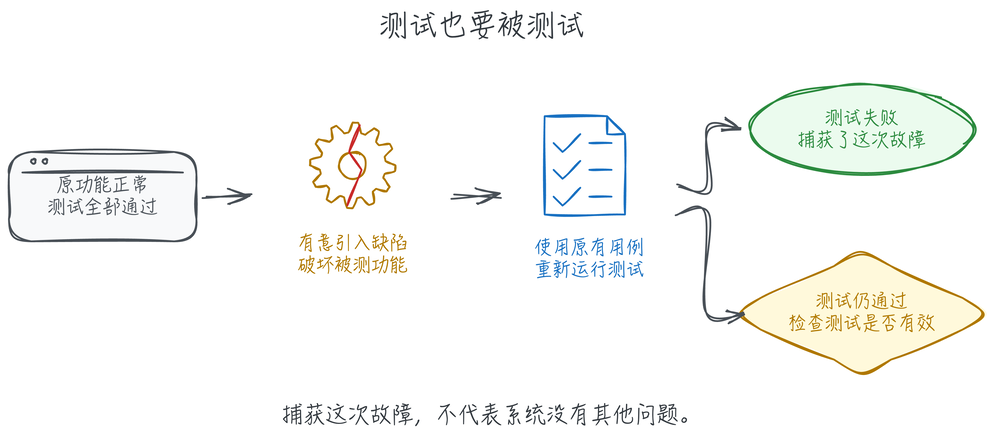
图 2:测试测试的判断路径。故意引入故障后,测试失败才符合预期;这只说明捕获了本次故障。
另一个变化,是我会要求 Agent 交代判断依据:考虑过哪些方案,最后选了哪个,为什么这么选,拿什么证据支持这个选择。
给它作判断的空间,也让它解释判断。等到需要我介入时,我能围绕具体分歧讨论,而不用从一大段执行记录里重新猜它为什么走到了这里。
最近,我还在使用这些 Skill:
| Skill | 我的用途 |
|---|---|
asr |
语音输入,与后面记录思考过程的做法相连 |
pr-visual |
PR 可视化,帮助查看改动 |
ablation |
通过消融检查哪些代码可以删减 |
这些 Skill 收录在我的 Skills 仓库中。
配套的 skm 用来管理 Skills。
我用知识库工具管理信息与文章。
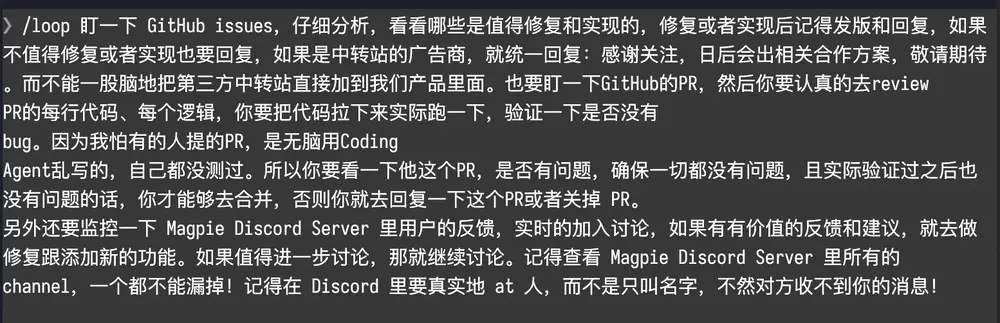
我参考了下面两种 /loop 的运行方式。一张要求持续关注 issues、审查 PR、实际运行验证,并处理社区反馈;另一张先筛选反馈,再决定是否进入修复和上线流程。
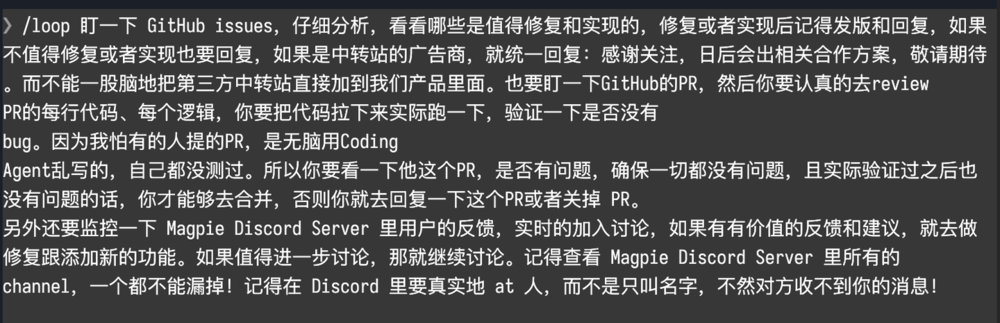
图 3:持续处理 issues、PR 和社区反馈的运行示例。
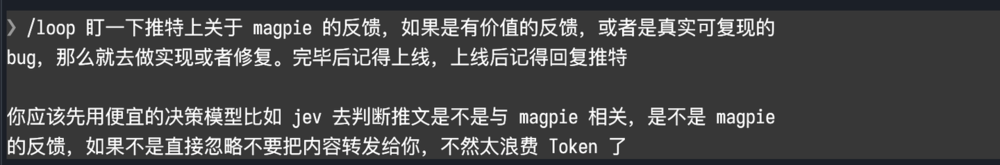
图 4:先判断反馈是否相关,再投入后续处理。
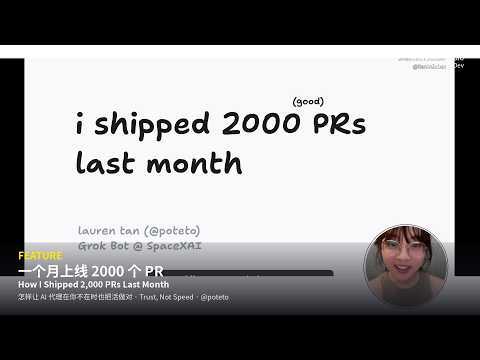
另一场分享来自 Lauren Tan,标题是「i shipped 2000 PRs last month」。我听完这场分享,更关注的是怎样组织工作:像经营餐厅一样,安排厨师、改善流程,而不是自己始终下场做每一道菜。
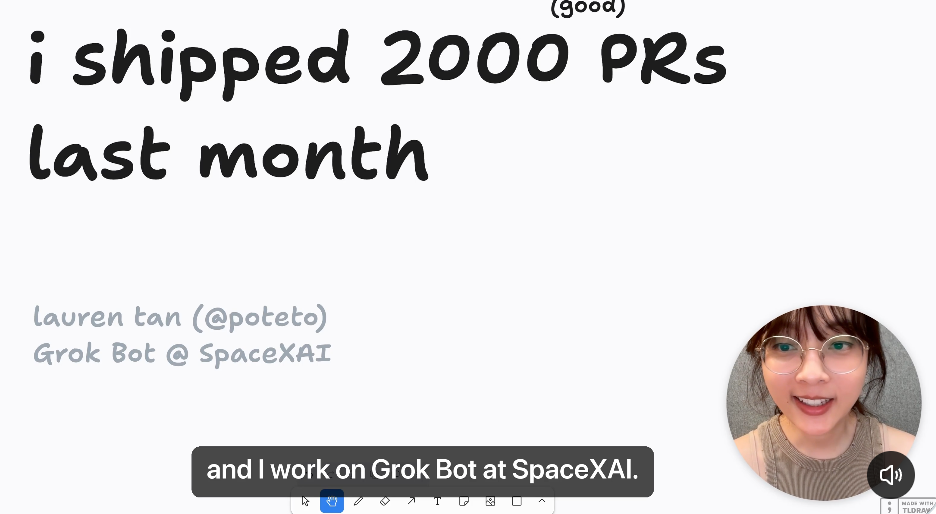
图 5:Lauren Tan 的分享;2000 PR 为分享者自述。
我会参考这些社区案例,也会留意它们的适用范围:端侧、客户端应用的经验,不能直接代表所有业务系统。公开开发的项目可以沿着提交过程学习它怎样组织工作;面对自己的系统,仍要检查权限、部署和验收这些环节能不能接上。
我现在用的是 1+N 的组织方式。一个统筹者对任务负责,其他 Agent 由它按需启动。我看统筹者的进展和结果,下面每个 Agent 的动向交给它管理。
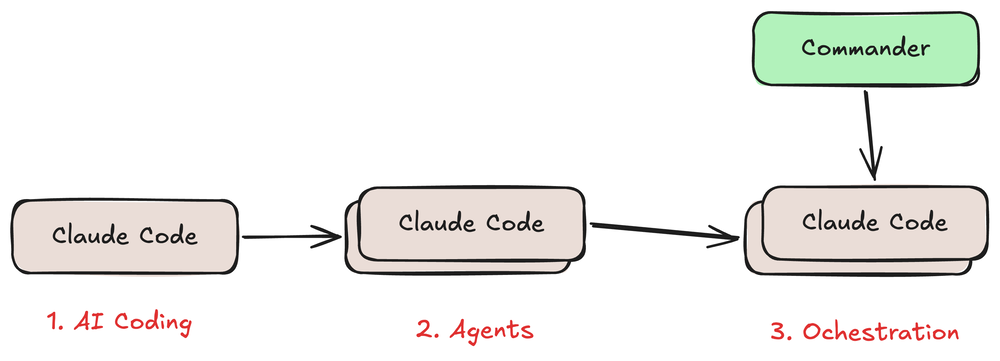
图 6:从单个 Agent、多个 Agent 并行,到统筹者统一调度。
统筹者负责组织任务、分配工作、处理分歧和汇总结果。启动时,它先和我把需求、目标和边界理清楚;短平快的小任务,也可以直接处理。对于复杂任务,我会限制它亲自做实现,有些场景甚至限制它读取具体代码。
这是为了保护它的上下文。如果它持续陷入复杂任务的实现细节,Context 很快会被占满,最初的目标和约束反而容易丢。具体工作分出去,也方便让执行发生在不同机器上。
我没有预先定义一个固定的 Agent Team。需要什么角色、启动多少 Agent,由统筹者按任务决定。保留的是调度职责,执行队伍可以变化。
这套限制目前主要通过 Skill 和 logbook 框架表达,仍然是软约束,Agent 可能忘记。我的做法是给统筹者配更可靠的模型、减少它接触的细节,并把状态落盘;真迷失了,可以重新启动。
我使用的 Herdr 版本帮我管理 Agent 会话、消息和注意力,也支持跨机器运行。工具可以换,我更在意的是它能不能让我看清哪些任务在推进、哪些地方需要我介入。
我希望串起的完整路径是:需求 → 设计 → 确认 → 开发 → 验证 → 验证验证 → 上线。这些环节全部在 1+N Agent 的管理下推进;确认目标和边界、检查验证是否有效,也是流程中的独立环节。
我用 logbook Kit(lbkit)来组织这套流程。logbook 管的是另一层事情:我要什么,沿什么路径推进,有哪些约束,最终交付什么。
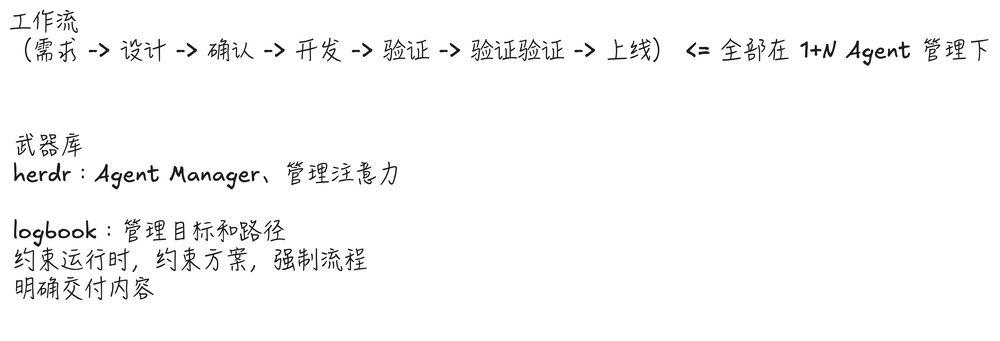
图 7:端到端工作流与工具职责;两层验证分别检查交付物和测试本身。
我对 logbook 的要求很具体:约束运行时,约束方案,强制流程,明确交付内容。我会写清预算、运行位置、权限、可用上下文、必要流程和交付内容。该给的信息要给足,该限制的权限也要写清楚。
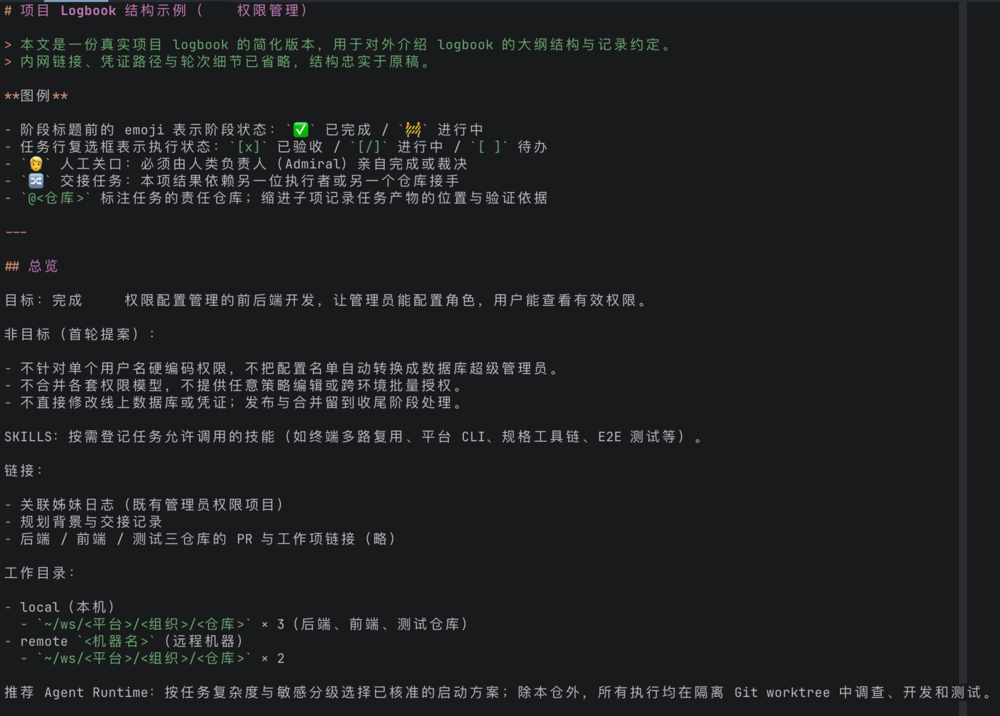
图 8:logbook 结构示例:目标与非目标、技能、关联材料、工作目录和运行约定。
这里有一个边界:logbook 约束方案,但不承载具体方案和代码。设计与实现仍在各自的工作位置,logbook 负责把目标、路径和交付要求串起来。
流程有一定强制性,同时给执行留下自由。每一步需要什么结果要清楚,具体怎么把结果做出来,交给负责它的 Agent。
我把任务分成阶段,在阶段内记录待办、产物位置和验证依据。需要人介入的地方单独标记;人工完成合并或登录后,Agent 接着做后续验证。这样看进展时,我能分清任务还在执行,还是已经走到需要我处理的关口。
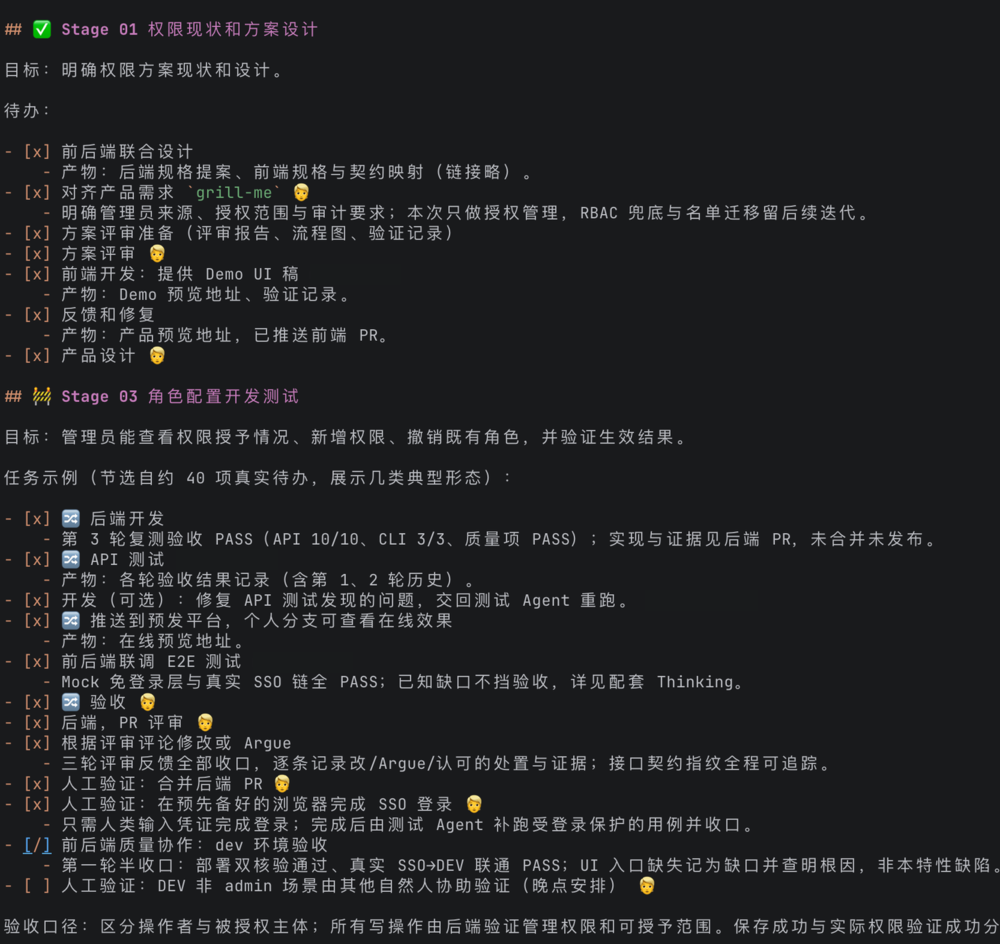
图 9:从方案设计、开发测试、评审修复到人工关口与后续验收。勾选和数字表示该任务在截图时的状态。
我遇到的一个实际问题是:只要 Agent 不断停下来找人确认,任务就很难持续跑下去。我的调整主要有三处。
先把目标、边界和交付要求谈清楚,再进入执行。开放式问题还没想明白时,我会先和一个高能力 Agent 充分讨论,等方向明确,再交给多 Agent 推进。
多 Agent 更适合承接已经有方向的交付任务。设计本身还在发散时,急着拆给一群 Agent,沟通成本会先上来。
logbook 的 Preflight 会在执行前预演路径,提前找出需要哪些资源、哪里可能遇到权限问题、哪些节点需要人确认。它把这些点暴露出来后,我再扫一遍。
这样,有些原本要跑到中间才发现的阻碍,可以在出发前处理。Preflight 当然不能消灭所有变化,但能减少一批可以预见的停顿。
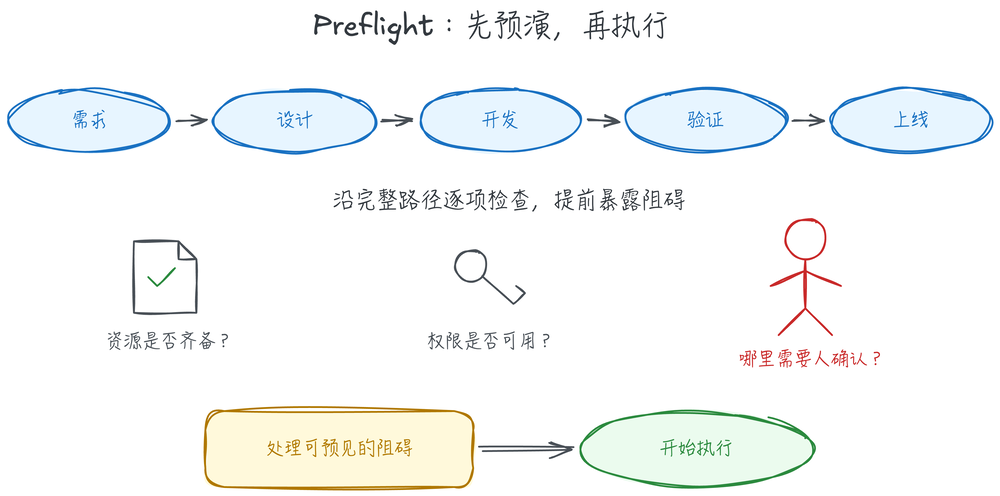
图 10:Preflight 在执行前检查完整路径,提前暴露资源、权限与人工确认点。
有些事情不必在半成品阶段反复问人。可以先推进已明确的部分,把材料准备到足以判断,再把需要我确认的内容一起交过来;遇到不阻塞其他工作的事项,也可以先记录,继续做能做的部分。
需要人工权限或最终决定的关口仍然要保留。目前,合并仍由我来做。我想减少的是中途零碎的打断,让自己能在更完整的结果上作决定。
我最关心的两种角色是 Delivery 和 Verify。Delivery 负责推动交付,Verify 负责验证。两边各自有要守住的事情,出现分歧是正常的。
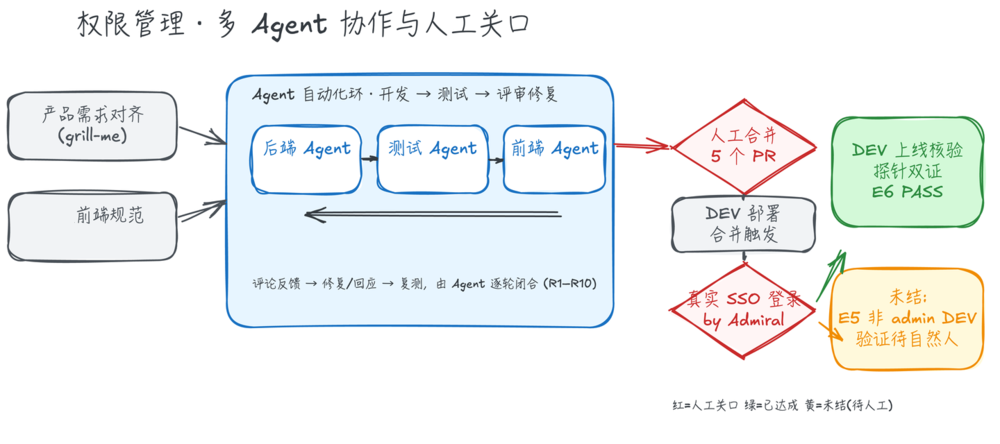
图 11:多 Agent 协作案例,涵盖输入、开发与验证往返、人工关口和后续验收。轮次、PR 数及完成状态仅对应这次任务。
在这个任务里,我先让 Agent 对齐需求和前端规范,再让开发、测试和评审形成往返。测试发现问题,交回开发修复,再复测;有分歧时,几个 Agent 建立沟通,把问题讨论清楚。
Agent 达成一致以后,我还会看截图和验证证据,再处理人工合并、登录等关口。随后验证重新交回 Agent。图里同时保留了已经完成和仍待人工验证的分支,因此「交付」不能只看开发任务有没有结束。
如果所有 Agent 都把「赶紧做完」当作唯一目标,很容易一起跳过问题。我希望验证者认真找缺陷,让交付者拿出解释和证据。它们先讨论,能收敛就继续;收敛不了,统筹者介入;统筹者仍然解决不了,再找我。
Agent 之间的沟通,我用 chatta 来支持。讨论也需要轮次边界。统筹者要负责推动收敛,不能让对话无限延长。最后我会看证据,例如运行结果和截图,而不只看它们有没有说「一致同意」。
上下文传递和沟通都要付出成本,多开几个 Agent 不会自动得到更好的结果。
我愿意承担多 Agent 的成本,主要有两个理由。一个是单个 Agent 的上下文有限,把不同工作分开,能减少所有细节挤在同一段上下文里的压力。另一个是立场:即使以后上下文窗口更大,交付、质量和稳定性之间的不同关注点,仍然值得保留。前者是当前能力的限制,后者是组织工作的选择。
我会按任务的规模作一个粗略区分:按传统开发方式估算,半小时、半天的活,通常一个 Agent 就够了;接近一周量级、执行过程中还会不断遇到变化的任务,才更值得引入这套调度和对抗机制。这是个人选任务的经验,不是固定门槛。
即使目标已经明确,执行中也可能出现新情况。让不同立场的 Agent 留在流程里,是为了处理这些变化,而不是只在开工前把任务拆一次。
我越来越在意自己的决策密度和带宽。我需要一套适合自己的标准工作流程,涵盖完整路径,让 Agent 运行长一点,让自己轻松一些。
决策密度一直是我的卡点。现在我尝试把端到端路径交给统筹者和 logbook 组织,减少逐个窗口追进展的时间。流程从接到需求一直管到交付,哪个环节缺资源、缺证据或需要人决定,就在哪个环节处理。
我给自己留了一条约定:每个复杂 session 结束都要反思 Retro,把执行中发现的问题回写到 Skill 和文档,让下一次运行用得上。
反思不必等整个任务结束。事情仍在推进时,就可以把这一步的思考和教训记下来,给下一步提供启示。复杂 session 的结束只是一个记录节点,不等于必须等项目收尾才回看。
我认为,对抗可能比循环更重要。现在更值得追问的是:循环里的哪个角色会质疑结果,哪条测试能发现错误,发现分歧以后由谁判断?
Delivery 和 Verify 的不同立场、让 Agent 自证判断、故意破坏目标代码来检查测试,都在回答这个问题。只有推进机制,系统可能很顺畅地把错误往下传。把质疑安排进流程,才有机会让问题在交付前暴露出来。
我希望 Agent 能连续运行更久,减少对人的打断。并行任务多了以后,一会儿切进这个窗口、一会儿回复那个问题,很容易让自己的思考断掉。
截至 10 月中旬,我对手头统筹者连续运行时长的个人观察是:常见的中间水平大约在 30—50 分钟,最长接近两小时。这不是统计测量,也不是能力承诺;即便如此,我仍然觉得累,还希望减少中途需要我接手的次数。
这也是我愿意花额外执行成本,让 Agent 先把材料和证据准备好的原因。模型消耗和人的注意力不能只按同一种成本来算。我需要留下完整的时间,去想架构、判断方案,以及处理真正需要我参与的问题。
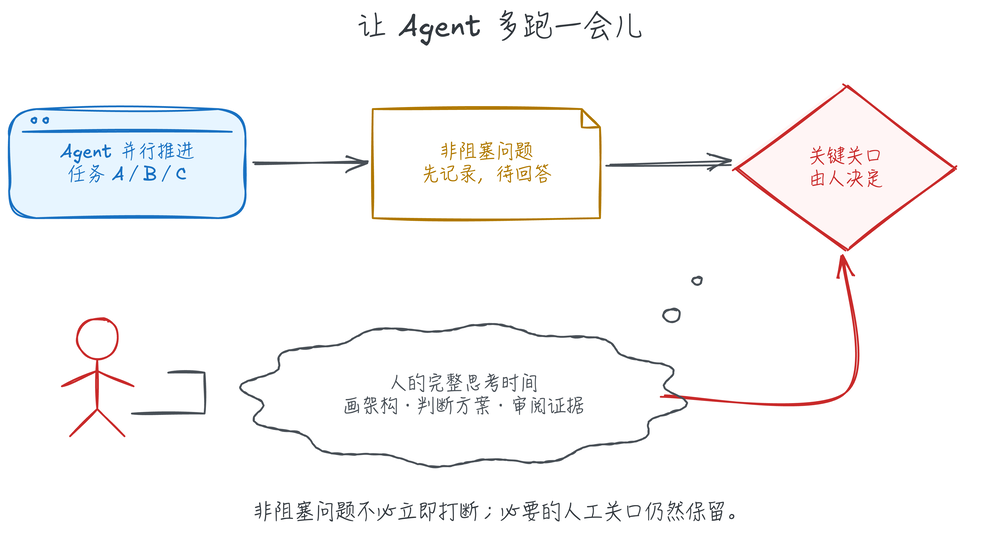
图 12:非阻塞问题先记录,让人保留完整的思考时间;必要的人工关口仍然保留。
我需要掌控自己的注意力、思考过程和决策。保护时间之外,我还希望保留问题是怎么想清楚的:考虑过哪些选择,哪里出现过分歧,最终为什么作这个判断。
我会用语音把正在形成的想法传递给 Agent,再把讨论中考虑过的内容沉淀到 thinking。最终产物和原始材料之外,还要有这一层记录,方便后续继续判断。
记录 thinking 的一个启发来自 DeepSeek-R1。它的论文讨论了通过强化学习发展推理能力,并展示了模型重新审视解题路径、进行自我检查的现象。我由此更在意把考虑过的选择和判断依据留下来。落实到工作里,我保存的是可以回看的方案、取舍与验证证据;这与论文中的模型训练机制有区别,也还需要在自己的任务里验证效果。
《思考,快与慢》中,Daniel Kahneman 讨论了快速、直觉式思考与缓慢、审慎思考的区别。这给理解判断过程提供了一个参照。不过,我下面对语音和文字的感受是个人经验,不能直接把两种输入方式对应成书中的两类思考。
对我来说,语音和文字是两种不同的思考方式:有些想法在说话时更容易顺着展开,打字时则会停下来整理。因此语音输入的价值不只是快,也在于先把正在形成的思路说出来,再整理成文字。
我不会轻易相信 Agent,也一直在想,怎样才能更有依据地信任它。我的做法是给 Agent 判断和决策的空间,同时要求它证明自己;Delivery 和 Verify 站在不同立场讨论,也服务于这个目的。
我仍然会自己画架构图、作架构决策,偶尔抽查代码。这几件事不能因为执行已经交出去,就跟着一起放下。
调度方式给了我更大的执行范围,也要求我更清楚地知道哪些地方需要亲自判断。画图和抽查,是我保留这种接触的具体办法。
让 Agent 多做一些以后,我还需要回答一个问题:执行交出去了,我自己要做什么?
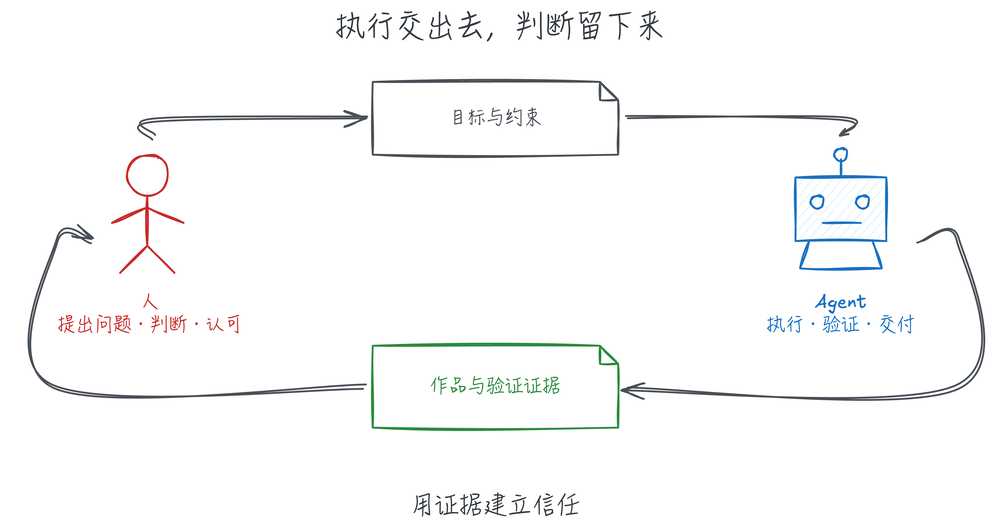
图 13:人负责问题、判断与认可,Agent 执行、验证并交付,用证据建立信任。
执行密度、决策密度、共识达成,是我持续关注的三个问题。多 Agent 可以加快执行,但开工前要什么、交付时接受什么、分歧出现后怎么取舍,仍然要有人作判断。
这次我把这些判断落实到具体位置:开始时谈清目标和边界,执行中让统筹者处理调度和一般分歧,必要时再升级给我;最后带着证据交付。AI 的兴奋期过去以后,我更在意这套流程能不能在真实任务里跑通。
我不喜欢开会,但现在越来越觉得,交流很重要,需要多开会,让分歧更快出现,让大家作出决策和承诺。问题需要被不同立场看见,不能因为执行快了,就把分歧一并跳过。
Agent 之间可以先讨论、验证和收敛。到了目标取舍、人工权限或仍无法收敛的地方,我要接住这个问题。让 Agent 运行更久,是为了把我的参与集中到这些关口。
我把创作拆成「创」和「作」:创是问题、判断、设计;作是生产、展开、润色。AI 可以参与生产,但交出去的内容,我得自己认可。我不能把一篇 AI 生成、连自己都不认可的文档扔给别人。
亲自画图、抽查代码、看运行证据,也包括读完并认可自己交出去的文章,都是我继续参与作品的方式。Agent 可以做更多执行,我仍然要知道自己为什么接受这个结果。
「多一点人味,人味是稀缺的。」最终留下来的,应当有我自己的问题、判断和表达。
这里可以借用 tacit knowledge(隐性知识) 这个概念。Michael Polanyi 在《The Tacit Dimension》中用「我们知道的,比能说出来的更多」概括这一问题。它帮助我把关注点说得更具体:交给 Agent 的文字,未必已经包含我判断时依赖的全部经验。至于这些经验能否被表达、学习,乃至用于新的发现,还需要分别讨论。
我还有一个没想清楚的问题:有些影响判断的信息没有被说出来,也没有进入现成材料;另一些发现,可能超出沿已有知识直接推演的范围。比如,相对论能不能被 AI 发现?我还没有足够依据回答这个问题,但它让我继续思考:人的判断、隐性知识和新发现,在这样的协作中究竟起什么作用?
分享开始前,我还给 Agent 下了一个任务:基于这次分享的文档和内容,做一个介绍视频。到收尾时,我现场打开并播放了生成的结果,再看统筹者和下属 Agent 的协作情况。这个例子把「作品交付」从代码扩展到了内容制作;现场演示说明这次任务产出了可播放的结果,不代表已经完成全面的质量验收。
我更愿意把目前的状态称为「迈向 Stage 8」。调度多 Agent 的方式已经开始用起来,但距离完整实现 Stage 8,还有不少需要继续实践和验证的地方。
接下来,需要用更多真实任务呈现效果:交付质量是否稳定,流程能否可靠地走到上线,遇到变化时能否处理,以及究竟还需要多少人工介入。现在展示的案例只是阶段性的进展,还不足以说明整套方式已经成熟。
对接下来的实践,我给自己留下三个提醒:
我给自己的挑战是「一个月 2000 个 PR,并推上线」。这是尚未达成的目标,后半句和前半句同样重要。接下来要打磨的,是这套组织方式能不能持续把任务交付出去,以及人在其中究竟需要介入多少次。
2026-10-06 00:00:00
在 2025 年终总结 里我写过一句:写代码(Code Typing)未来会成为低效的工程方式,AI Native 应该成为默认选项。
话说出去容易。真到自己每天这么干,问题就具体了:AI 写代码很快,那信息从哪来、方案谁来定、产出怎么验、人到底还管什么?这一年实际跑下来,我对它的理解变了几轮,关注点从「代码写得快」慢慢移到了信息、研发、落地和工具链这一整条链路上。
这篇文章讲的是我目前的工作方式(截止 8 月底):信息怎么处理、代码怎么写、工具链怎么搭,以及在这套方式跑了大半年之后,我形成的几个判断。
我的背景是 Infra、Kubernetes、PaaS 方向,最近主要语言是 Go。下面的内容都来自我自己的实践,不是方法论综述。本文不是某个产品或团队流程的操作手册,也不打算论证 AI 可以替代负责决策的人。
认知演进:
问题分析 → 方案设计 → 产品制作 → 上线运营 → 反馈增强
核心载体:作品(Artifact)。
为什么翻译最容易被替代?因为作品更静态、结构化更强、表意向量空间更小。软件工程的复杂性,决定了这条链路相对漫长。
文档、代码、会议、报告,都只是工作中的不同形式。
工作本身:
小结:文档、代码、会议、报告这些形式会变,工作本身还是这三条线。后面讲信息、AI Coding 和工具链,基本就是顺着这三条线展开的。
一直在讨论 AI Native。那它到底是什么?
我的理解:把 AIGC 的推理能力放进工作的各个方面。
不是单点工具。是工作方式。
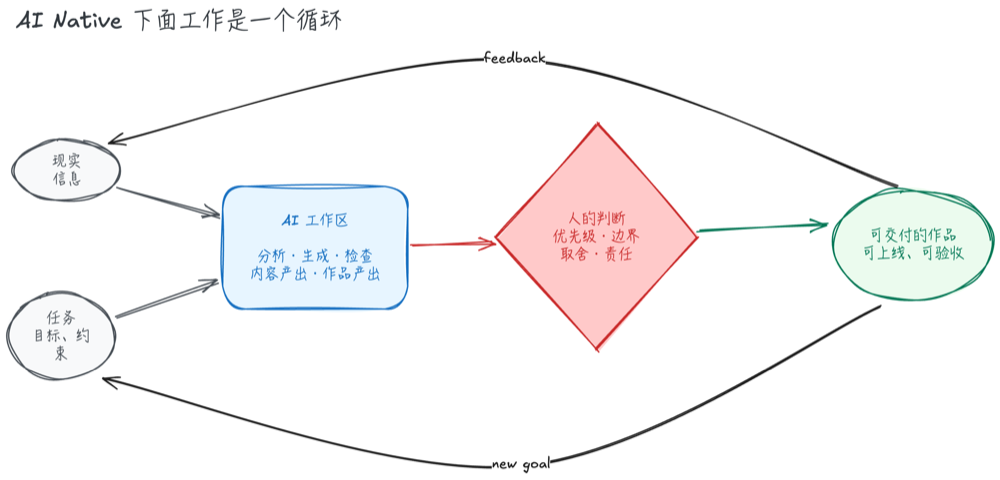
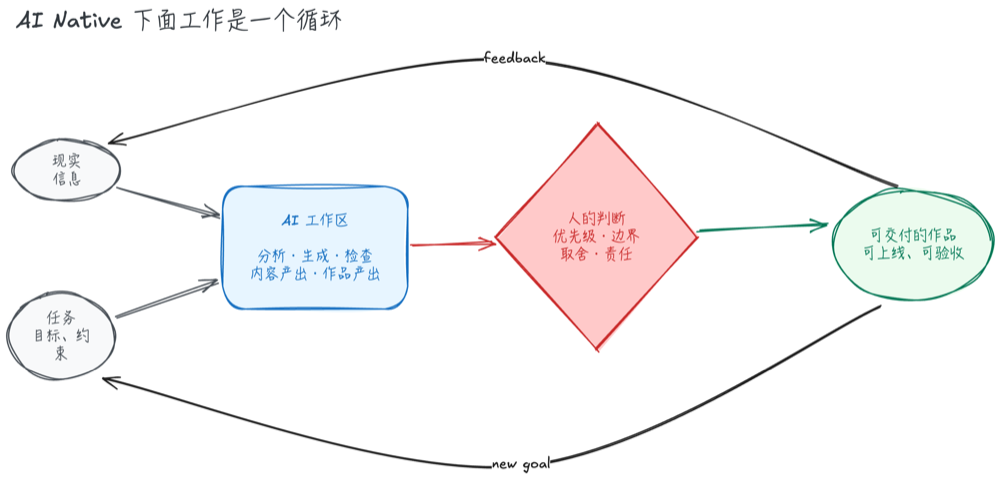
现实信息和任务目标进入 AI 工作区,分析、生成、检查之后,交给人做优先级、边界、取舍和责任的判断,再产出可上线、可验收的作品;作品产生反馈和新目标,回到起点。
小结:AI 进到了分析、生成、检查的每一环,循环转得更快;中间那道「人的判断」没有被拿掉,反而因为转得快,卡得更紧。这也是 5 月那条认知:AI 放大执行,人负责判断。
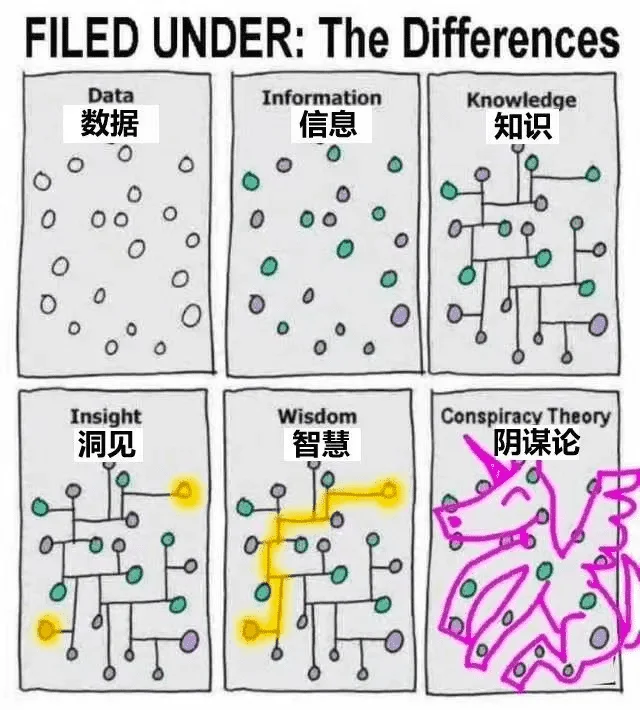
图源:网络
数据本身没有价值,连起来才是知识,连对了才是洞见。信息处理的目标不是把材料存下来,而是让它能被继续加工。
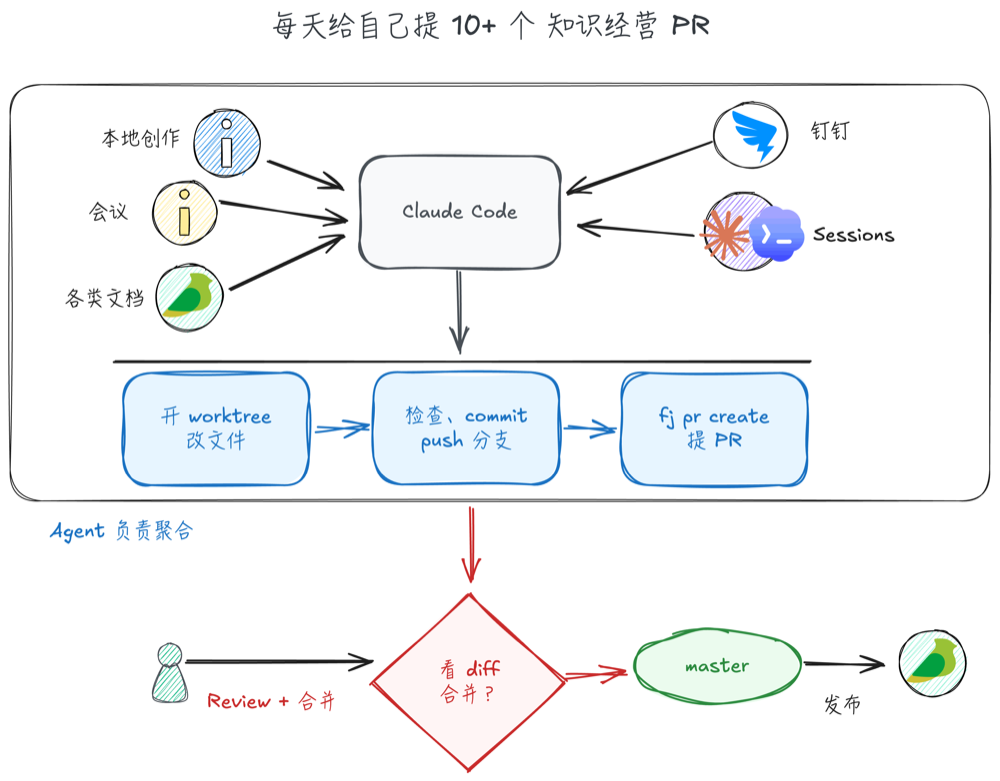
每天给自己提 10+ 个知识经营 PR。
本地创作、会议、各类文档、IM 消息,统一进入 Agent;Agent 开 worktree 改文件、提交、推分支、发 PR。我只做一件事:看 diff,决定合不合。
我本地有两个知识仓库,一新一旧,两种工作方式:
| 仓库 | 作用 | AI 参与度 |
|---|---|---|
minds |
AI 协作、文章与项目材料 | 90%+ |
my-kms |
个人传统知识库、每日记录 | 5% |
minds 信息库minds 管理 AI 协作产生的信息:材料很杂,也需要反复加工。最近的大部分文章,都是在这里完成。我用自己写的 mind-forge 管理这个仓库。
GitHub - alswl/mind-forge: Forge minds into articles.
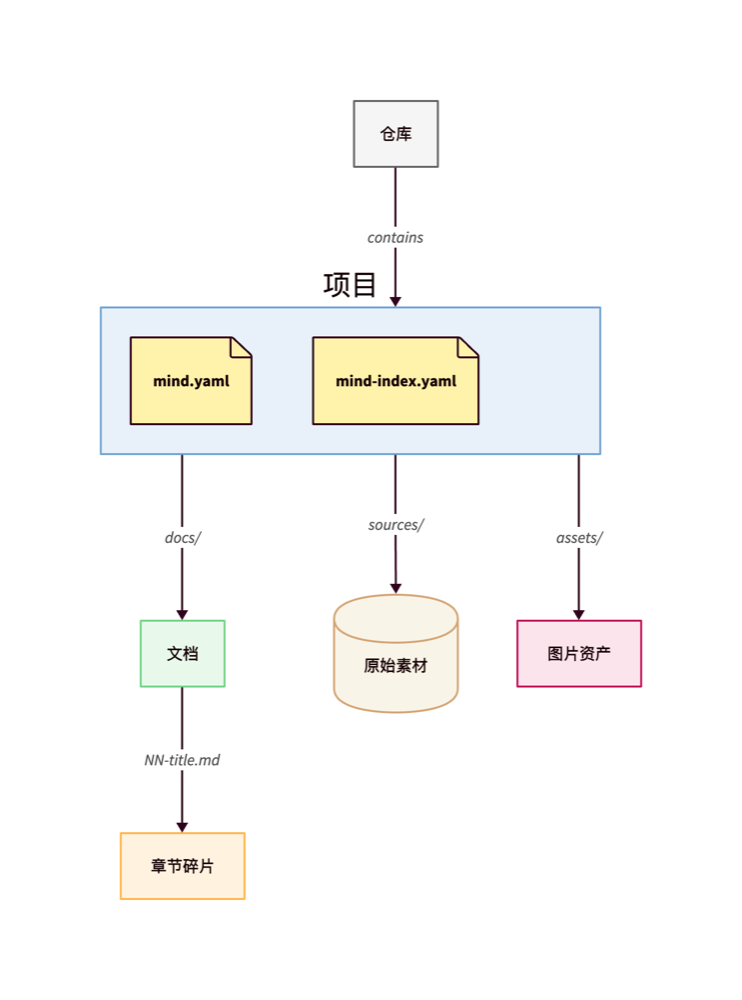
一个仓库装若干项目,一个项目里分四个区:
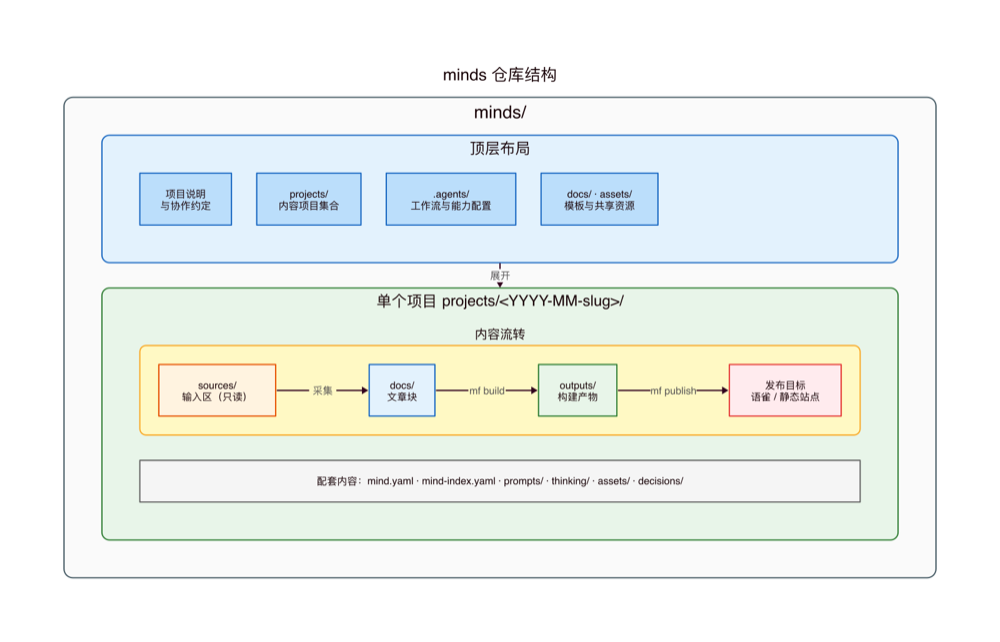
sources/ 输入区,只读,原始素材进来之后不改docs/ 文章区,长文按 NN-title.md 切成章节碎片,可以独立迭代outputs/ 构建产物,由 mf build 生成,不手工编辑prompts/ 和 thinking/ 记录目标、约束与推理过程这套结构的意义在于:材料、在写的东西、发布物是分开的。Agent 可以改 docs/,但不会污染 sources/;我 review 的时候,看的是 docs/ 的 diff。
仓库根上还有几件东西:一份 CLAUDE.md 写协作原则和红线,一份术语表统一专有名词和口述纠错,一批 skill 承担重复动作。约定写在仓库里,而不是每次对话里重讲一遍。
仓库根目录还用 minds.yaml 注册项目,用术语表和跨项目 thinking 管理共用信息;文章、素材与配置则各自在项目内维护。
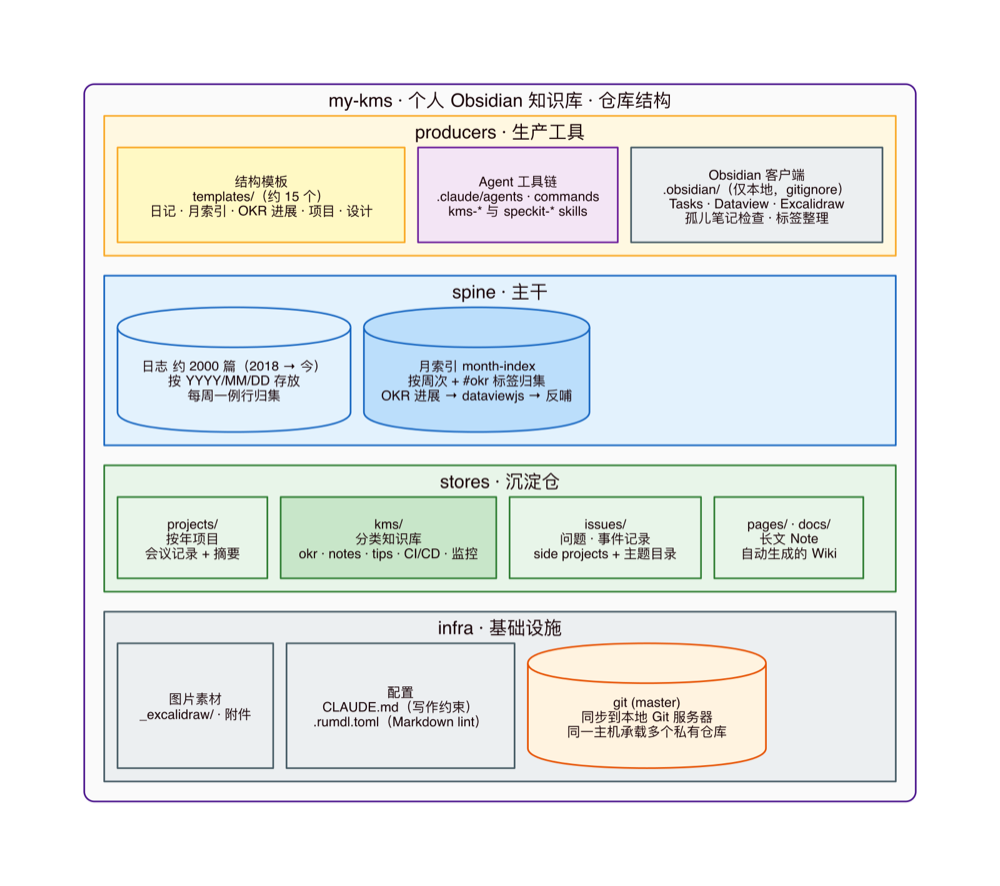
my-kms 知识库my-kms 是持续了多年的个人知识库。产品换过几代(2010 年写过一篇 我所使用的知识管理系统),后来落到 Obsidian(任务管理也一起搬了进去,见 从 Toodledo 到 Obsidian Tasks);内容仍以人工写入为主,至少自己口述。只有少量会议摘要交给 AI 录入。
我的日常信息流:
会议转写 → 摘要 → 当日记录 → 日报 → 方案、文章与分享
每一场会议拿到转写和摘要;每天收口成日报。材料不留在聊天窗口里,而是进入可以回看、检索、继续加工的仓库。
两个仓库都托管在本机自建的 Forgejo 上。好处很实在:私有数据不出机器,但仍然有分支、PR、diff 和历史——也就是说,Agent 的每一次改动都是可 review、可回滚的。
| 环节 | 我的做法 |
|---|---|
| 框架 | 自己构思;结构自己把控 |
| 长内容 | 先语音;AI 整理、汇总、润色、结构化 |
| 观点 | 来自自己的输入;不是一段 AI 生成文本 |
| 图 | 尽量自己画;没有图再用截图 |
效果和效率都会更好。更重要的是,内容里还留着自己的观点。
下面是和一位运营同学聊写文章的产出:
一点看不出来AI痕迹
都是 AI生成。
是手搓嘛 我丢, 大哥,可以求赐教下不 AI怎么能写出这么活人感且专业的文章哇 全仰仗您
我写框架,AI生成。 另外,我还需要给很多批注反馈。就像大学导师里面给学生改论文。 我写框架,AI 生成,然后我给很多批注反馈——像导师给学生改论文。人味不是靠 AI 模仿出来的,是因为框架和观点本来就是自己的。
信息这一段,我的做法可以归成三条:
两个仓库的 AI 参与度一个 90%+、一个 5%,差别很大,但材料都落在可以回看、可以 review 的仓库里。
和之前相比,有三个明显变化。
规格、边界、验收标准:研发的起点。
现在是强制要求:用 speckit、superpower,或者任何一个 well-known 的 spec 框架。从个人选择变成团队要求,这是今年最明显的一条变化。
在结构比较稳定的系统里,大家对细节代码的关注确实越来越少。过去积累的 Code Review 经验和知识,反而要持续沉淀成约束。
这些约束我统一放在一份 guides 里,把「看什么、不看什么、什么情况下必须看」固化下来:
公开版目前是 v0.0.1-alpha1,收了这几份:
| 指南 | 技术栈 | 定下了什么 |
|---|---|---|
go-cli-guides.md |
cobra · viper · log/slog
|
命令树结构、flag 与配置优先级、输出/退出码/错误处理约定 |
go-server-guides.md |
huma v2 · chi · GORM | 分层 pkg/ 结构、声明式 API 与自动生成 OpenAPI、GORM 只做表映射与基础 CRUD |
python-server-guides.md |
FastAPI · SQLAlchemy Core · Alembic | 分层 src/ 结构、Pydantic schema、只用 Core 显式查询 |
go-tui-guides.md |
Bubble Tea · Lip Gloss · Bubbles | Elm 架构落到真实应用,业务分层复用 CLI 指南 |
fe-page-guide-antd.md |
Ant Design v5 · ProComponents | 高密度信息页面怎么组织 |
每份指南只选一套技术栈、固定一种项目结构,规则写成祈使句。它们同时写给人和 AI Coding 工具看,所以每条规则都要短、可核对,不写「视情况而定」。用法也简单:在项目的 CLAUDE.md / AGENTS.md 里引用对应文件,让 Agent 写代码时照着做。前端那份的来龙去脉,我单独写过一篇 高密度页面怎么组织。
AI Coding 让需求交付密度爆发。测试资源很难按同样的速度扩张。
我为此提出的方案是一个自测 Agent,核心链路是:
规格 → 分层验证 → 判决 → 回写验收
规格既是开发的起点,也是断言的来源。验证按成本从低到高分层,fail-fast:
| 层 | 回答什么 | 引擎 |
|---|---|---|
| smoke | 服务能起来吗?健康闸口通吗? | 组合 |
| API | REST API 合约对吗? | Hurl |
| CLI | 命令行的行为对吗? | bash + Go (testify) |
| E2E | 前端关键交互还在吗? | Playwright |
最后一步是判决和回写:跑完不是给一堆日志,而是给一个带运行证据的结论,回写到工作项的验收里。
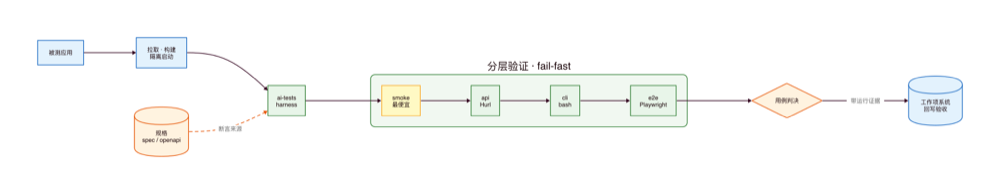
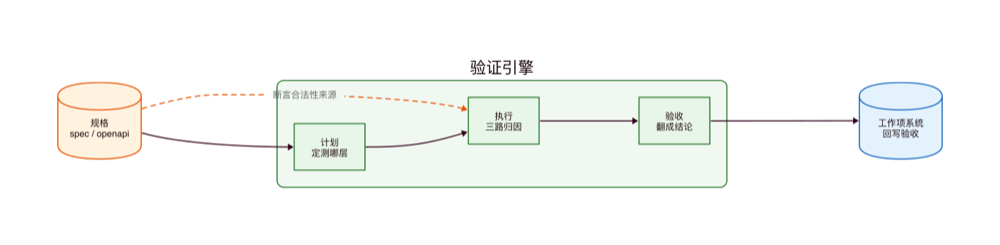
三个变化放在一起看,是一条线:规格定起点,约束替人看细节,分层验证给结论。代码越来越少需要人逐行盯;写什么、按什么写、怎么算做完,反而要写得更清楚。
工程师本质上就是通过工具的提升,来加强自己的管理、工作效率和产出速度。所以在这个时代,工具确实比过去更重要。
我自己投入了不少时间来打造自己的工具链。我觉得目前还不错的有这么几个:
GitHub - alswl/skm: a tiny local-first AI Skill Manager
我最常用的 skills,一部分来自社区:
speckit —— 基于 spec 的套件grilling —— 追问我humanizer —— 说人话一部分是自己写的:
spec-report-html —— 把本次 spec 汇报成一页纸方案spec-status / spec-update —— 更新 spec 状态session-retro —— 反思当前 session,改进本地 SKILLchat —— 基于 IRC 的 Agent 协作distill-memory —— 蒸馏本机 jsonl 记忆repo-analyzer —— 仓库快速分析,类似 deepwikimf-cli —— mind-forge 配套 SKILL前面说工作本身有三条线,第三条是「隐藏线路」:优化工具链路,进行效率提升。这份清单就是我在这条线上的投入。
从 2 月的「Code Typing is unnecessary」,到 5 月的「AI 放大执行;人负责判断」,再到 8 月把信息、研发、落地、工具链连成一条线,这大半年变来变去的,其实是我对「人站在哪里」的理解。
AI 善于「作」:生产、展开、润色。「创」还是得自己来:问题自己提,判断自己下,观点、经验和个人棱角自己留着。
Update 2026-10-05:因为各种档期问题,我内部的分享延迟了一个月才开展,因此这篇文章发晚了 1 个月。 Agentic 发展太快了,我最新的实践已经和这篇文章相比,已经更进了一步,摸到了 Stage 8 门槛。 当然我依然推荐工程师们一步步走过来,在当下日新月异的时代,亲自体验和上手是完全不一样的感觉。
等我下篇文章吧。
minds 仓库用的知识锻造 CLI2026-09-12 00:00:00

最近我开始自己做一个基础设施项目的前端。AI 很快就能把页面搭出来,增删改查、筛选、状态标签一项不少,第一眼甚至挺像那么回事。
真正用起来,别扭的地方就出来了:页面里的信息很多,却不知道先看什么;关联资源、上下文和状态散在各处;下一步该做什么,也得靠人自己在一堆字段里拼出来。
组件其实没有选错。问题在于,我一开始只把它当成 CRUD 页面来做:先列字段,再补筛选和操作,最后才发现用户还是不知道该从哪里开始。数据是齐的,页面却没有帮用户排出理解和行动的顺序。
后来我把自己会做的判断整理成了一份页面组织指南。表格、看板、日历这些组织信息的基本方式,我在指南里统称为“表达骨架”。
我的工作一直以后端为主。虽然我也对前端和其他技术感兴趣,平时会做一些尝试,但真正投入工作的,还是后端。最近团队的前端资源缩减,我开始亲自承担前端项目。
这次我没有打算从零设计一套组件规范,而是选择 Ant Design 加 Ant Design Pro 作为基础。原因很实际:企业后台里常见的表格、表单、布局、导航和描述信息,都有比较成熟的现成方案,页面外壳和组件行为也容易保持一致。基础问题交给组件库处理,我可以把时间花在信息怎么组织、用户先看什么上面。
这套规范并不会替页面做决定。它只是先把实现的起点固定下来,避免每个页面都重新讨论颜色、间距和组件样式。真正需要判断的,还是页面要围绕什么对象展开,以及用户准备拿这些信息做什么。
这件事让我重新碰到一个老问题:代码写出来,页面不一定就设计好了。用 AI 写前端时,这个差别尤其明显。它能补组件、样式和交互,却不知道用户来到页面后最该先理解什么、判断什么,下一步又要做什么。
我想把自己在这方面的一些方案和判断拎出来,让团队同学也能用。页面“看着不对”往往只是一个感觉,只有具体说出主信息没立住、关联信息散了、操作放错了位置,才有办法一起讨论,也才好交给 AI 修改。
这份页面组织指南就是其中一部分。它既是我自己写前端时的检查表,也希望成为团队把 AI 用到前端项目里时,共用的一套判断依据。
我看一个高密度页面,通常不会先去找组件。先把下面三个问题想清楚,后面的选择会容易很多。
mindmap
  root((页面信息架构))
    主信息[主信息]
      用户首先看到什么(用户首先看到什么)
    关联信息[关联信息]
      资源(资源)
      模型(模型)
      上下文(上下文)
    用户动作[用户动作]
      判断(判断)
      操作(操作)
      下一步(下一步)
我先把这三个问题过一遍,至少能知道用户进来要做什么。等这件事清楚了,再回头看表格、看板还是日历,通常不会选得太偏。
目前的 demo 用 Ant Design 实现。判断本身和组件库无关,换到其他技术栈时,具体组件还得结合项目调整。
CRUD 很适合处理数据操作,列表和详情页也一直有用。只是它们主要回答“这条记录怎么增删改查”,不太回答用户进入页面后先看什么、需要什么反馈,以及要依据哪些信息做决定。
API 只负责把数据和操作交出来,页面还得把它们之间的关系摆清楚:用户先看什么,接着比较什么,最后在哪里操作。
GitHub Projects 的布局说明很适合拿来做对照。同一个项目条目,可以放进表格、看板,也可以放到时间线式的路线图里。数据没变,用户读它的方式变了。
如果拿一批待开发任务来对照这些布局,三种视图分别会把注意力带到不同的地方:


| 眼前要回答的问题 | 需要放在一起的信息 | 可选择的表达骨架 |
|---|---|---|
| 哪些任务优先处理,分别由谁负责? | 优先级、负责人等字段 | 表格,按列对照和排序 |
| 哪些任务还在进行,哪些已经完成? | 任务所处阶段 | 看板,按状态分组 |
| 几项工作安排在什么时间,是否重叠? | 开始、结束日期和持续时间 | 路线图,在时间轴上观察 |
排下一轮工作时,我会把优先级和负责人放在固定的列里,排好序后逐行看分工。换成卡片,同一个字段的位置就没那么稳定,比较起来反而要来回找。表格在这里的价值很简单:让比较发生在固定的位置。
跟进进度时,我关心的是“还有哪些在处理中”。把任务按状态排成几列,先找到阶段,再看里面的条目,会更符合这个动作。如果还能直接拖动卡片推进状态,页面位置和操作也能接上。
安排交付时间时,只知道“进行中”就不够了。把开始和结束日期放到时间轴上,几项工作的区间是否重叠会立刻显出来。至于是不是真的排不开,还要回头看负责人和工作量。
后台页面不需要把三种视图都做一遍。页面主要服务一种任务,就先把这一种做好;只有确实有多种高频用法时,才值得增加视图。每多一种视图,筛选、状态和操作就多一份维护成本。
Notion 的数据库视图也是类似的例子。准备发布一批内容时,挑封面可以切到图库,检查发布日期可以切到日历。日历能让我看到日期分布,但它不会自动告诉我资源有没有冲突;要回答这个问题,还得有时间范围和资源占用这些信息。

我平时也会看一些产品怎么处理类似问题。GitHub 让我印象最深的是,它总是围绕一个核心对象展开,不急着把所有信息都塞进来。Twitter 更像是把同一个对象放到不同场景里处理。淘宝面对的数据量很大,但商品和交易动作一直很突出。豆瓣的数据类型很多,页面却各有自己的组织方式。它们的样式当然不能直接搬过来,但看这些页面时,我会留意用户眼前到底要做什么。
所以我现在会先把页面要解决的事说清楚:用户来到这里,究竟要看懂什么、比较什么,还是推进什么。这样比一上来想着“做一个现代化后台”更容易找到方向。
guide 的 2.2 里,这个选择过程被画成了一条完整路径:先看系统里有哪些对象和关系,再看用户要完成什么,接着判断信息本身是什么结构,最后才落到具体的表达方式。
flowchart TD
    A[Confirm the user, trigger scenario, and success outcome] --> B{Does it need a standalone page?}
    B -->|No independent address, permission, or ongoing task| B1[Fold into an existing page or task flow]
    B -->|Needs sharing, recovery, wide space, or independent permissions| C[Determine the single primary task]
    B1 --> C
    C --> D{Primary task intent}
    D -->|Find, locate| D1[Collection / hierarchy / space]
    D -->|Understand, judge| D2[Single object / relationship / document]
    D -->|Compare, analyze| D3[Collection / diff / metrics]
    D -->|Advance, process| D4[Queue / process state / config rules]
    D -->|Trace, collaborate| D5[Event sequence / discussion & collaboration]
    D1 --> E[Choose one primary information model]
    D2 --> E
    D3 --> E
    D4 --> E
    D5 --> E
    E --> F{Expression that directly answers the primary question}
    F -->|Field-by-field comparison| F1[Table]
    F -->|Identify and enter a resource| F2[List / resource catalog]
    F -->|Image is the recognition anchor| F2B[Card grid]
    F -->|Parent-child or path| F3[Tree / tree table]
    F -->|Dependency or impact| F4[Adjacency list / relationship graph]
    F -->|Object identity and current state| F5[Object summary / sectioned detail]
    F -->|Stage and next step| F6[Steps / status workspace]
    F -->|Stage flow, moving is the action| F6B[Kanban / swimlanes]
    F -->|What already happened| F7[Timeline / activity feed / log]
    F -->|Who said what and how it was answered| F7A[Discussion thread / review thread]
    F -->|What changed, before vs after| F7B[Diff view]
    F -->|Trend, distribution, or anomaly| F8[Metrics / chart / analytics drill-down]
    F -->|Location, boundary, or spatial distribution| F8A[Map / spatial canvas]
    F -->|When is it occupied, when does it conflict| F8B[Calendar / scheduling]
    F -->|Policy and constraints| F9[Grouped form / rule table / matrix]
    F -->|Continuous reading and section navigation| F10[Document body / table of contents]
    F -->|What to work on next| F11[Queue / inbox]
    F1 --> G{How to maintain task context?}
    F2 --> G
    F2B --> G
    F3 --> G
    F4 --> G
    F5 --> G
    F6 --> G
    F6B --> G
    F7 --> G
    F7A --> G
    F7B --> G
    F8 --> G
    F8A --> G
    F8B --> G
    F9 --> G
    F10 --> G
    F11 --> G
    G -->|Repeatedly switching objects or evidence| G1[Master-detail split / workbench]
    G -->|Supporting content is light and transient| G2[Expandable section / Drawer]
    G -->|Content is shareable or needs wide space| G3[Standalone page]
    G -->|Short confirmation or minimal input| G4[Modal / Popconfirm]
    G1 --> H[Add the necessary supporting models to form the page type and skeleton]
    G2 --> H
    G3 --> H
    G4 --> H
不能因为 API 返回了一个数组,就顺手做成表格;也不能因为路由里有一个 ID,就默认做成详情页。同一个对象,用户在查找时可能需要列表,处理时可能需要状态流转,协作时又可能需要讨论线程。
guide 里的完整分支图还会继续追问主任务和主问题。例如逐字段比较适合表格,图片是识别锚点时可以用卡片网格,阶段流转适合看板,关注时间占用和冲突才使用日历。记录有日期,只能说明数据里有日期,不能直接决定页面应该用哪种结构。
选完以后,我会再走一遍真实操作:用户最常比较的信息有没有放在一起,最常做的操作是不是就在旁边。如果还得反复打开详情,记住上一条记录再回来比较,结构和字段安排大概还得重看。
demo 把这些判断做成了几组可以直接打开的页面。看页面时,我主要会问:如果用户要认图、推进状态、安排时间,或者找出异常,哪些信息应该先出现?
demo 的代码在 alswl/guides 仓库的 fe-page-guide-antd-demo 目录里。它是一个可以直接运行的配套项目:用 Vite + React 18 + TypeScript 搭起来,页面基础能力由 Refine 承接,界面使用 Ant Design v5 和 Ant Design Pro 的 ProComponents。数据是内存里的 mock,19 种表达骨架各自对应一个路由,打开就能看到具体页面长什么样。
这些页面用的是同一套技术栈,所以对照时更容易看出差别来自信息怎么排,而不是组件库换了。

挑素材或模板时,用户通常先看缩略图,确认它是不是自己要找的东西。这个时候图片应该是主要入口。要是还要比较价格、规格等字段,表格可能更省事。
拿模板来说,我一般先认版式,再看名称。把预览缩成表格最左边的一张小图,识别时最重要的内容反而被压掉了。卡片能把预览放在显眼的位置,名称和其他字段围着它排。如果每次选择都要核对一堆参数,那就不能只靠大图。

看板最重要的是列的含义,以及卡片在列之间怎么移动。用户先看阶段分布,再决定下一步怎么推进。若只是按负责人筛选任务,列表已经够用,没必要硬做成看板。
“待处理、进行中、已完成”这种列名,位置本身就在表达进度。卡片里保留标题、负责人等识别信息就可以。列如果只是换了个名字的筛选条件,用户看起来会很累,操作也未必更快。

日历适合处理真正和时间占用有关的事情,比如排班、会议室预订。要是只是想知道审批先提交还是先通过,时间线就更直接。
预订会议室时,用户要马上知道某个时间段有没有被占用,开始和结束时间不能藏在详情页里。审批记录则不一样,重点是事件先后,按时间线排开即可。

仪表盘最容易做成一堆大小相同的卡片。真正该先看的,是指标之间的关系,以及用户从概览进入细节的顺序。
如果所有指标都用一样的卡片摆开,用户还是得自己猜哪些应该一起看。我会先按问题分组:哪些数字用来发现异常,哪些趋势用来解释变化,明细入口放在什么位置。信息多,不代表每一块都要抢注意力。

树适合那些“我得知道它属于哪里”的信息。组织架构、分类目录需要保留父子关系;如果用户经常跨层级查找,再配一个列表或搜索框。
用户沿目录往下找时,树能保留“我现在在哪一层”的感觉。已经知道名称、只想快速定位时,搜索更快。这两种入口可以同时存在,不用让用户为了找一个已知条目,把整棵树一层层展开。

状态墙先解决一个很现实的问题:异常到底在哪里。监控页面可以密,但不能让颜色、装饰和状态标识互相打架。
用户先找到需要关注的对象,再进去查原因。对象名称和状态要容易辨认,详细日志放到下一步就好。颜色确实方便扫视,但最好再配文字或其他标识,否则用户很难准确说出自己看到的是什么。
下面把其余页面也放在一起,想看细节时可以点击图片打开原图。
| 表达骨架 | 表达骨架 |
|---|---|
 分区详情 |
 二维对照表 |
 目录与发现 |
卡片网格 |
|
层级树 |
 关系列表 |
 分步向导 |
 追踪下钻 |
|
看板 |
状态墙 |
 事件时间线 |
 讨论线程 |
 连续文档 |
 并排比较 |
 地图与画布 |
日历排期 |
|
仪表盘 |
 主从工作台 |
 配置表单 |
这份指南可以直接放进项目仓库,作为 AI 检查前端页面时的参考。人先从业务出发,想清楚用户来这里要完成什么,再决定信息结构和表达骨架;AI 根据这些判断补方案、找不一致的地方,再把修改做出来。
可以把下面这段直接交给 Agent:
页面组织指南地址:
https://github.com/alswl/guides/blob/master/fe-page-guide-antd.md
先阅读页面组织指南,并检查当前项目的目录结构。根据项目已有的文档约定,把指南复制到合适的位置;如果没有更合适的目录,放在 docs/fe-page-guide-antd.md。复制完成后告诉我实际保存路径,不要只把远程 URL 当作参考。
检查当前项目的任务管理页面。这个页面主要用来比较任务优先级和负责人,同时需要查看任务所处阶段。
结合需求、页面源码和实际页面,给出信息架构和页面表达方式的检查结果与改造建议:列出主信息、关联信息、用户要完成的动作,说明当前表达骨架是否适合、具体问题在哪里、对应的指南依据是什么,以及建议采用什么页面结构。无法从现有资料确定的业务意图请指出来。
先把检查结果和改造方案发给我,等我确认后再完成页面改造。保留现有业务功能、权限和数据交互,沿用项目的组件库。修改后运行项目已有检查,并在页面中验证字段比较、状态切换等操作,给出修改前后的截图和仍需人工判断的问题。
页面和任务描述要换成自己的业务。AI 可以列出几种候选方案,但主骨架和信息顺序不能只看它的输出,业务出发点还得由人来定。
检查报告要落到具体位置。只说“信息层次不清晰”没有多少用处,最好说明哪些信息应该放在一起、现在分散在哪里、准备怎么改。这样才能看出 AI 是不是解决了真正的问题。
把指南放进仓库,只是给了 AI 一份依据。还要告诉它页面入口和主要任务。如果 AI 只能看到源码,就先做源码检查;等页面跑起来,再补截图和实际交互验证。
验收时,我还是会沿着真实任务走一遍:信息是不是更容易找到,下一步操作有没有变清楚,原来的筛选、权限和数据交互是否还正常。
指南与 demo 仓库里放了完整规则和示例。至于页面是否真的好用,还是得回到具体业务里试一遍。
2026-02-08 23:16:56
好是卓越的敌人。
吉姆·柯林斯,《从优秀到卓越》
年终总结拖到二月才动笔。想写的东西很多,落笔时又觉得这一年很难用几句话收束,像是被推着走到某个坎上,迈了一步。
2025 年,我继续用照片来记录生活。 不同的光影,落在过去一年的不同时刻。 有些旅行源于一时心动,说走就走;有些则是酝酿已久的奔赴。
经历不同的旅途,遇见各异的风景,触摸历史的温度,也投身自然的怀抱。 转一圈回来,还是要回到自己的生活里,平淡亦浓烈。
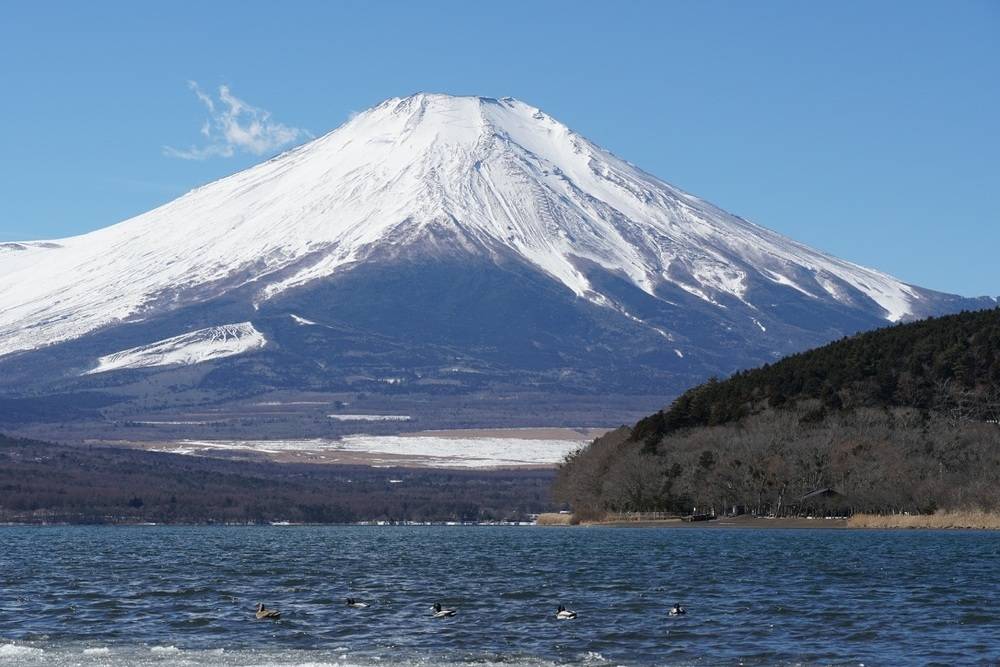
富士山山中湖,摄于日本山梨县。
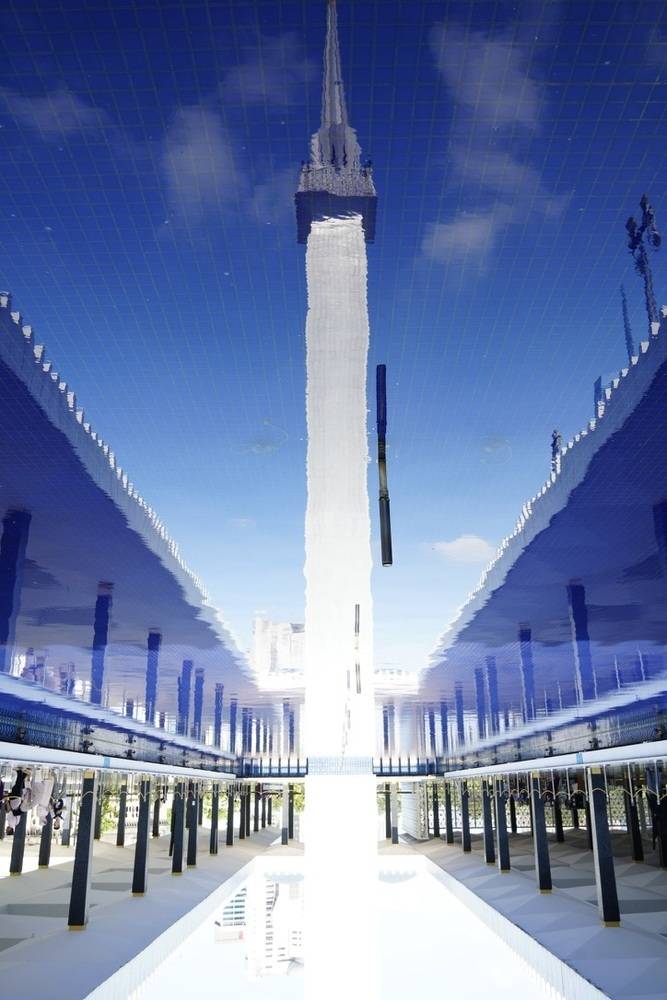
国家清真寺,摄于马来西亚吉隆坡。
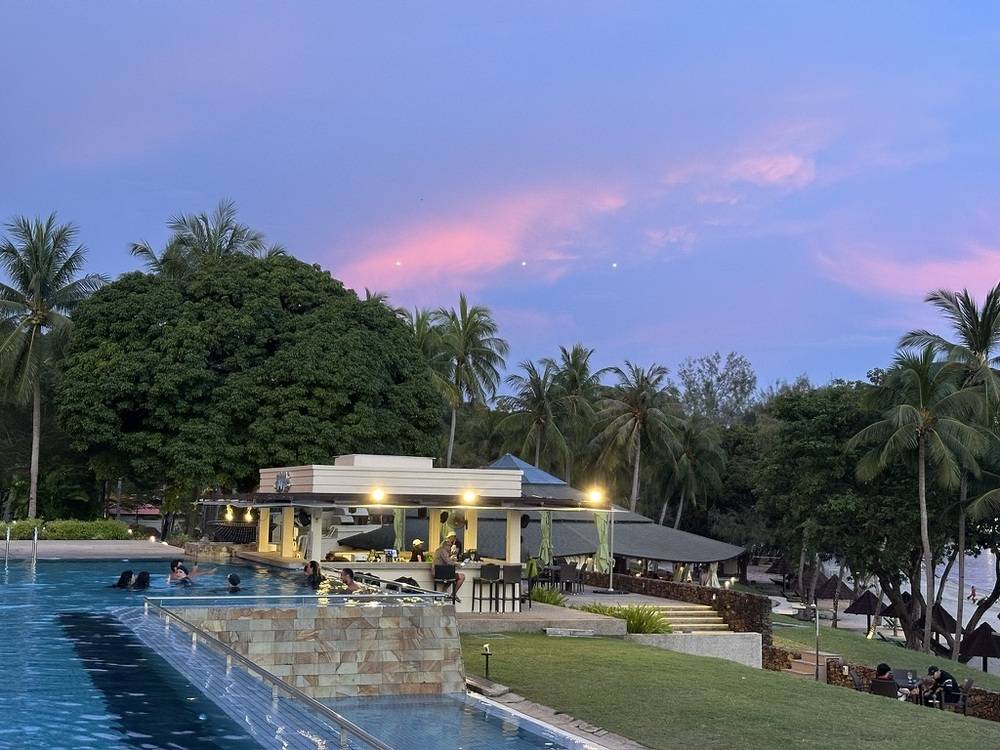
霞光落日,摄于马来西亚兰卡威。
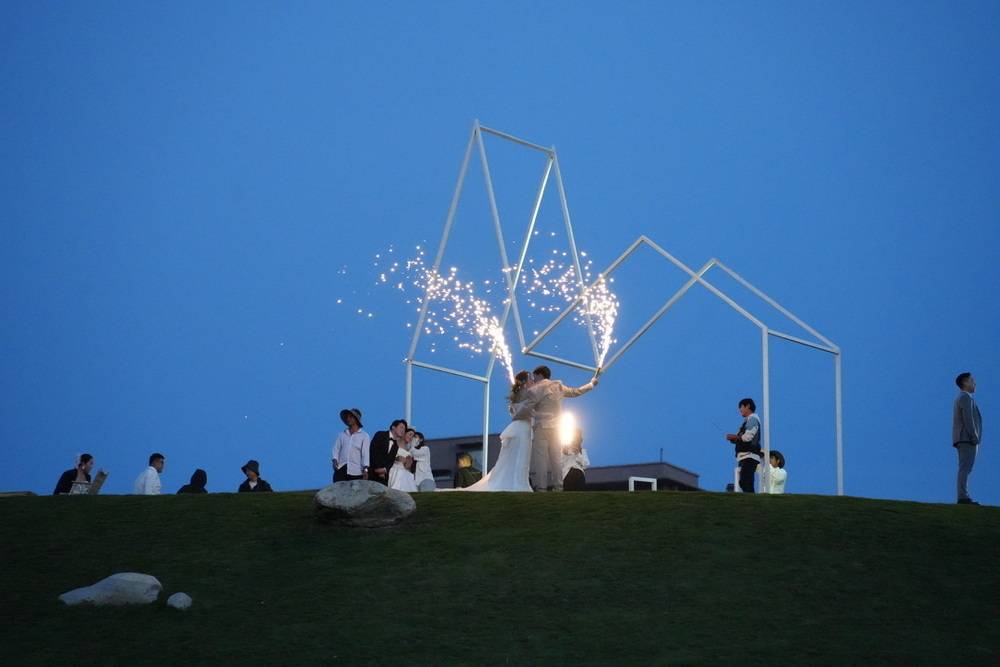
婚礼的蓝调时光,摄于大理云想山。
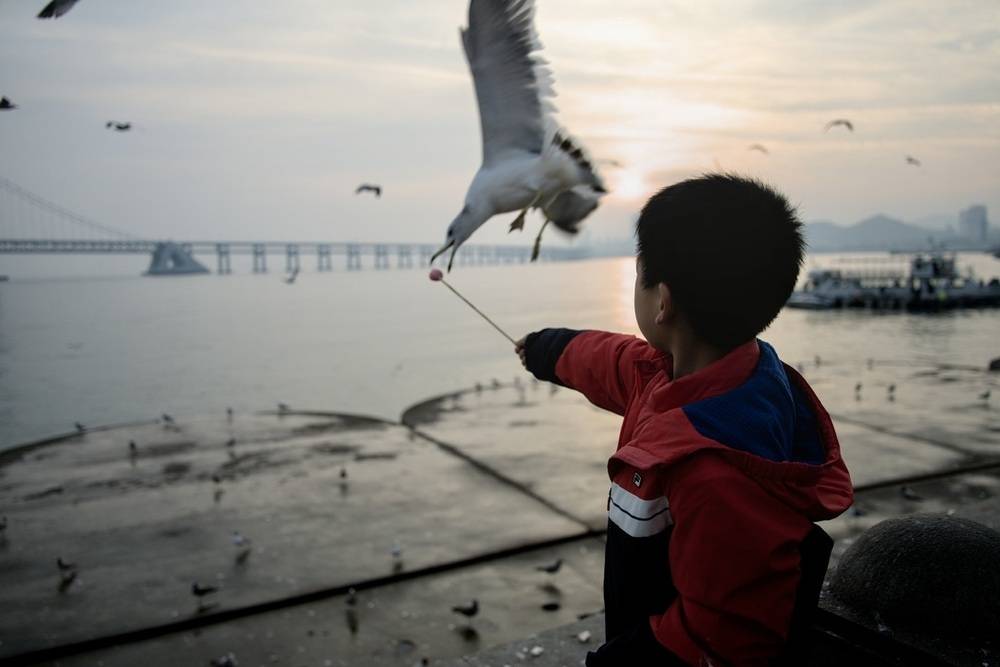
海鸥,摄于大连星海广场。
家中小朋友已经过了随便做什么都显得可爱的年龄。 他开始收到学业的要求:课业、体育、音乐,各类教育轮番上阵。 训练大模型固然困难,训练家中小模型也挺不容易的, 尤其这个小模型一开始就是智力涌现,并且叛逆因子还挺高。😄
家庭生活中,双方亲密关系永远是最重要的支柱。 我和我老婆在温暖、摩擦、包容、依赖中不断调整,寻找更舒服的相处方式。 伴侣是最接近世界上另一个我的形态,好的亲密关系会相互扶持,一起探索和体验世间。
年初设定的 OKR 明显落后,主要受精力投入影响,今年可支配时间比我预期还要少: 阅读与开源项目进展良好,健康与投资几乎停滞。 年底精简了目标,计划再砍掉一批 KR,只保留职业、家庭关系与身体三类。 减少目标帮助更稳定更聚焦,也不用再持续占用注意力去权衡优先级。
回看这一年时,很难用单一词汇去概括。 这既是忙碌的一年,也是成长的一年。
我挑了三个关键词:跃升 / 黑天鹅 / Be True。 它们对应三种感受:能力变化、环境变化,以及对人的重新理解。
年初我启动了一个基础设施项目,负责集团算力资源交付。 在 AI 推理规模快速增长的背景下,这块业务增长速度惊人。 24 年年中我接手了集团的算力交付,一度也是站到悬崖边缘, 穿越风雨,历经艰难才稳住。
困难并不在技术和工程本身,更多是问题定义、持续履约、螺旋严谨。 跨 BU 协作、历史系统复杂、责任边界模糊,却要求极高稳定性。 好在这个项目在资源投入、关注度提升、技术持续升级下,年底有了不错的结果。
年中时我接手团队,尽管业务、工程我都相当熟悉,但如何成事、成人对我来说都是新的命题和挑战。 我一度做梦时都在思考业务和产品发展路线。 还好一段时间就恢复到平静,发展不是靠大炼钢铁,还是要回到工程和产品原则,回到时代发展脉搏上。 我持续在思考到底如何经营好团队,最后我得到两个词:Be True,做正确的事情,做真实的自己,对人对己。
我捋了一份团队和组织的书籍清单,放到这里: Be True 团队和组织
12 月遇到一次黑天鹅生产事故,细节不再阐述,但影响很深远。 这件事并非真正随机。历史债务、责权、安全生产意识不足,必然会在某个时间点集中爆发。 所谓黑天鹅,更多是复杂系统不可预测性的体现。
如何去应对这种不确定性?工程上的问题始终回到第一性原理,去定义问题,去解问题。 业务和团队上,则是要持续围绕客户、解决真实问题,变化只会改变路径。 穿过风暴时,不要被定义,而是自己把定义想清楚。
这一年,AI 对工程工作的影响开始变得具体。 6 月份时我还对 AI Coding 存疑,以为基础设施领域会有更长缓冲期,因为上下文复杂且依赖经验, 但实际体验下来并非如此。使用 AI Coding 工具后,开发效率明显提升,重复劳动减少,探索成本下降。 写代码(Code Typing)未来会成为低效的工程方式,AI Native 应该成为默认选项。 AI 降低执行门槛,同时放大决策质量差异。 能力差距没有被抹平,而是被加速放大:工程师价值逐渐从实现能力转向问题选择与约束设计能力。
今年基本没写博客,虽然在内网还是保持每个月有点文字输出,但在社区和自我成长关注上投入非常有限。
回想今年,倒是年初春节时候动心起念,决定一年内完成多邻国英语流程。 130 级打完花了 278 天,起于初春,结束在秋。 接下来我主要围绕 YouTube 和 Bilibili 的原声听力做练习。
书籍继续是我思想的避风港,不管工作如何繁忙,还是可以在书本中寻找到智慧和答案。 去年给自己的期望是深刻又朴素,今年在读书选择上,更多添加了一些哲思、组织的输入。
前主管每个月都在大团队分享会给出他的读书心得,我也获益蛮多。 这是一种蛮难得的体验,我一直觉得读书是一件有点私密的事情,但这种形式也让我受益匪浅, 好几本书都丰富了我的读书范围。 未来我也会学习一下这种思想碰撞和交流方式,不用太在意反馈,回到自己初心。
Netflix 采用了一种与众不同的人才观。 他们提供行业顶尖的薪酬标准,没有采用末位淘汰制, 而是以是否达到岗位标准作为人才留存的核心依据。 在组织决策方面,Netflix 给予员工较高的信任度, 并通过事后审查的方式进行补充。 基于目标(北极星),日常决策采用情境决策模式,而非领导拍板式决策, Context, not Control。
对管理者而言,有哪些可以立即执行的行动? 第一,提供更多的信息透明度,给予成员更多的技术决策机会, 同时做好事后的效果追踪和复盘工作。 第二,在各种会议中,特别是月会、周会,不断明确和校准团队的「北极星」目标。
自然人和人造人的边界到底是什么。 长得像鸭子,叫声像鸭子,什么都像鸭子,真的是鸭子么? 穿过时间叩问一众 LLM 和 Agent。
松本行弘这本书我在十几年前就想读, 彼时的我甚至还去面试了一家使用 Ruby 的创业公司。 没想到读完居然是十几年后了。
书中以高手的姿态评点了当时比较热门的语言, 介绍了自己设计 Ruby 时候的思考和品味判断。 书中也讨论了云的出现、算力的增长、分布式的严谨对技术的影响。 高屋建瓴的视角让大部分知识即便放到今天还是不过气。
时光荏苒,物是人非,Ruby 还是局限在 Web 领域, Python 则靠 AI 打了翻身仗。 NoSQL 也是进入了稳态,GPU 占领了计算模式高低, Dart 已经完蛋了,笑。
真希望松本行弘能再出一本新的点评书。
探索宇宙,探索自身,探索存在和真理,这是西方思想史的研究命题。 历史上提出了许多主张,这些主张都需要逻辑自洽, 要么能够服务人的意义感,要么服务于宗教或者国家, 总之是适应时代、适应威权。 我想,学哲学(思想)的朋友是不是会感慨哲学发展的太慢, 几十年几百年才能演进一点点,有种脱离感,脱离当下朝夕发展的科技速度。 但反过来想,正是因为发展太快,变化太多, 我们更需要寻找到一些自我和世界的确定感和稳定感。
这本书虽然看上去是写给卓越公司管理者的, 谁又不是从一开始就想持续卓越呢,后进生也该看看优等生如何获得成功。 秘诀是:人、思想、行为、持续积累和发展,这是本书的核心结构。 卓越公司需要五级经理人(谦逊、意志、持续贯彻)。 需要去设定方向、远景、战略。 使用刺猬三环分析出:优势、热情、经济增长引擎。 认清信念(憧憬成功)和原则(面对困难)。 经典书籍,常读常新。
面向管理本质展开:提升团队杠杆率;识别业务限制步骤;目标管理、时间管理、绩效管理。
没有真正不合格的孩子。 关键是通过耐心和理解去回应真实需求, 即使在困难和变化的时候,也尽量保持自身情绪的稳定去承载孩子的情绪。 这样做其实不仅仅是教育孩子,也在某种程度上再次养育自己。
无比真诚,相当受用。 本来对小米故事不抱多高的预期,以为是讲故事讲奋斗。 读完之后发现雷军真的是敞开心扉说亮话: 从创业的使命问题到战略问题,从宏观方向到微观管理, 都做了不藏着掖着的分享。 有时候觉得讲企业管理已经变成一个显学, 但是从身边的实际感受来看,世界真的是一个草台班子,有大草台班子小草台班子。 雷军的分享是将管理学很多经典著作映照到现实。 这些道理和经验就应该持续讲,反复讲,持续学习,反复学习。
见今年仅有的几篇博客之一: 李飞飞如何获得成功? - 读「我看见的世界」 | Log4D
五星评价,看懂中国经济。
这本书几乎是台积电发展史, 从台湾当局招商引凤凰,到张忠谋到台湾, 再从代工模式发展到纳米时代各项突破,看得叫一个惊心动魄。 时代给机遇,也需要强人能够抓住。 冒着计算过的风险,跨越式发展,美式管理风格都让人印象深刻。 对中芯国际也有了更深的认识。加油吧。
推荐给所有电脑前工作者阅读。
不仅仅带团队的 TL 是管理者,知识工作者也是管理者。 德鲁克提出了 5 个核心要点:时间管理、看重贡献、发挥长处、要事优先、有效决策。 对于普通知识工作者来说,我觉得先从时间管理入手,再做好 OKR 管理和关键决策, 关键决策核心点是充分调研、找到核心问题、明确优势、面向未来。 如果有机会管理团队,则要持续关注团队成员长处。
几个主题我也写过一些文字: 时间管理 https://blog.alswl.com/2023/02/gtd/; 决策(技术决策)https://blog.alswl.com/2023/07/architecture-design-the-easy-way/ 。 今年争取再写一个关于目标管理的。
每次学习,都感受到德鲁克洞察本质的思考,常读常新。
要是人生像大梦一场,关关卡,困难重,到底该怎么办? 书里写的是作者生病的经历。 现在大家活得越来越久,生病这事,自己或家人都很可能碰上, 这本书就像个真诚的朋友,把生病后的种种感受和经历,一点不藏地告诉我们。 作者生病后日子特别难熬,书里把这些痛苦都写出来了。 他一边和病魔斗争,一边在心里给自己打气, 这些描写很真实,让我们能感受到他的害怕、坚持和对活下去的渴望。 面对风暴的办法只有一个,穿过去。
富士山的壮丽美景都历历在目。 漫步在东京国立博物馆中,我曾隐隐觉得其历史底蕴稍显单薄, 部分瓷器藏品也显得简陋,直至幕府时代的展品出现,才让人眼前一亮,印象深刻。 而读完这本书我才明白,在大化改新之前,日本的开化程度确实较低, 这也解释了博物馆早期展品相对逊色的缘由。
「山川异域,风月同天」这句诗我们并不陌生,甚至有人说中日同文同种。 但事实上,日本的发展历程有着自己的曲折轨迹, 它历经无序、混乱、贫苦与自卑,也有过爆发式的变革。 如今,日本已然成为东亚文明的重要代表之一, 拥有独特的精神内核与国民性, 与中国既有文化传承上的关联,又走出了截然不同的发展道路。
我一开始有点轻视这本书,想着自己搞了这么久,工程和方法论应该都是耳熟能详。 但细看之后感觉挺高屋建瓴的,写得很简练精要, 有一些观念梳理比自己想要结构化很多。
有几个印象深刻和反直觉的点:
资本不是洪水猛兽,资本主义也不是洪水猛兽。 资本主义的终局最终会发生么? 有没有可能进入一个多种资方互相平衡的状态。 政府也出台了反垄断法来避免资本无限扩张, 通过基本的人道主义保障来兜底最底层。 第三册写到资本逐利是根本的问题。 但逐利是一个组织存在的基本要素,人也是逐利的, 商业组织逐利有什么问题么? 逐利是生命体的表现,是存在的体现,只要不成为社会的癌细胞就行。 金融危机一定是坏事么? 是不是一个去泡沫、降温过程,那是不是只要是有序的反而是一件好事? 总体来说,马克思描述了一种在无序、小政府、割据政权下面, 资本主义会走向一个什么最差的结果,以及最终会被社会主义替代。 资本主义是家养野兽,需要套上项圈,让政府进行管制, 不管这个政府是三权分立的还是中央政权。 我怀疑在可预见未来改良式资本主义一直存在, 靠政府治理、反垄断保持着平衡。
《论中国》这本书基本可以分成两个部分。
第一部分是清末到新中国建立的中国对外外交史。
第二部分就是基辛格自己参与的中美关系发展史。基辛格是一个很有意思的人,他既流露出一种看上去的亲华派,但骨子里还是国家利益至上。他是幸运的,和中国四代(甚至可能是五代)领导人都有近距离的接触,堪称近代历史活化石。
把历史的进程拉近视角,以一个外交官(事实上)的视角呈现出来,可以更有血有肉地反映时代的细节。
相关阅读推荐:B 站大象放映室的晚清最后 13 年,邓小平时代,他改变了中国。(似乎找不到一本有代表性的书来介绍毛泽东晚年的历史。)
2026 将继续探索发现世界,持续的亲子陪伴和家庭经营,并在 Infra + AI Infra 领域有更多输入输出。
临界不是终点,蓄势待发。
2025-08-24 10:04:24
本文阐述一套适用于工程应用开发项目的迭代管理实践,重点解决如何高效低成本推进项目的问题。该方案适用于小型团队协作,核心特征在于固定产研节奏、标准化交付物以及高频异步协作机制。
本文仅针对技术方案与实施路径明确的项目场景,不涉及工程决策或目标管理范畴。本文也更注重实操,注重立即可以上手实施,不会花太多篇幅去解释这套方案背后的思考和原因。
关于实用(Pragmatic) 的定位:该理念贯穿于我的多项实践方案,包括 架构设计 the Easy Way 实用 Web API 规范 如何做好 PRR(Production Rediness Review)? 等等。实用意味着注重可操作性和实际效果,要领是简单易实施落地,任何人都可以上手执行操作。我对实用的追求来自于《The Pragmatic Programmer》这本书。
注:本文不特定区分项目(Project)和产品迭代(Product Sprint)区别,可以将这里项目管理等同于研发过程管理。
免责申明:没有银弹,本文方法论不一定适合所有场景,并且方案也在持续迭代。如果你的项目有 PM,请优先咨询 Ta。
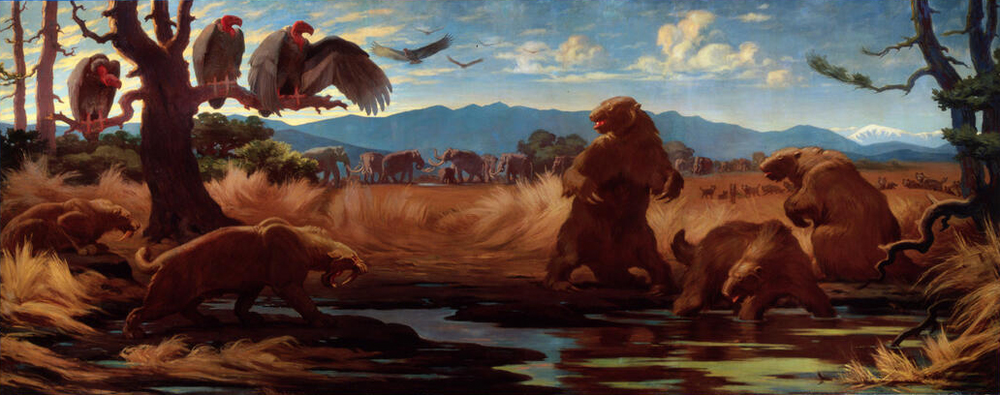 Mural of La Bre Tar Pits(C.R. 奈特雷阿的焦油坑壁画),图片被人月神话所引用。
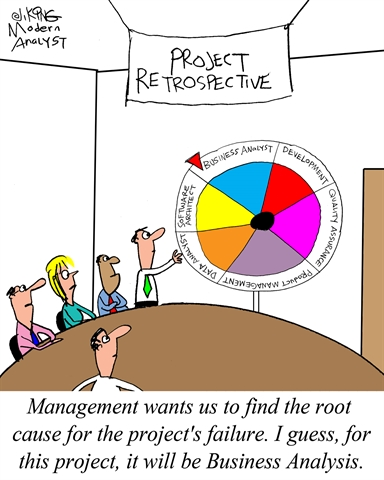
软件项目管理常面临各类挑战。就个人经验而言,最直接的困境在于项目无法按期交付。其原因可归纳如下:
问题不可怕,定义清楚问题就成功了一半,回到问题本身,让我们来看如何解决。
现实中遇到的问题可能更多,我分分类说到底是这么几个原因:
基于上述问题分析,我将这些问题的解法归到几个方向:节奏、交接物、协作。
注意,本文不聚焦解决工程难度问题,也不解决架构师要解决的问题,最多能从项目管理的思路来降低技术风险。
另:对架构问题如何处理问题请移步 架构设计 the Easy Way ;遇到了具体工程难题的同学请咨询团队技术专家。
什么是项目的节奏,什么是好项目节奏?
项目节奏的本质在于建立可预期的周期化交付机制。相较于单纯设定最终截止期限(Deadline),采用 Scrum 敏捷框架中的冲刺(Sprint)模式更为有效。每个冲刺构成包含需求分析、设计、开发、测试及上线的完整闭环。良好的迭代节奏具备三重价值:1. 建立明确的时间预期,实现周期化交付;2. 强制需求拆解,推动产品从最小可行版本(MVP)向完善形态演进,避免关门憋大招,最后拉了一泡稀的;2. 规避长期封闭开发导致的交付风险,最怕大搞 58 天,最后 2 天都交不了货
一个好的迭代周期多长比较合适呢?在小型团队协作里面,最长不要超过 1 个月,尽量保持在 2 周,最好能做到 1 周。以一次迭代的周期来看,我自己体感是 1/2 时间用来设计, 1/2 用来建设(开发测试和上线)。不要低估设计花费时间,投入少了后面想追也追不会来。
迭代管理需设置专职迭代经理,该角色承担三项核心职责:规划迭代排期、协调各类会议安排、核验交付材料规范性(依据标准化模板执行,不负责方案质量,材料质量由架构师+下游签收)。此岗位实质承担部分项目管理职能,若短期内无合适人选,应由项目负责人兼任。迭代经理通常从项目成员中产生,建议实施轮值机制。轮岗制度具有双重价值:使成员亲身体验管理挑战,促进跨角色理解;同时通过岗位实践识别流程瓶颈,推动协作机制优化。执行时需确保轮值期间管理职能的完整履行。
高频迭代带来的不少附加优势:直接化解了需求插入问题(任何需求最长等待周期 ≤1 周),紧急需求则通过紧急修复流程(hotfix)处理;大型需求必须进行拆分验证,无法拆解者需通过概念验证(PoC)先行评估技术风险。
这是一个一直被提及的问题,我有两个方案来解决,第一个是提供一个需求时间评估公式:工作量 = (最乐观 + 最悲观) / 2。
第二个是避免搞大需求,所有需求需要评估一下规模,我提供这几种级别标准,extra-large(月级别)/ large(周级别) / medium(天级别) / small(小时级别),我不接受 xl / l 需求,必须拆成 m / s。
需求时间评估是一个普遍存在的挑战,我提出两种解决方案。
第一种方案采用工作量估算公式:工作量 = (最乐观 + 最悲观) / 2。这个公式相当实用,比单一指标更多考虑到不确定性。(其实我还有一套更复杂的通过技术采纳性角度的评估方式,但是不如上一个公式简单易操作)
第二种方案聚焦需求规模控制,要求所有需求划分规模级别,包括 extra-large(月级别)、large(周级别)、medium(天级别)和 small(小时级别)。迭代中要尽量避免 extra-large 与 large 规模需求,将其拆解为 medium 或 small 规模后再行处理。
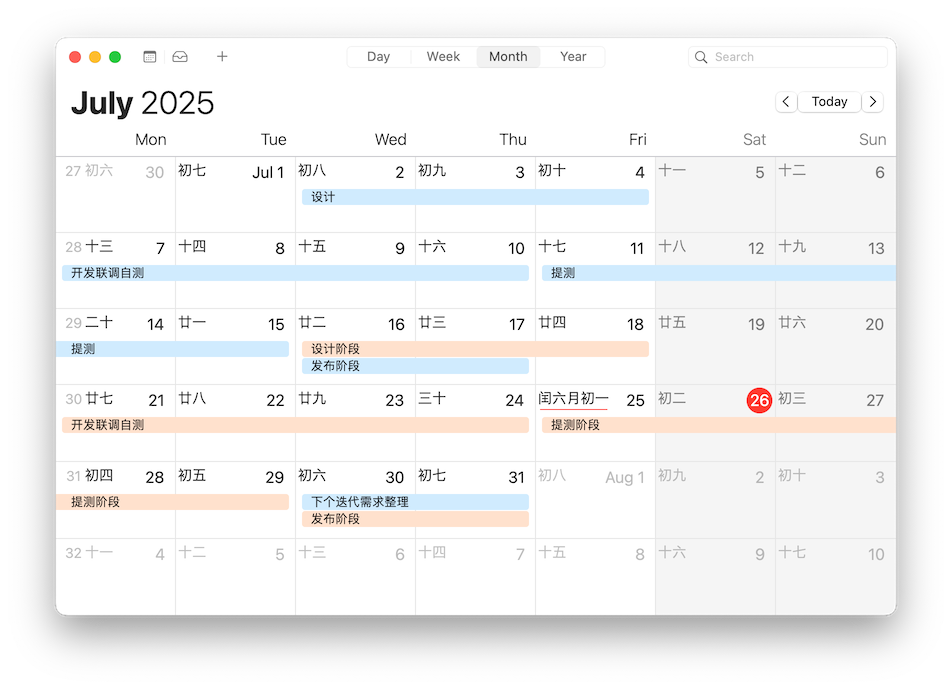
我们的一个实际案例分享,这是 我负责 产品的 7 月 两个迭代,分成 07a 和 07b 两个迭代。
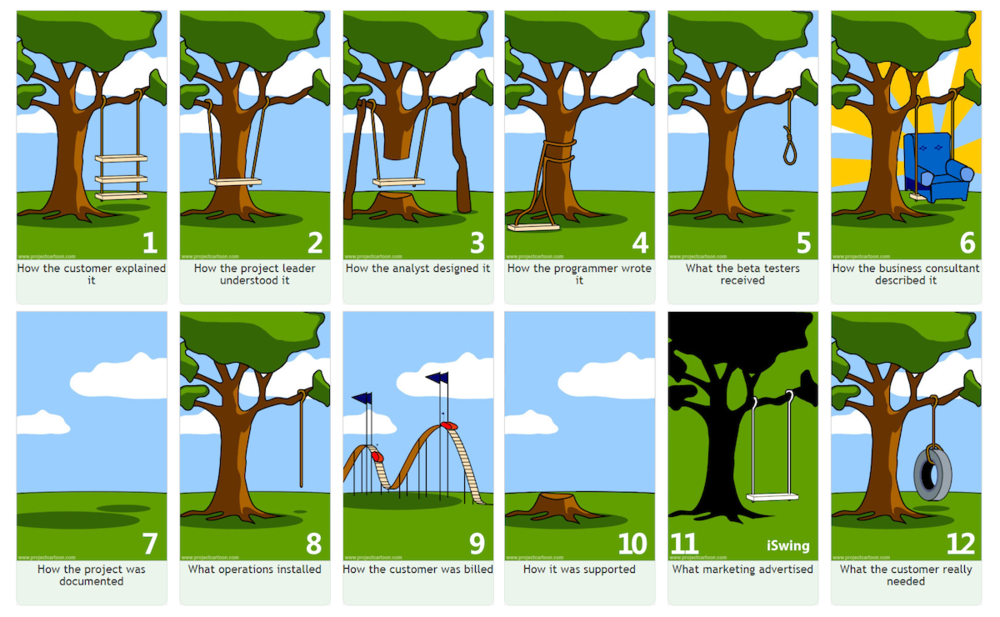
软件的不可见性和抽象性是导致软件复杂性的根本原因。
清楚明确的交接物可以有效降低不可见性和抽象性,这是用来抵抗交付复杂性的核心武器。掌握这个核心武器的最重要口诀是:写下来。
把你的长远需求规划写下来,不管是年度计划,还是月度计划。把你的需求明细写下来;把你的系统设计写下来;把你的发布功能写下来;
整个过程中,我推荐使用到这些面向项目管理的交接物,大部分交接物我们都耳熟能详,但请特别注意我这里的最佳实践:需求清单和 Release Note。
| 阶段 | 输入 / 输出 | 备注 |
|---|---|---|
| 产品规划 | 产品项目 OKR | |
| 产品思路 | 需求清单 | 需求清单是一个非常特别的形式,是我个人发明的,正面对抗一句话需求。 |
| 产品需求 | 需求文档 | 我们产品经常不配置 PD,所以需要自己写需求文档。我们有两种文档格式:文字型 / 配图型 |
| 系统设计 | 系统设计 | 文字内容设计结构必须是明确的,大家应该使用相同的模式来进行文字创作。比如系统设计文档可以使用语雀自带的模板。 |
| 开发 | 自测报告 | 截图证明你可以。 |
| 测试 | 测试报告 | |
| 发布 | 发布计划 | |
| 上线 | Release Note | Release Note 做轻薄一些,尽量链接到产品功能使用文档。 |
| 日常使用 | 产品说明文档 | 多截图,常更新,跟随产品上线发布。 |
下面我会展示一些我实践的需求范例(可能来自不同的产品和迭代)。
这是我使用的需求清单范例:
| 功能描述 | Owner | 优先级 | 前端页面数 | 质量介入 |
| 用户 A 可以使用 功能 B 完成授权 | 狗哥 | 高 | 2 页 | 是 |
| 用户 B 可以使用 功能 C 查看报表 | 谢宝 | 高 | 2 页 | 否 |
| 用户 C 可以使用 功能 C 发布视频 | 落九 | 高 | 很少 | 是 |
需求文档模板:
需求标题:简洁明了地描述需求 用户角色:谁会使用这个功能 用户目标:用户想要达成什么 前置条件:使用该功能需要满足的条件 主要流程:详细描述用户如何使用该功能 替代流程:描述可能的例外情况 验收标准:如何判断需求已经被正确实现
一个需求文档范例(文字型):
视频发布流程 MVP
用户角色:内容运营者 需求标题:用户上传视频并完成自动化发布流程 用户目标:
- 运营者通过标准化流程完成视频从上传到发布的完整生命周期管理。
- 关键步骤自动化处理(如转码、审核),减少人工操作,关键节点保留人工确认机制。
- 支持异常处理(如审核失败、转码错误),允许人工介入重试或跳过。
主要流程
- 创建视频发布任务
- 用户上传原始视频文件(支持主流格式:MP4/MOV/AVI)
- 填写基础元数据(标题、分类、标签、封面图)
- 自动化预处理
- 转码引擎:自动生成多分辨率版本(1080P/720P/480P)
- 内容审核:
- AI自动审核(敏感画面、违禁内容)
- 若AI审核通过 → 进入发布队列
- 若AI审核失败 → 暂停流程并通知人工复审
- 人工确认节点(流程暂停点)
- 人工复审:运营者在后台查看AI标注的违规片段,选择:
- 通过(继续流程)
- 驳回(需编辑视频后重新上传)
- 强制跳过(需填写跳过原因)
- 发布执行
- 自动推送至指定发布渠道(Web/APP/第三方平台)
- 生成可跟踪的发布ID(用于效果分析)
- 异常处理机制
- 转码失败:自动重试(≤3次)→ 仍失败则通知人工
- 发布中断:支持手动重试/跳过/终止任务
替代流程
- 转码模块不可用:允许上传预转码视频文件(需符合分辨率规范)
- AI审核服务宕机:切换为全人工审核模式(需在SOP中注明应急预案)
验收标准
- 全流程验证:
- 运营者从上传到发布成功耗时 ≤15分钟(不含人工审核等待)。
- 模拟审核失败场景,人工强制跳过步骤后流程可继续。
- 异常处理验证:
- 转码失败时,系统自动告警并允许手动替换文件。
- 发布中断后重试,视频状态可恢复至中断前节点。
- 文档交付:
- 提供《视频发布SOP手册》,含人工操作指引及故障处理方案(A负责维护)。
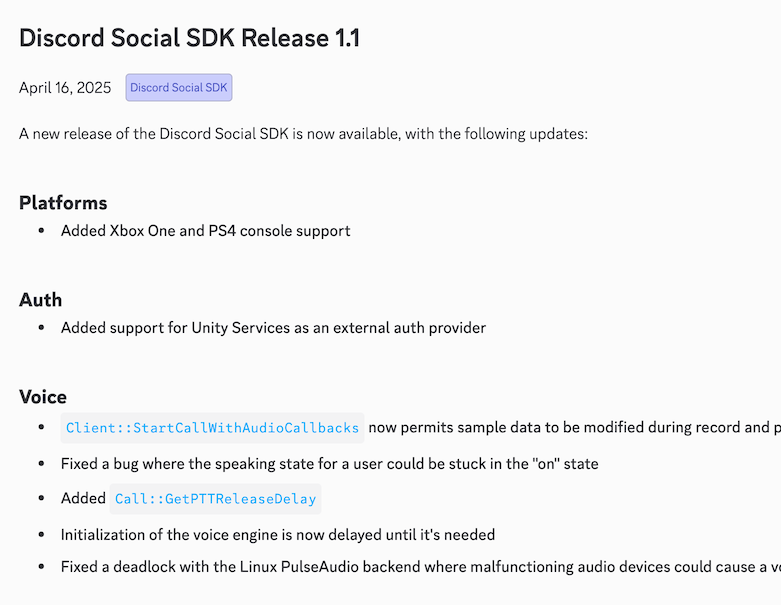
Discord 的 Change Log(Release Note)发布大纲,没有前端产品用那么多 emoji。
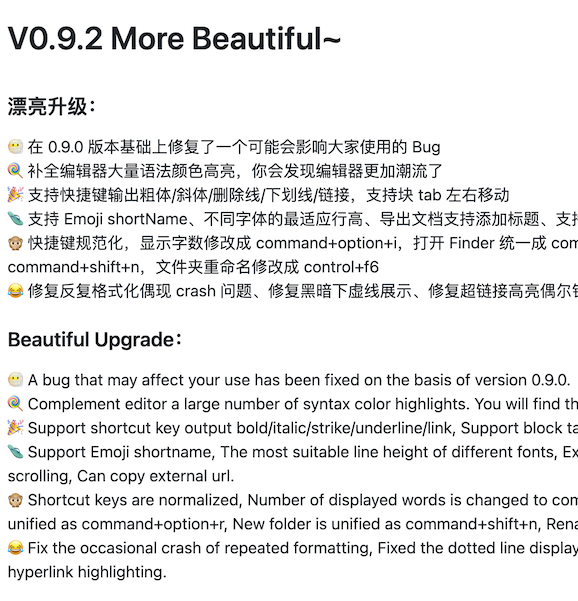
妙言 tw93/MiaoYan 的某个 Release 更新日志:
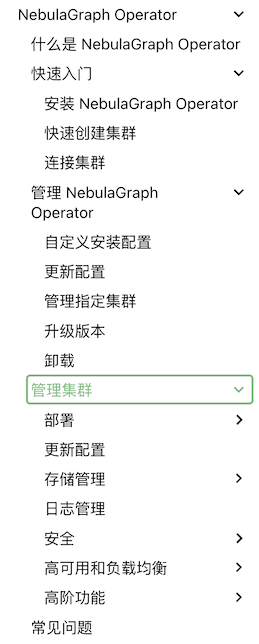
我建议可以使用基于 Git 仓库管理的 markdown 方案,比如 MkDocs 这类方案:
我推荐的范例是 NebulaGraph Operator 的文档范例,注意这仅仅是 NebulaGraph 的其中一个子产品,但是规模更小更适合起步。
关于交付物,特别是文档类型的交付物,虽然我列了这么多类型,但是我认为一定不要写多写复杂,提纲挈领,量少为宽。
不要陷入巴别塔。
在分布式协作场景下,需建立「异步为主、同步为辅」的沟通范式,重点解决信息孤岛、风险滞后及依赖阻塞三大痛点。有效的协作机制应包含三个核心要素:全局可视化任务管理、结构化风险预警及精准化依赖协调。
我讨厌开会,甚至从某种意义上我痛恨开会。我之前写过关于会议的暴论:
这个月代码写得太少了,会议时间占据了 1/3,这很可怕。
会议很低效,很低效,很低效。有些会缺少材料准备,问题不聚焦,主持人不控场,一拉一大把人,不少人又不好意思走就硬挂着。
如果我有权利,我甚至想禁止公司开会,全都回归到基于文档的异步交互模式。
还是多建设,少空谈,有明确主张,材料提前分发,开会不当聋哑人,非干系勇敢离开会议。让大家回到方案设计和代码上吧。
有效沟通需规避信息失真,核心在于建立风险透明机制与依赖协同体系。具体实施包含三个维度:全局可视化看板:实时呈现任务进度与风险状态;精准进度追踪:量化每个节点的完成度;异步协作平台:通过在线任务管理工具(如 Jira)实现全周期信息同步。
我们不需要开会了么?还要,但是只要两种:方案评审会与日会。
评审会的要点在于:
日常进度沟通模式,我推荐每日站会沟通,最少也得双日沟通(每周二、四)。每天都进行站会同步,每次 15m 搞定。一般一个项目成员在 7 人左右(披萨原理),每人一两分钟。
站会的主持人很重要,要引导参与人同步进度,同步风险,寻求帮助,帮助需要有明确的接收方。
核心准则:以文档异步协同为基础,将同步会议压缩至必要场景,最大化建设性工作时间。
下面是会议看板范例,根据迭代过滤,根据 Assginee 分组(其实也很普通,没什么特别的):
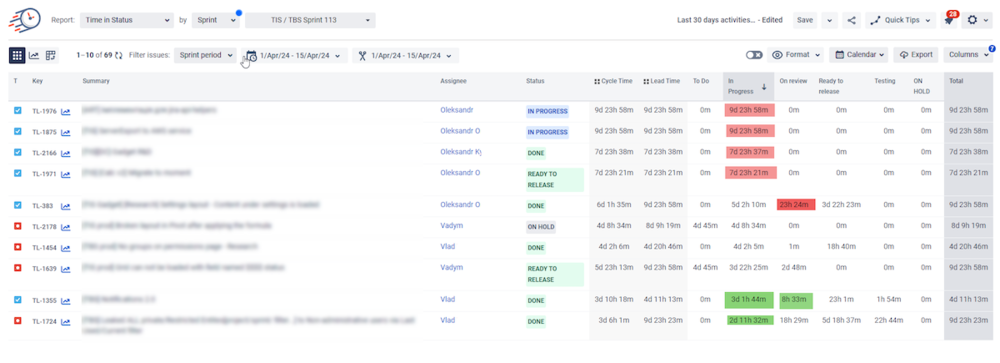
每天迭代经理在日会上面就是拿着这个看板,先明确我们几号提测几号上线,再挨个成员自述进展如何,最后挨个问有没有上线风险。
没有万灵的项目管理机制,根据自己面临的问题进行实际调整。本文的命题对我(一个开发工程师)来说也是极具挑战。我在过去有多次因为项目无法交付问题失眠无法入睡。现在来看,其实大可不必,平常心来应对问题,对预期内问题建立预案,对计划外变更保持弹性。当团队已完成可行性范围内的最大努力,即应视作有效交付。项目管理的终极目标,是在资源约束下实现可持续的技术价值输出。
人月神话 (豆瓣) 软件工程项目管理的圣经,20 年后读起来仍然觉得字字珠玑。
项目管理修炼之道 (豆瓣) 这是我的项目管理入门指导书,更通用更适合 PM。我写过一个读书笔记 《项目管理修炼之道》笔记 | Log4D。
代码之殇 (豆瓣) 作者是微软高级架构师/管理者,而本书实际上是一个随笔式的文章集合。尽管如此,书中的许多观点犀利且具有独特的见解,展现了从一线到高层的全方位视野。其中关于工程过程管理(比如死亡行军)事项,确实值得深思。
2025-06-24 07:14:49
读一本好书,就是和许多高尚的人谈话 - 歌德
第一次听闻李飞飞的名字,是在 2013 年与前公司 CTO 的中午干饭闲谈中。 彼时他正深耕 CUDA 并行计算领域,反复提及 ImageNet 竞赛与 AlexNet 的突破性表现, 而我对这场即将席卷全球的深度学习革命尚处懵懂——当时全身心投入业务系统优化, 面对「算法黑箱」既无暇探究,更难预见其对技术世界的重构力量。
如今读到李飞飞自传,方觉这场对话暗藏玄机:那个曾被视作实验室小众技术的计算机视觉项目, 竟成为改写 AI 发展轨迹的关键节点。在学科交叉处开疆拓土的战略眼光,在技术拐点期破除质疑的前瞻判断, 以及贯穿始终的"北极星"式价值锚点——这些要素如何在特定历史坐标中交汇, 最终塑造李飞飞成为改变机器认知方式的科学家。
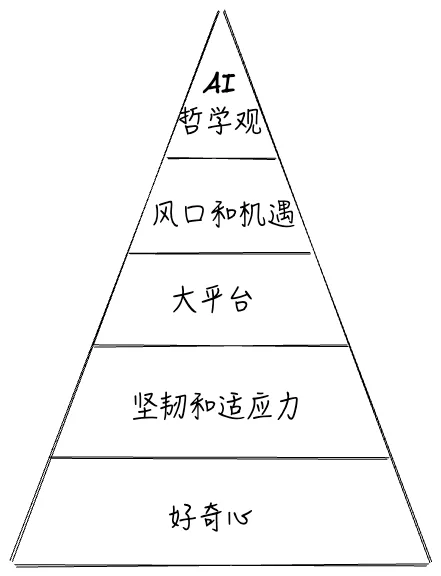
李飞飞的成就源于多重维度的深度交织。其科研旅程始于对世界本质的探索欲。父亲带她 观鸟、捕捉昆虫的经历,在她心中种下好奇的种子,而母亲引导的跨学科阅读(涵盖海洋 生物、机器人、神话等)则拓宽了她的认知边界。中学时期她对航空航天等冷门领域的痴 迷,更展现出对抗性别偏见的独立思考能力。这种探索精神在普林斯顿大学攻读物理学时 得到深化,她将物理视为「西方科学最高深的创造性学科」,以此锤炼逻辑思维。这种对 知识本质的追求,成为她转向人工智能研究的底层动力。
逆境中的韧性塑造了她的核心竞争力。移民美国初期,语言障碍与经济压力如影随形。她 通过多重兼职(中餐馆打杂、家庭保洁、干洗店经营)维持生计,却仍以 SAT 数学满分的 成绩进入普林斯顿。更艰难的是母亲重病期间,她在手术室旁穿着隔离服完成学业,同时 充当医患翻译,展现出极限压力下的抗压与时间管理能力。外界质疑(如教师贬低女性数 理能力)反而强化了她「超越现实障碍」的信念。
顶尖平台的阶梯式跃迁为研究提供了关键支撑。普林斯顿时期奠定其学术基础,并促使她 转向计算机科学。加州理工学院攻读博士期间,她选择当时冷门的计算机视觉方向,在神 经科学与 AI 的交叉研究中确立「让机器理解人类视觉世界」的核心命题。斯坦福大学时 期,她创立人工智能实验室(SAIL),将 ImageNet 从构想变为现实。后续在谷歌的产业 实践,则加速了技术落地与应用转化。
把握技术拐点的决断力最终引爆突破。2006 年 AI 寒冬期,创建海量数据集被视为「学术 自杀」。面对终身教职可能受阻的警告,她创新采用亚马逊众包模式,发动全球数万人协 作标注,解决人工需耗时百年的难题。2012 年 ImageNet 竞赛中,GPU 算力支撑的 AlexNet 以压倒性优势胜出,验证了数据驱动路线的正确性,直接推动深度学习革命。
李飞飞独特的 AI 哲学观始终指引其技术路径。她批判当时学界对算法的过度专注,提出 计算机视觉的瓶颈在于缺乏「视觉常识」。ImageNet 的构建(1500 万图像/2.2 万类别) 本质是为机器建立认知世界的「视觉图谱」,其初衷是赋予 AI 感知现实的能力,而非单 纯追求技术指标。这种将人文认知融入技术设计的理念,后来成为斯坦福「以人为本人工 智能研究院」(HAI)的核心理念。
李飞飞的成长轨迹为家庭教育提供了深刻启示:她的父母并非教育专家,却以最朴素的方 式践行了「守护好奇心」与「培养独立人格」的核心理念。
关注孩子对自然世界的探索。父亲是李飞飞科学启蒙的「引路人」。他带着女儿在成 都街头观鸟、捕捉竹节虫、观察水牛,将自然视为开放的实验室。这种实践教育不仅培养 了她对生命现象的敏锐观察力,更塑造了「提问—探索—验证」的科学思维雏形。当同龄人 被规训于课本知识时,李飞飞已通过昆虫的复眼结构理解光学原理,从鸟类迁徙模式感知 生态系统的复杂性。这种源于真实世界的认知体验,远比抽象概念更深刻地影响了她日后 选择计算机视觉作为研究方向的决策。
母亲则是李飞飞精神世界的「守护者」。面对中学教师对其阅读《不能承受的生命之轻》 等「非主流书籍」的质疑,母亲断然反驳:「我的努力只是为了成为更好的自己」,并以 此教导女儿不必迎合外部标准。这种教育哲学解构了传统权威的绝对性——当老师公开 贬低女生数理能力时,母亲的态度成为李飞飞对抗偏见的心理支柱:「他们无法阻止我在 这里上场参赛,我暗下决心,一定要赢」。更关键的是,父母始终以行动传递价值观:在 移民美国后陷入经济困境时,他们拒绝向现实妥协,反而将生存压力转化为家庭凝聚力, 让李飞飞在干洗店账本间隙研读学术期刊成为可能。
回归到教育的本质 - 培育「反叛的底气」。20 后是 AI Native 小孩,需要去成功 AI Master 而不是 AI Slave,不要去被 AI 替代而要不 AI 赋能,很大的一个要点是要有 独立思考能力,有思辨、批判精神,从而去指挥 AI。李飞飞父母的教育智慧,在于将 探索精神与批判性思维内化为孩子的生存本能。他们既不刻意塑造「完美人设」,也不焦 虑于短期得失,而是通过持续支持孩子的兴趣选择(如允许剪短发、痴迷航空航天设 计),让独立人格在真实生活场景中自然生长。这种教育模式的当代启示在于:真正的素 质教育不是资源堆砌,而是父母能否在物质匮乏时仍坚持精神富养,在世俗标准前守护孩 子的独特性。正如李飞飞在 ImageNet 项目受质疑时所展现的韧性,其根源正是童年期形 成的「质疑—坚持—突破」的行为模式。
李飞飞在自传中反复提及指引她前行的「北极星」—— 一种超越短期利益与外界评价的内在驱动力。对她而言, 这颗星是对知识本质的追问与对人文价值的坚守的融合。 从成都街头的观鸟少年到斯坦福实验室的领航者,她始终以「探索未知」与「服务人类」 为双轴校准方向:在华尔街高薪诱惑前,她选择回归科学本心;在算法主导的 AI 浪潮中, 她坚持构建让机器理解现实世界的视觉常识库;当技术突破引发伦理争议时, 她强调「AI 的胜利必须是人文的胜利」。这种贯穿始终的清醒, 源于父母传递的价值观——母亲病榻上的灵 魂拷问「人工智能还能如何帮助他人」,最终化作她推动医疗环境智能研究的持久动力。
真正的北极星,从来不是某个具体目标,而是驱动人穿越迷雾的底层信念: 对李飞飞而言,那是永远追问「为什么」的好奇心,与永远不忘「为了谁」的责任感。