
2026-11-12 06:00:00
本文永久链接 – https://tonybai.com/2026/11/12/go-turns-17-ai-era-roadmap
大家好,我是Tony Bai。
【导读】
2026 年 11 月 10 日,Go 正式迎来开源发布 17 周年。
这一次,Go 技术负责人 Austin Clements 亲自执笔,在 Go 官方博客发表了《Go Turns 17》。这篇文章篇幅不短,内容也相当扎实。从 Go 1.26、Go 1.27 的语言和标准库演进,到 Green Tea GC、SIMD、后量子密码学,再到 go fix、gopls、MCP 和 AI 编程 Agent,几乎覆盖了 Go 技术栈的方方面面。
但如果只是把它当成一份年度更新清单,就低估了这篇文章的价值。
我认为,文章真正值得 Gopher 关注的,是 Go 团队正在释放的几个明确信号:语言继续保持克制,但底层性能正在向现代硬件深处推进;标准库开始系统性地解决生产环境中的长期痛点;安全从 API 设计延伸到了整个软件供应链;而开发工具链则正在主动拥抱 AI Agent。
17 岁的 Go,正在从一门优秀的编程语言,成长为 AI 时代的软件工程基础设施。
【文章要点】
go fix、Modernizers、gopls、MCP Server、pkg.go.dev API,让 Go 工具链成为 AI Agent 的可靠基础设施。【Go, Rust & AI 精进营】一年仅一次 · 双 11 限时特惠,长按下方图片扫码,直降入营:
2026 年 11 月 10 日,Go 正式迎来了开源发布 17 周年。
Go 团队为此在官方博客发表了一篇长文:《Go Turns 17》,执笔者是 Go 技术负责人 Austin Clements。
这不是一篇简单的生日祝福,也不是常规意义上的版本更新公告。
文章相当长,覆盖了过去一年 Go 语言、标准库、运行时、编译器、安全体系、开发工具链等多个方面,同时还披露了 Go 1.28 的部分规划。
我认真读完后,最大的感受是:
Go 团队并没有因为 AI 浪潮而改变自己的基本哲学,但他们正在认真思考:当软件开发越来越多地由 AI Agent 参与时,Go 应该变成什么样?
这篇文章有几个值得所有 Gopher 关注的信号。
过去一年,Go 1.26 和 Go 1.27 在语言层面有不少值得关注的改进。
其中一个明显方向是:继续完善泛型。
自 Go 1.18 引入泛型以来,Go 团队一直在根据真实项目中的使用反馈,逐步弥补泛型设计中的一些限制。
例如,Go 1.27 引入了非接口类型上的泛型方法。
过去,Go 的方法不能声明自己的类型参数,这使得某些 API 只能设计成包级函数,调用方式也不够自然。
现在,泛型方法让 API 能够更好地围绕类型组织。
另一个例子是 math/rand/v2 中新增的 Rand.N 方法。
此外,Go 1.26 支持了自引用类型约束,Go 1.27 进一步扩大了泛型函数值的类型推断范围。
这些改进并没有改变 Go 泛型的整体设计哲学,而是在原有框架内,让它变得更加自然、完整。
语言语法方面也有两个值得一提的变化:
Go 1.26 允许 new 接收初始值:
p := new(42)
s := new("go1.26")
这意味着,过去为了给结构体中的可选指针字段赋值,我们经常需要编写 newInt、newString 之类的小工具函数,现在可以少写不少样板代码。
Go 1.27 则进一步简化了嵌入字段和嵌套结构体的字面量初始化。
不过,我认为这部分真正值得关注的,并不是某一个语法糖,而是 Go 的演进方式:
Go 没有追求通过增加大量语法特性来提高表达能力,而是在已有设计边界内,持续消除真实开发中的摩擦。
标准库方面,最大的看点无疑是 encoding/json/v2。
这项工作历时六年,最终在 Go 1.27 中正式发布。
为什么一个 JSON 库,Go 团队需要花六年时间重写?
因为 encoding/json 已经存在超过 15 年,整个 Go 生态中有数以百万计的程序依赖它。原有实现存在一些历史问题,例如:
要解决这些问题,又不能破坏既有程序的兼容性,难度可想而知。
最终,Go 团队采用了两个新包:
encoding/json/v2:负责更高层次的语义化 JSON 编解码。encoding/json/jsontext:负责更底层的 JSON 语法处理和流式操作。新实现提供了更严格的默认行为、更灵活的定制能力,以及最高可达 10 倍的反序列化性能提升。
更重要的是,旧版 encoding/json 现在已经完全基于 v2 实现。
这意味着,即使你的项目暂时不迁移到 v2,仅仅升级 Go 工具链,也能从底层实现改进中受益。
这是一次非常值得研究的标准库升级案例:既解决历史问题,又尽可能降低整个生态的迁移成本。
如果说语言和标准库解决的是开发者的表达能力与编程体验,那么运行时和编译器解决的就是另外一个问题:
如何让 Go 程序更充分地利用现代硬件?
17 年前 Go 诞生时,CPU 的架构、缓存体系和向量计算能力,与今天已经有了很大不同。
而 Go 团队正在从多个方向推进这件事。
Green Tea GC 在 Go 1.25 中作为实验性功能亮相,并在 Go 1.26 中成为默认垃圾收集器。
传统 GC 在扫描对象时,需要沿着对象之间的指针关系不断遍历。
Green Tea GC 则改变了对象标记的组织方式,更多地围绕连续内存区域进行处理,从而更好地利用现代 CPU 的缓存和内存访问特性。
根据 Go 团队公布的数据,在真实工作负载中,它能够减少约 10%~40% 的 GC 开销。
在支持 AVX-512 的新型 amd64 处理器上,向量化扫描还可以带来额外约 10% 的收益。
SIMD,即 Single Instruction, Multiple Data,允许一条指令同时处理多个数据。
对于加密、媒体处理、数据分析和 AI 等计算密集型任务,SIMD 是充分发挥现代 CPU 性能的重要手段。
过去,Go 开发者想利用 SIMD,通常需要自己维护不同 CPU 架构的汇编代码。
Go 1.26 和 Go 1.27 引入了两个实验性包:
simd/archsimd:提供面向具体架构的底层向量指令访问能力,覆盖 amd64、arm64 NEON 和 WebAssembly。simd:提供更高层次、与向量宽度无关的 API,尽量实现跨架构的可移植性。这件事很有意义。
Go 并不是要让每一个开发者都去写 SIMD 汇编,而是希望提供一层统一抽象,让更多普通 Go 程序也有机会使用现代 CPU 的向量计算能力。
Go 1.26 优化了 append 场景下 slice 底层数组的初始分配,编译器能够在栈上分配初始存储空间,减少 slice 扩容过程中产生的小对象堆分配。
Go 1.27 则引入了针对不同对象大小的专用分配快速路径。
对于 80 字节以内的小对象,分配速度最高提升约 30%。
此外,Go 1.26 还将基础 cgo 调用开销降低了约 30%。
这些优化看起来都比较底层,但对于高并发服务、网络基础设施和大量使用小对象的 Go 应用来说,积累起来的收益可能相当可观。
我认为这里释放出的信号很明确:
Go 的性能优化正在从传统的编译器优化,进一步深入到 CPU 微架构、内存层次和向量计算。
安全是 Go 17 周年文章中另一个非常重要的主题。
首先是后量子密码学。
面对未来量子计算可能对传统公钥密码体系造成的威胁,Go 正在逐步完善后量子密码学支持。
Go 1.26 在 crypto/tls 中默认启用了混合后量子密钥交换,并增加了 crypto/hpke 包。
Go 1.27 又引入了 crypto/mldsa,实现 FIPS 204 定义的 ML-DSA 后量子数字签名标准,并将其集成到 crypto/x509 和 crypto/tls 中。
与此同时,Go 还在加强加密 API 的安全默认行为。
例如,大多数密钥生成和签名函数现在会无条件使用系统安全随机数源,减少开发者错误传入非密码学安全随机数读取器的风险。
Go 1.26 还引入了实验性的 runtime/secret 包,用于主动清除寄存器、栈帧和堆中的敏感临时数据。
但我认为,文章中最值得关注的安全案例,并不是某个密码学 API,而是一次真实的安全事件响应。
2026 年 10 月,eMudhra 证书私钥泄露事件暴露出一个严重问题:八张中间 TLS 和代码签名证书使用了极其薄弱的私钥。
由于 Linux 缺乏统一的操作系统级证书吊销机制,Go 内置的 TLS 证书验证器实际上承担着大量 Linux 服务的关键防御职责。
Go 安全团队在收到通知后的 7.5 小时内,就发布了 Go 历史上首次 URGENT 通道安全更新:
同时更新 Go 漏洞数据库,使 govulncheck 能够识别受影响的二进制文件。
而这一切发生在相关弱密钥公开披露的前一天。
这件事让我印象很深。
安全不只是提供几个安全的 API,也不只是编写安全指南。
真正成熟的软件生态,必须具备漏洞发现、风险评估、快速修复、工具链检测和用户通知等完整能力。
Go 正在把安全从语言和标准库层面,扩展到整个软件供应链和运行时生态。
如果说前面几个方向代表 Go 的传统技术基本盘,那么这一部分可能是整篇 17 周年文章中最值得 AI 时代开发者仔细阅读的内容。
Go 团队明确指出:
他们正在让 Go 开发工具同时更好地服务于人类工程师和 AI 编程助手。
为什么要做这件事?
文章提到了一个很有意思的现象。
在 Go 开发者调查中,开发者反馈最大的挑战之一,是如何确保代码遵循最新的 Go 最佳实践和惯用写法。
Go 一直坚持向后兼容。
这意味着旧代码通常仍然可以正常编译和运行,但随着语言和标准库不断演进,新的、更清晰、更高效的写法也在不断出现。
于是,一个问题出现了:
旧代码不会自动消失,AI 模型又往往更容易学习到历史代码中的旧模式。
这就导致 AI 生成的 Go 代码,有时虽然能够正常工作,却未必符合当前 Go 生态的最佳实践。
Go 团队正在从几个方向解决这个问题。
Go 1.26 对沉寂已久的 go fix 进行了彻底改造。
新版 go fix 不再只是简单的代码修复工具,而是引入了大量 Modernizers。
它们能够自动识别旧代码模式,并将其转换成更符合现代 Go 惯用法的写法。
这些 Modernizers 既可以通过 gopls 在 IDE 中提供即时建议,也可以通过 go fix 对整个代码库进行批量升级。
Go 团队用了一个非常值得玩味的类比:
gofmt 解决代码风格一致性问题,而 Modernizers 解决代码惯用法的一致性问题。
我觉得这个定位非常准确。
过去,gofmt 让 Go 代码在格式层面形成了统一标准。
现在,Go 希望通过 Modernizers,让整个生态在编程习惯和 API 使用方式上也能够持续保持现代化。
这对 AI 编程尤其重要。
当 AI Agent 生成了一段 Go 代码,它不仅应该能够通过编译和测试,还应该能够利用 go fix 自动升级到当前推荐的写法。
Go 团队显然也意识到,仅靠官方维护 Modernizers 是不够的。
Go 生态中有大量第三方库,官方不可能为每一个库都编写迁移规则。
因此,Go 1.26 引入了基于注解的源码级内联机制:
//go:fix inline
第三方库作者可以使用这个注解,标记已经废弃的函数、类型或常量。
当开发者升级依赖时,go fix 或 IDE 就可以安全地将旧 API 的调用迁移到新的 API。
这个机制还会考虑求值顺序、副作用和变量名遮蔽等问题。
这实际上是在建立一种自助式代码维护机制。
未来,第三方库作者可以把自己的迁移知识直接交给 Go 工具链,而不是要求每一个使用者手工修改代码。
过去一年,Go 团队连续发布了四个版本的 gopls:
这些版本带来了大量开发体验改进。
例如:
go.mod 依赖发生变化时自动执行 govulncheck 扫描。值得特别关注的是,gopls 内置的 MCP Server 也在持续增强。
这意味着 AI Agent 不必完全依赖文本搜索和猜测,就可以通过标准化工具接口获取 Go 工程信息、理解代码结构,并执行更准确的开发操作。
对于正在使用 Claude Code、Codex 等 AI 编程工具的 Gopher 来说,这个方向值得持续跟踪。
今年 5 月,Go 团队正式推出了 pkg.go.dev API。
过去,IDE、开发工具和自动化程序如果想获取 Go 生态中的模块信息,经常需要通过网页抓取等不稳定方式实现。
现在,官方 API 可以提供:
Go 1.27 又进一步支持了:
go doc pkg@version
开发者可以直接从命令行查询任意版本的包文档。
对于 AI Agent 来说,这一点尤其重要。
AI 模型本身的训练数据可能已经过时,甚至可能混淆不同版本的 API。
但如果 Agent 能够实时查询官方包文档、模块版本和漏洞信息,就能获得更加准确、可验证的工程上下文。
我们可以把 Go 团队正在构建的这套能力理解为:
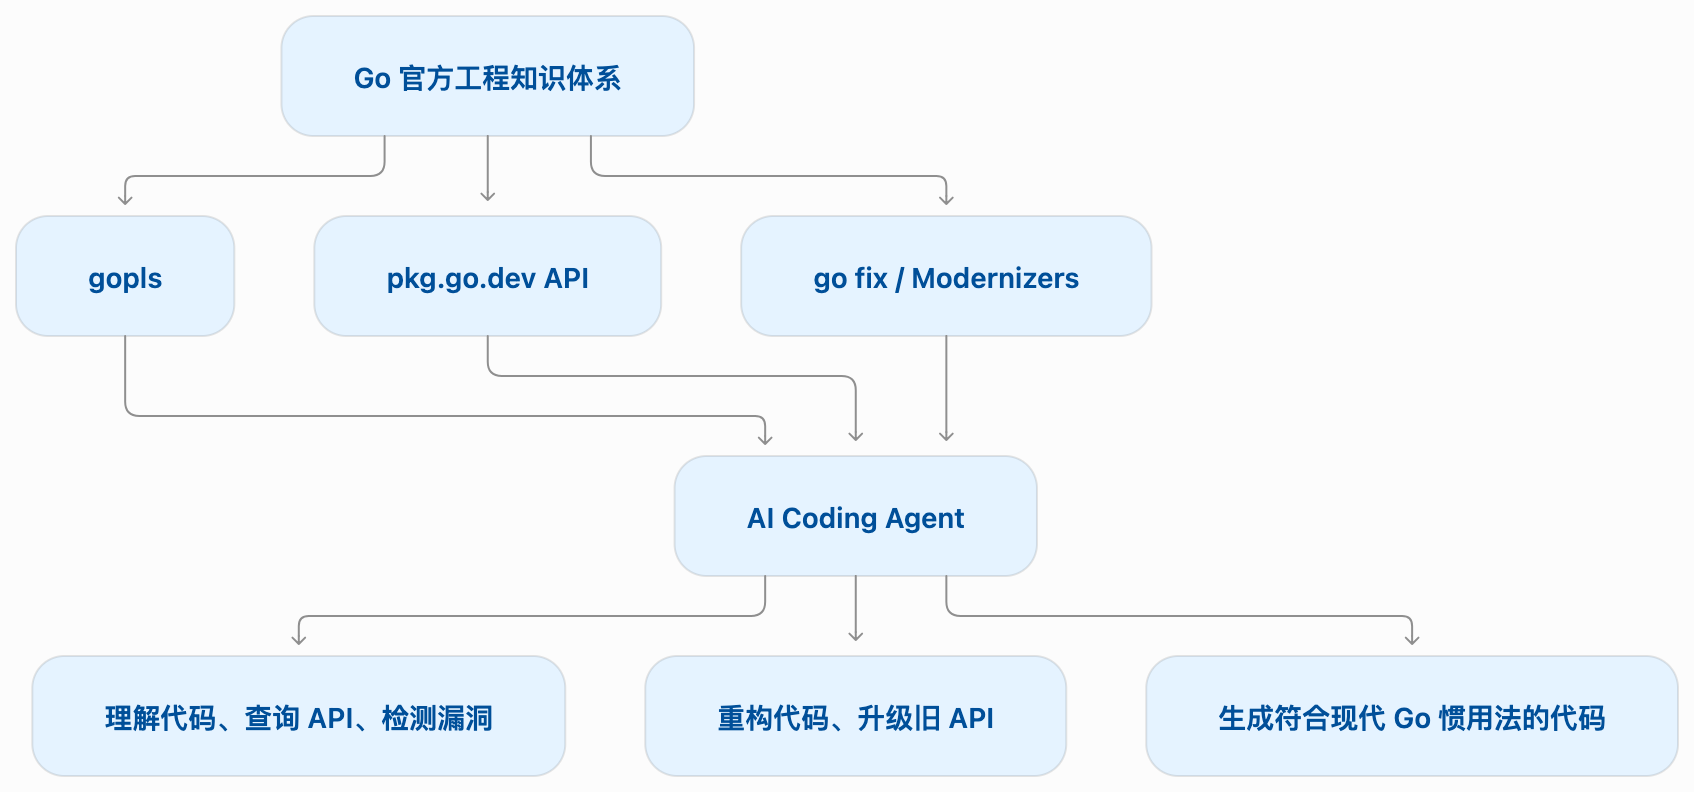
这套体系有一个很重要的特点:
它不是简单地给 AI 增加一个聊天接口,而是在为 AI 提供能够理解、验证和操作 Go 工程的权威工具。
我尤其欣赏 Go 团队对这个问题的理解。
AI 模型的能力固然重要,但模型并不天然掌握最新的语言规范、API 变化和项目约定。
如果能够让 AI Agent 随时调用权威工具,获取准确的工程信息,再通过自动化分析和迁移工具验证自己的输出,那么它生成的代码就更有机会达到生产级要求。
这也是为什么 Go 团队正在持续投资 gopls、MCP Server、go fix 和 pkg.go.dev API。
Go 团队实际上是在把过去积累的工程经验,逐渐转化为 AI Agent 可以直接使用的机器可读能力。
我认为,这可能是 Go 未来几年最值得关注的战略方向之一。
文章最后,Austin Clements 披露了 Go 接下来一年的工作重点。
其中有几项尤其值得关注。
Go 1.28 将支持在能够从上下文推断类型的情况下,省略复合字面量中冗余的类型信息。
例如,过去嵌套结构体初始化时,可能需要重复书写类型:
type Server struct {
    Addr string
    TLS  TLSConfig
}

type TLSConfig struct {
    Enabled bool
}

servers := []Server{
    {
        Addr: "localhost:8080",
        TLS: TLSConfig{
            Enabled: true,
        },
    },
}
未来可以省略部分冗余类型:
servers := []Server{
    {
        Addr: "localhost:8080",
        TLS: {
            Enabled: true,
        },
    },
}
对于复杂配置、API 请求结构体和表驱动测试,这会减少不少视觉噪声。
Go 团队已经接受了一批泛型集合相关提案,包括:
这些 API 将先进入 golang.org/x/exp,供社区试用和反馈,再考虑未来进入标准库。
对于长期以来习惯使用 map[T]struct{} 实现集合的 Gopher 来说,这无疑值得期待。
Go 团队正在努力让 simd 和 simd/archsimd 的大部分功能在 Go 1.28 中正式发布。
覆盖范围包括 amd64、arm64 NEON 和 WebAssembly。
Go 1.29 则计划进一步支持 arm64 SVE。
这意味着 Go 在高性能计算领域有望获得更完整的底层硬件支持。
文章特别提到,在全球内存资源日益紧张的背景下,降低 Go 程序的内存占用将成为未来一年的重要工作。
这与 Go 在容器、云原生和大规模服务端场景中的实际需求高度相关。
Go 团队还在探索一个长期以来颇受关注的方向:让 cgo 构建不再依赖完整的 C 工具链。
如果最终实现,将进一步降低 Go 项目的构建和交付复杂度。
此外,Go 团队还在研究 WebAssembly 的 stack-switching 扩展,希望进一步改善 Go Wasm 程序的性能和二进制大小。
文章最后一部分,我认为同样值得重视。
Go 团队正在推动项目治理机制改革。
过去,Go 的核心技术决策和维护工作相对集中在 Google 内部。
但近年来,一些重要成果已经明显体现出社区协作的力量。
例如:
encoding/json/v2。goroutineleak。这些项目都得到了 Google 之外贡献者的深度参与。
因此,Go 团队正在考虑:
这实际上是在推动 Go 从一个以 Google 核心团队为主导的开源项目,逐步演进为一个技术治理更加开放的全球协作社区。
对于一个已经走过 17 年的编程语言项目来说,这种变化非常重要。
技术可以不断迭代,但一个开源项目要想长期保持活力,还必须解决贡献者如何成长、技术决策如何形成、维护责任如何分担的问题。
Go 团队显然已经开始认真面对这些问题。
读完 Austin Clements 的这篇文章,我有一个比较强烈的感受:
Go 团队正在坚持一种非常鲜明的长期主义。
这种长期主义体现在几个方面。
第一,语言设计保持克制。
Go 没有因为其他语言增加了什么特性,就急于跟进。泛型、语法、标准库的演进,都尽可能建立在真实工程需求之上。
第二,性能优化深入底层。
从 Green Tea GC 到 SIMD,再到内存分配器优化,Go 团队正在让这门语言更充分地利用现代硬件,而不是仅仅依靠编译器层面的局部优化。
第三,安全建设覆盖整个生命周期。
从后量子密码学,到漏洞数据库、govulncheck 和紧急安全发布机制,Go 正在构建一套完整的软件安全防线。
第四,开发工具链主动拥抱 AI。
这是我认为最值得关注的变化。
Go 团队没有把 AI 看成一个独立于语言生态之外的外部工具,而是开始重新审视整个开发工具链:如何让 AI 获得准确的文档、理解真实的代码结构、遵循现代编程惯用法,并且能够安全地完成代码迁移和重构。
这其实也给其他编程语言生态提供了一个值得思考的方向:
AI 时代,编程语言的竞争力,不再仅仅取决于语法、性能和生态库的数量,还取决于它能否为 AI Agent 提供高质量、结构化、可验证的工程上下文。
当然,Go 并没有因为 AI 而放弃自己的基本原则。
Austin Clements 在文章开头就强调,Go 仍然坚持简洁、可靠、高效和兼容性。
我觉得这恰恰是 Go 最值得珍惜的地方。
17 年前,Go 试图解决的是大规模软件工程中的复杂性问题。
17 年后,面对 AI 带来的新一轮软件工程变革,Go 依然在解决同一个问题,只不过这一次,工程参与者已经从人类程序员扩展到了 AI Agent。
Go 17 岁了。它没有急着变成另一门语言,而是在努力成为 AI 时代更可靠的软件工程基础设施。
对于所有 Gopher 来说,这应该是一个值得期待的未来。
生日快乐,Go!
延伸阅读:
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
「Go & AI 精进营」已全面升级为「Go, Rust & AI 精进营」知识星球,快来加入星球,开启你的技术跃迁之旅吧!
我们致力于打造一个高品质的 现代系统级开发(Go / Rust) 与 前沿 Agentic AI 工程实践 平台。在这里,你将获得:
衷心希望「Go, Rust & AI 精进营」能成为你拓宽技术边界、持续精进与交流的温暖港湾。让我们在此相聚,享受代码与工程之美以及技术精进的快乐!欢迎你的加入!

商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
2026-11-11 09:00:00
本文永久链接 – https://tonybai.com/2026/11/11/musk-rust-c-ai-inference-stack
大家好,我是Tony Bai。
【导读】
马斯克最近在 X 上的一番言论,让 C 与 Rust 之间的老话题再次升温。为了 Grok 4.8,xAI 据称放弃了 JAX/SGLang,转而使用 C/C++ 从头重写强化学习和推理技术栈。当有人问为什么不用 Rust 时,Musk 回答:“真男人自己管理内存。”
这究竟是一次技术路线选择,还是一场程序员之间的语言信仰之争?在 AI 基础设施越来越依赖极致性能、内存效率和硬件控制能力的今天,C、C++ 和 Rust 的竞争,正在呈现出一些值得重新审视的变化。
【文章要点】
【Go, Rust & AI 精进营】一年仅一次 · 双 11 限时特惠,长按下方图片扫码,直降入营:
2026 年 11 月 11 日,Elon Musk 在 X 上发布了一条关于 Grok 4.8 的消息。
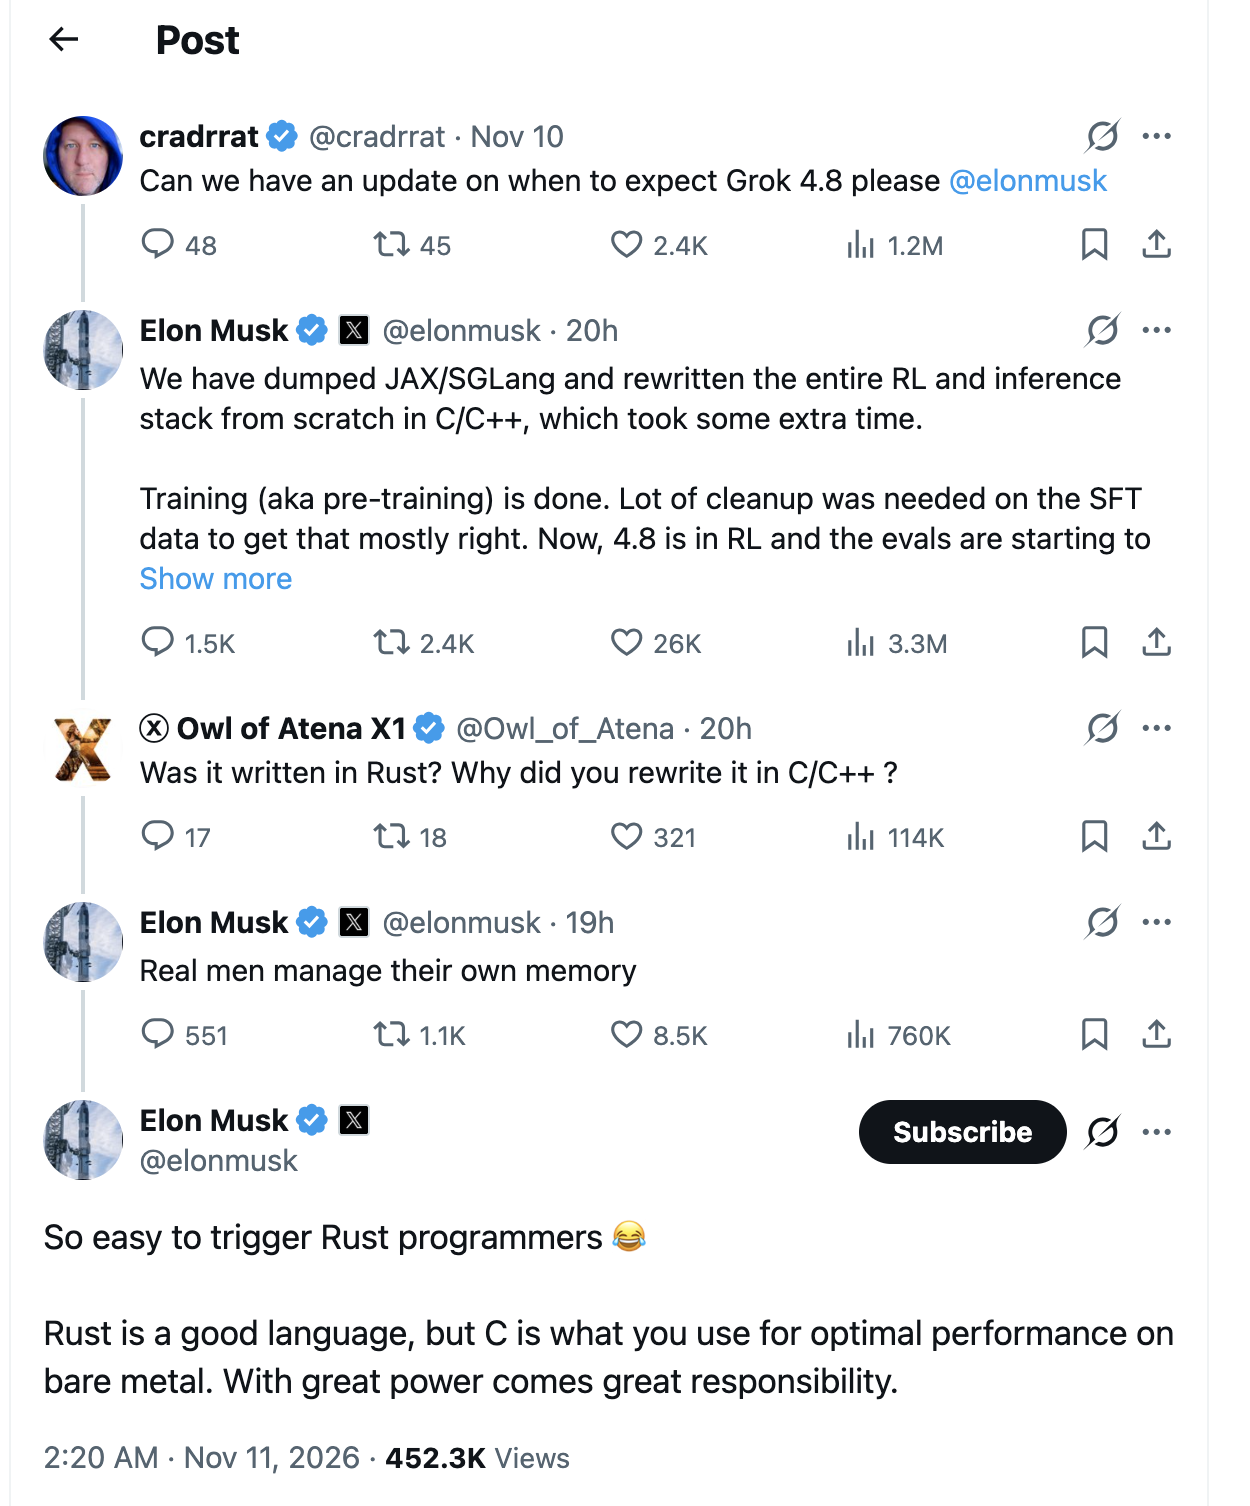
事情的起因,是一位 X 用户询问:Grok 4.8 什么时候可以发布?
Musk 给出的回答透露了一个相当有意思的工程细节:
We have dumped JAX/SGLang and rewritten the entire RL and inference stack from scratch in C/C++, which took some extra time.
翻译过来就是:
我们已经放弃了 JAX/SGLang,从头使用 C/C++ 重写了整个强化学习和推理技术栈,这花费了额外的时间。
他还透露,预训练已经完成,团队对 SFT(监督微调)数据进行了大量清理,现在 Grok 4.8 已经进入 RL 阶段,评估工作也开始启动。
这条消息本身已经足够引人关注。
JAX 是现代机器学习领域的重要计算框架,SGLang 则是面向大语言模型推理的重要系统。xAI 决定放弃这套技术组合,转而用 C/C++ 从头重写整个 RL 和 Inference 技术栈,这显然不是一个轻松的工程决定。
随后,一位 X 用户提出了一个很直接的问题:
Was it written in Rust? Why did you rewrite it in C/C++?
既然要重写底层技术栈,为什么不选择 Rust?
Musk 的回答只有一句:
Real men manage their own memory.
“真正的男人,自己管理内存。”
这句话迅速点燃了 Rust 社区。
随后,Musk 又补充了一条:
So easy to trigger Rust programmers 😂
紧接着,他给出了相对正式的技术解释:
Rust is a good language, but C is what you use for optimal performance on bare metal. With great power comes great responsibility.
Rust 是一门很好的语言,但如果你想在裸金属上获得最佳性能,C 才是你的选择。能力越大,责任越大。
一场原本关于 Grok 4.8 技术栈的讨论,就这样变成了 C 与 Rust 的又一次正面交锋。
但如果我们暂时放下语言阵营之间的情绪,这场讨论其实提出了一个很有价值的问题:
当 AI 基础设施开始追求极致性能时,开发者是否正在重新审视那些曾经被认为已经过时的底层编程语言?
首先,我们需要理解 xAI 这次重写的对象。
Musk 并没有说要用 C/C++ 重写整个 Grok 模型,也没有说要用 C 替代所有机器学习框架。
他明确提到的是两个部分:
这两个领域恰恰是 AI 基础设施中对系统性能非常敏感的部分。
第一,推理系统需要极致的资源利用率。
大模型推理不是简单地执行一次矩阵乘法。
一个生产级推理系统需要处理:
这些环节中的任何一个成为瓶颈,都可能影响整个系统的吞吐量和延迟。
尤其是 KV Cache。
随着上下文长度和并发请求数量增加,KV Cache 会占用大量 GPU 显存。如何管理这些缓存、如何减少内存碎片、如何提高显存利用率,直接关系到推理系统的经济性。
这时,底层内存管理能力就显得非常重要。
第二,强化学习系统同样是一个复杂的分布式系统问题。
大模型 RL 并不是简单地调用一个优化器。
在典型的 RL 训练系统中,通常涉及多个角色:
这些组件之间需要大量的数据传输、任务调度和同步。
当训练规模扩大时,系统调度、通信和内存管理本身就可能成为性能瓶颈。
第三,C/C++ 能够提供更直接的底层控制。
C 和 C++ 已经在高性能计算、操作系统、编译器、数据库、网络协议栈和 GPU 软件生态中积累了数十年的工程经验。
它们能够让开发者直接控制:
对于追求极致性能的系统工程师来说,这些能力非常有吸引力。
要理解这场争论,我们需要回到两门语言最核心的设计差异。
C 的哲学可以概括为:
把控制权交给程序员。
Rust 的哲学则可以概括为:
尽可能在编译阶段证明程序的内存使用是安全的。
两者并不是简单的性能竞争,而是对程序员责任边界的不同设计。
C 语言没有内置的所有权系统,也没有编译器强制执行的借用检查机制。
程序员可以直接操作指针,申请和释放内存,控制对象的生命周期。
例如:
#include <stdlib.h>
#include <stdio.h>

int main(void) {
    int *p = malloc(sizeof(int));

    if (p == NULL) {
        return 1;
    }

    *p = 42;

    printf("%d\n", *p);

    free(p);
    return 0;
}
代码非常直接。
但如果程序员忘记调用 free,就可能产生内存泄漏。
如果在 free 之后继续访问指针,就可能产生 Use-After-Free。
如果重复释放同一块内存,就可能产生 Double Free。
这些问题不会因为 C 语言本身而自动消失。
C 的优势是控制权,代价是程序员必须承担更多责任。
Rust 引入了 Ownership、Borrowing 和 Lifetime 三个重要概念。
它试图通过编译期检查,在不依赖垃圾回收器的前提下,保证内存安全。
例如:
fn main() {
    let s = String::from("hello");

    let r = &s;

    println!("{}", r);
}
Rust 编译器会跟踪变量的所有权和引用关系。
当程序违反所有权规则时,编译器会拒绝编译。
例如:
fn main() {
    let s = String::from("hello");

    let r = &s;

    drop(s);

    println!("{}", r);
}
这段代码无法通过编译。
因为 s 已经被释放,引用 r 却仍然试图访问它。
Rust 的借用检查器在编译阶段就发现了这个问题。
这意味着很多 C 程序中需要依靠代码审查、测试、动态检测才能发现的内存安全问题,可以在 Rust 编译阶段直接被拦截。
两种语言的设计差异可以简单归纳为:
| 维度 | C | Rust |
|---|---|---|
| 内存管理 | 手动管理为主 | 所有权与借用 |
| 内存安全 | 主要依赖程序员 | 编译期强制检查 |
| 指针操作 | 高度自由 | 受安全规则约束 |
| 抽象控制 | 直接、显式 | 提供丰富的零成本抽象 |
| 并发安全 | 主要依赖程序员 | 类型系统提供支持 |
| 生态成熟度 | 极其成熟 | 持续快速发展 |
| 学习成本 | 语言本身相对简单 | 所有权系统有一定门槛 |
这里有一个容易被忽略的事实:
Rust 并不意味着牺牲性能来换取安全。
Rust 的设计目标之一就是零成本抽象。它不依赖传统垃圾回收机制,经过优化后,完全可以达到与 C/C++ 相当的性能。
因此,Musk 说 C 能够获得最佳性能,并不能直接推导出 Rust 在性能上存在天然劣势。
真正的差异更多体现在具体实现、工具链、生态、工程团队经验,以及对底层资源控制的需求上。
Rust 这些年发展得非常快。
从 Linux 内核开始接受 Rust 代码,到 Android 将 Rust 用于部分系统组件,再到各种基础设施项目逐渐采用 Rust,它已经不再只是一个有趣的编程语言实验。
Rust 最大的价值,是让系统软件开发者有机会在保持高性能的同时,减少一大类内存安全问题。
尤其是在操作系统、网络服务、数据库、存储引擎和安全敏感组件中,这种能力非常有价值。

但这并不代表 C 就应该退出历史舞台。
事实上,C 的优势并不只是性能。
它还有几个短期内很难被替代的特点:
1. 极其成熟的生态系统。
操作系统、编译器、嵌入式软件、GPU 驱动和大量基础设施,都建立在 C/C++ 生态之上。
替换这些系统,不只是换一种语言,而是涉及整个工具链、ABI、依赖关系和工程体系。
2. 与硬件和现有系统的集成能力。
C 拥有成熟的 ABI 和 FFI 生态。
在很多需要直接对接现有 C 库、硬件驱动和底层 Runtime 的场景中,C 仍然非常方便。
3. 团队经验和工程成本。
对于一支已经积累大量 C/C++ 经验的团队来说,使用熟悉的语言重写关键组件,可能比引入一套新的语言体系更容易控制交付风险。
当然,这只是可能的工程考量,并不代表我们已经知道 xAI 做出这一决策的全部原因。
反过来看,Rust 也有自己的优势。
对于新开发的系统组件,如果项目对内存安全、并发安全和长期可维护性有很高要求,Rust 往往是非常有竞争力的选择。
因此,C 与 Rust 并不是简单的替代关系。
它们更像是两种不同的工程工具。
一个强调最大程度的控制自由,一个试图把更多安全保证前置到编译阶段。
真正优秀的工程师,不应该因为语言阵营而拒绝合适的工具。
我认为,这场讨论还有一个值得关注的背景:AI Coding Agent 正在改变软件开发的生产方式。
过去,选择一门编程语言,往往需要考虑很多因素:
这些因素依然重要。
但 AI Agent 的出现,正在改变其中一部分约束。
过去,使用 Rust 的一个门槛是开发人员需要理解所有权、生命周期和复杂的类型约束。
现在,AI Agent 可以帮助开发者生成 Rust 代码、解释编译器错误、修复生命周期问题,甚至完成跨模块重构。
这并不意味着 Rust 的学习成本消失了,但它确实可能降低日常开发中与语言机制交互的成本。
与此同时,AI 也让 C 这样的语言重新获得了一些关注。
如果 AI Agent 能够辅助开发者处理指针操作、内存管理、边界检查和复杂的底层代码,那么 C 的一些开发门槛也可能被部分降低。
但这里必须强调:
AI 能够生成代码,不等于 AI 能够保证代码安全。
尤其是在 C 这样的语言中,AI 生成的代码同样可能包含缓冲区溢出、Use-After-Free、数据竞争等问题。
最终仍然需要静态分析、动态检测、模糊测试和严格的代码审查。
更有意思的是,AI Agent 可能让未来的编程语言选择更加多样化。
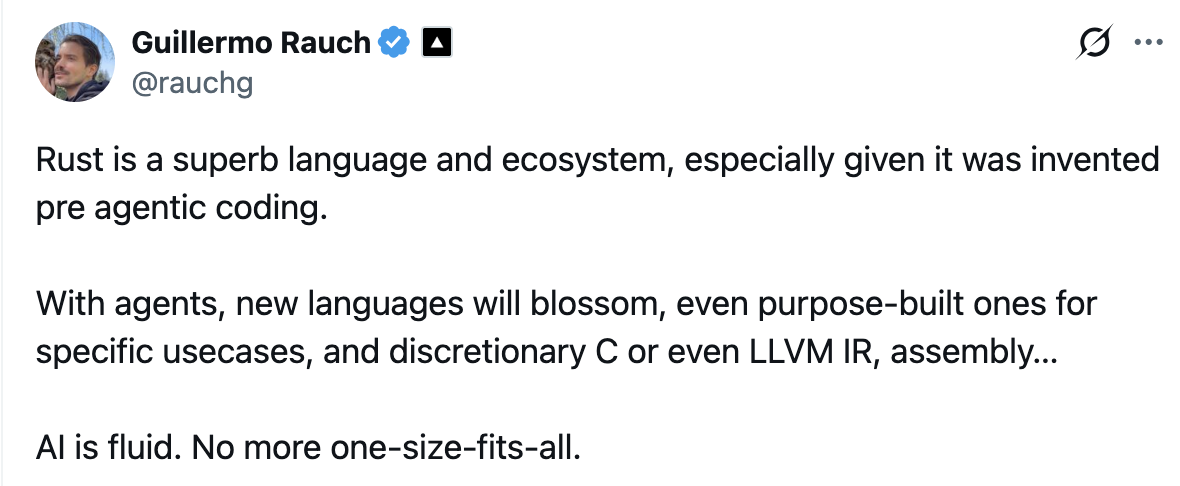
Vercel CEO Guillermo Rauch 在相关讨论中表达过一个值得关注的观点:Rust 有自己的优势,但 AI Agent 可能推动开发者创造更适合特定任务的语言,而不是所有人都依赖一种通用语言。
这个判断值得认真思考。
我们可以设想一个未来的软件工程场景:
开发者描述一个系统的性能、安全性和部署要求,AI Agent 根据具体任务选择合适的语言、运行时和工具链。
例如:
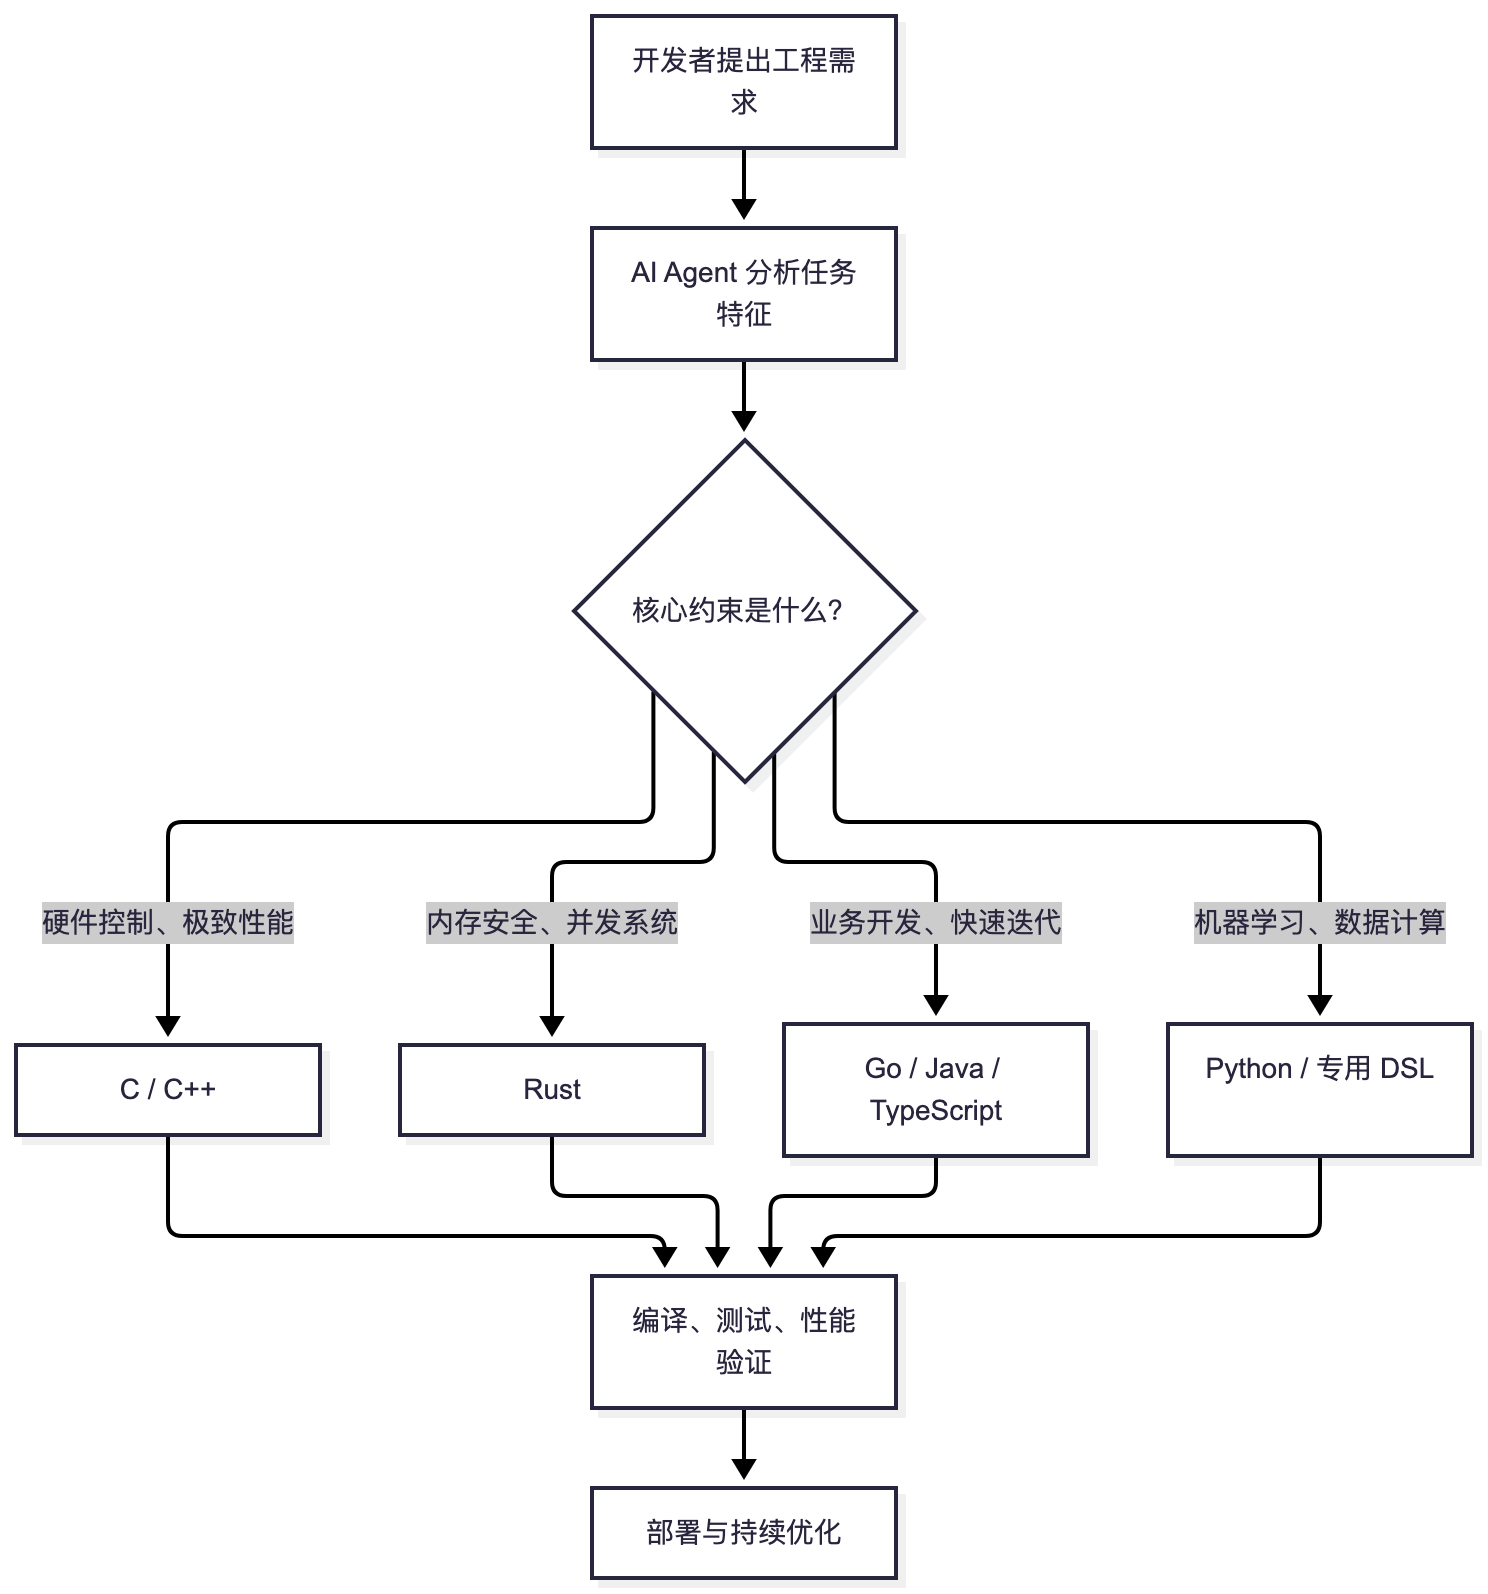
这张图表达的并不是未来一定会出现一个能够自动选择所有语言的万能 Agent,而是一种正在变得合理的工程思路:
语言不再是开发者的身份标签,而是 AI Agent 可以根据任务约束选择的工程工具。
甚至不排除未来出现更多针对特定硬件、特定计算任务和特定 Agent 工作流设计的领域专用语言。
当然,专用语言并不意味着通用语言会消失。编译器、调试器、工具链、生态和维护成本,依然会限制新语言的实际应用范围。
但 AI 确实可能降低语言设计、编译器实现和语言迁移的成本。
这可能是 AI 对编程语言生态带来的一个长期影响。
回到 Musk 的那句话:
“Rust 是一门好语言,但要在裸金属上获得最佳性能,你应该使用 C。”
这句话有它的工程立场,也有它的争议性。
C 确实拥有极强的底层控制能力,但控制权越大,犯错的空间也越大。
Rust 确实能够通过所有权和借用检查器消除大量内存安全问题,但它也不是所有系统工程场景下的唯一答案。
更重要的是,我们目前并不知道 xAI 为什么最终选择 C/C++,也没有看到这次重写带来了多少实际性能收益。Musk 的发言说明了技术路线,却还不足以证明这条路线在所有维度上都优于原来的方案。
所以,与其争论 C 和 Rust 谁才是未来,不如关注一个更本质的问题:
在 AI 时代,我们应该如何为具体的工程问题选择最合适的技术栈?
我的看法是:
未来的软件系统,很可能不是由一种语言统治,而是由多种语言协同构建。
而 AI Agent 会进一步降低跨语言协作的成本。
最后,我想借用 Musk 那句话的后半句:
With great power comes great responsibility.
能力越大,责任越大。
这句话放在 C 语言身上很合适,放在 Rust 身上同样合适。
毕竟,编程语言可以帮助我们减少错误,但最终对软件质量负责的,始终是构建系统的人。
真正成熟的程序员,不应该为自己使用哪门语言而自豪,而应该为自己能够用合适的技术解决复杂问题而自豪。
延伸阅读:
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
「Go & AI 精进营」已全面升级为「Go, Rust & AI 精进营」知识星球,快来加入星球,开启你的技术跃迁之旅吧!
我们致力于打造一个高品质的 现代系统级开发(Go / Rust) 与 前沿 Agentic AI 工程实践 平台。在这里,你将获得:
衷心希望「Go, Rust & AI 精进营」能成为你拓宽技术边界、持续精进与交流的温暖港湾。让我们在此相聚,享受代码与工程之美以及技术精进>的快乐!欢迎你的加入!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
2026-11-11 06:00:00
本文永久链接 – https://tonybai.com/2026/11/11/state-of-golang-2026-ai-agents-ecosystem
大家好,我是Tony Bai。
【导读】
JetBrains 刚刚发布了《The State of Go in 2026》。这份年度报告基于近 2.9 万名开发者的调查,其中有 1,836 名开发者将 Go 列为主要编程语言。
报告呈现出几个明显的变化:Go 标准库的 HTTP 能力正在重新获得开发者青睐;Go 开发者越来越倾向于采用 Go + TypeScript 的组合;Rust 正在成为 Gopher 最愿意尝试的第二语言;而最值得关注的是,AI Agent 已经深度进入 Go 开发者的日常工作流。
86% 的 Go 开发者每周至少使用一次 CLI/Terminal AI Agent,84% 每周使用 AI Agent 开发功能或程序。
这不是简单的 AI 代码补全,而是开发者工作方式的一次转变。
恰逢 Go 在 2026 年 11 月重新进入 TIOBE 编程语言排行榜前十,我们不妨借助 JetBrains 的年度调查,看看 Go 生态究竟正在走向何方。
【文章要点】
net/http 使用率从 2025 年的 32% 上升到 46%,已经接近 Gin 的 48%。encoding/json/v2 和 Green Tea GC 是值得关注的进展。【Go, Rust & AI 精进营】一年仅一次 · 双 11 限时特惠,长按下方图片扫码,直降入营:
11 月 10 日,JetBrains 发布了新一期年度 Go 生态报告:
这份报告值得每一位 Gopher 花些时间阅读。
首先看一下调查规模:2026 年 5 月至 7 月,JetBrains 共收集了 28,945 名开发者的反馈,其中 1,836 人将 Go 列为自己的主要编程语言。
这意味着,我们看到的不只是 Go 工具链的变化,还有一群真实 Go 开发者的技术选择、工作习惯和职业观念。
与此同时,11 月份的 TIOBE Index 也带来了一个小消息:Go 以 1.69% 的指数回到了排行榜第十位,取代了排名第十一的 Rust。
不过,TIOBE 的排名主要依据搜索引擎中的语言相关内容、技术讨论、课程等信号,并不直接代表实际开发者数量、生产环境使用规模或代码产出。它的统计方法和代表性也一直存在争议。因此,这个排名可以作为一个观察信号,却不应该成为判断 Go 生态健康程度的依据。
真正值得关注的,是 JetBrains 报告中的另外几个数字。
先来看 Go 开发者群体本身。
JetBrains 的调查显示,Go 开发者中,拥有六年以上专业编程经验的比例达到 66%,而所有受访开发者的这一比例只有 49%。
换句话说,Go 开发者是一群明显更加资深的工程师。
这背后还有几个有意思的数据:
尤其值得注意的是,Go 并不是一门只存在于企业工作任务中的语言。
70% 的开发者还会在个人项目中使用 Go。这说明不少人即使脱离公司的技术选型约束,依然愿意主动选择 Go。
这是一种很有价值的生态信号。
一门语言的生命力,不仅取决于有多少企业在生产环境中使用它,也取决于开发者是否愿意在工作之外继续使用它。
从调查数据看,Go 在这一点上表现不错。
另外,70% 的 Go 开发者表示,未来 12 个月没有计划迁移或采用其他编程语言。这一比例在 2024 年还是 64%。
这并不意味着 Go 开发者不愿意学习新技术,而是说明他们对现有技术栈有较强的认同感。
报告显示,Go 开发者的薪资水平也相对较高:年收入超过 12 万美元的比例为 17%,整体受访者为 13%;年收入超过 18 万美元的比例分别为 9% 和 5%。
这与 Go 开发者整体经验更加丰富的特点是相吻合的。
我的观察是:Go 已经逐渐形成了一批经验丰富、对工程实践有较高要求、愿意长期投入的开发者群体。
这也是 Go 生态能够保持稳定的重要基础。
再来看技术栈。
这一部分有两个值得关注的趋势。
长期以来,Go 的 Web 开发生态中,Gin 一直是最受欢迎的框架之一。
但 2026 年的调查出现了一个明显的变化:
| Web 框架或工具 | 2025 | 2026 |
|---|---|---|
| Gin | 48% | 48% |
| net/http | 32% | 46% |
| gorilla/mux | 17% | 15% |
| chi | 12% | 15% |
| Echo | 16% | 13% |
| Fiber | 11% | 13% |
net/http 的使用率一年内从 32% 上升到 46%,已经非常接近 Gin 的 48%。
为什么会出现这种变化?
我认为至少有两个原因。
首先,Go 标准库本身在持续进化。
从 Go 1.22 开始,标准库 http.ServeMux 支持了更强大的路由匹配能力,包括 HTTP Method 匹配和路径通配符。
例如:
mux := http.NewServeMux()

mux.HandleFunc("GET /users/{id}", getUser)
mux.HandleFunc("POST /users", createUser)
mux.HandleFunc("DELETE /users/{id}", deleteUser)
过去,开发者可能需要引入第三方路由库才能方便地实现这些功能。现在,标准库已经覆盖了不少常见需求。
其次,AI Agent 正在改变开发者对框架的选择。
JetBrains 在报告中提出了一个很有意思的解释:随着 Agentic Development 的普及,框架帮助开发者处理重复性样板代码的优势正在减弱。
以前,使用框架可以减少大量重复代码;现在,AI Agent 本身就能够快速生成这些代码。
相比之下,标准库依赖更少、行为更容易预测,也更容易让 AI 理解和操作。
当然,这只是 JetBrains 对趋势的一种解释,并不是调查直接证明的因果关系。
但我认为,这个方向值得关注。
AI 时代,框架替开发者节省样板代码的价值可能下降,而语言和标准库本身提供的稳定抽象,反而可能变得更加重要。
另一个变化来自多语言协作。
在同一个项目中,Go 开发者最常搭配的语言已经是 TypeScript。
| 配合 Go 使用的语言 | 2024 | 2025 | 2026 |
|---|---|---|---|
| TypeScript | 24% | 31% | 43% |
| Python | 23% | 23% | 27% |
| JavaScript | 29% | 25% | 24% |
| Rust | 5% | 5% | 5% |
TypeScript 从 2024 年的 24% 增长到 2026 年的 43%,增幅非常明显。
与此同时,只使用 Go、不在同一个项目中搭配其他语言的开发者比例,从 2024 年的 35% 降到了 27%。
这说明 Go 开发者正在越来越多地采用多语言技术栈。
其中,一个非常自然的组合就是:
值得注意的是,Go 开发者使用 Go 进行全栈 Web 开发的比例,也从 2025 年的 30% 上升到了 2026 年的 40%。
另外,Go 开发者使用 Go 部署和管理 AI 模型的比例,从 3% 上升到了 6%,虽然目前仍然是一个小众方向,但增长了一倍。
这也反映出 Go 的应用场景正在向 AI 基础设施领域延伸。
这是整份报告中,我认为最值得重点讨论的部分。
如果说过去两年 AI 编程工具主要解决的是代码补全、代码解释和代码生成,那么 2026 年,开发者正在越来越多地把完整开发任务交给 AI Agent。
JetBrains 的调查数据非常直观。
先看每周至少使用一次 AI 的比例:
| AI 辅助开发任务 | Go 开发者 | 全体开发者 |
|---|---|---|
| 跨多个文件修改代码 | 89% | 83% |
| 使用 Agent 开发功能或程序 | 84% | 76% |
| 生成测试 | 83% | 72% |
| 生成注释或文档 | 83% | 76% |
| 头脑风暴 | 82% | 73% |
| 执行代码审查 | 80% | 72% |
这些数字说明,Go 开发者使用 AI 的方式已经超越了简单的代码补全。
他们更多地将 AI 用于跨文件修改、功能开发、测试生成和代码审查等较高层次的工程任务。
尤其值得注意的是终端 AI Agent。
86% 的 Go 开发者每周至少使用一次 CLI/Terminal AI Agent,而全体开发者的比例为 74%。
从不使用终端 AI Agent 的 Go 开发者只有 5%,全体开发者则高达 14%。
这意味着,终端已经成为 Go 开发者使用 AI 的一个重要入口。
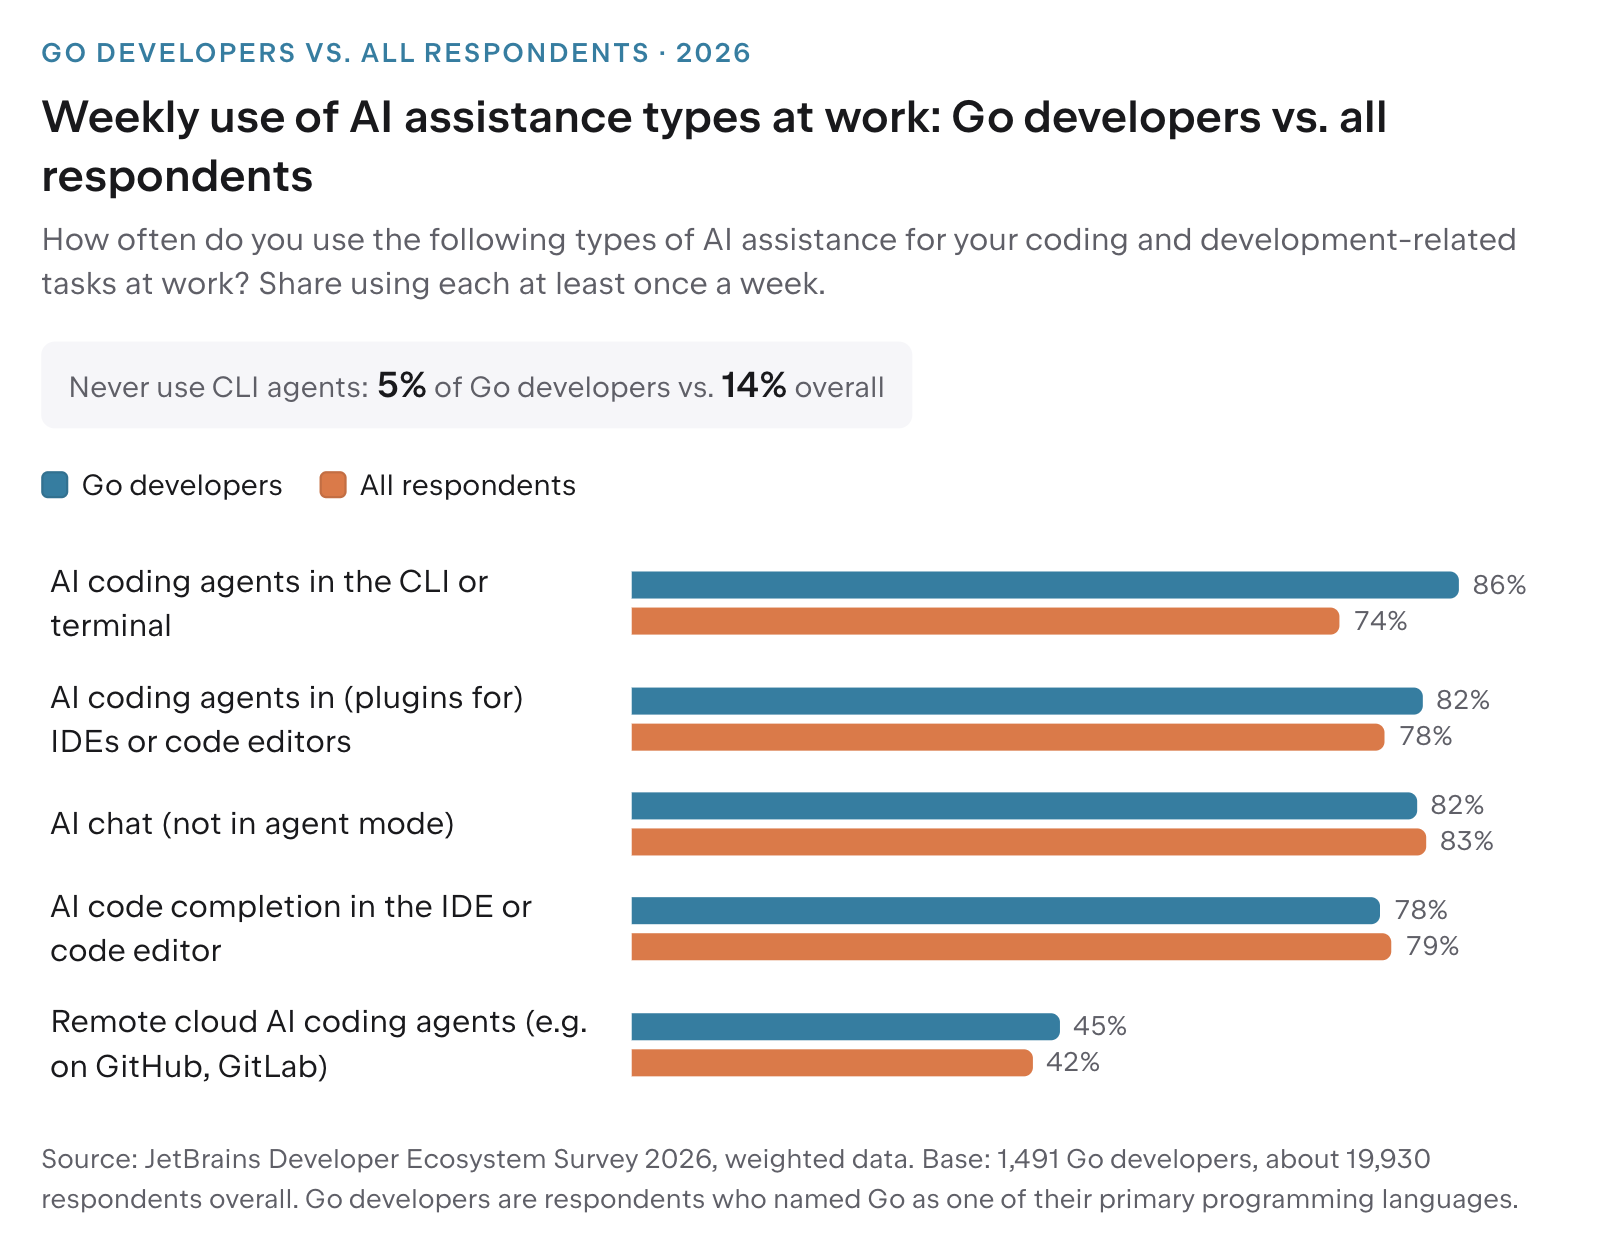
我认为,这与 Go 的工程特性存在一定关联。
Go 开发者长期习惯于使用命令行工具完成开发任务:
go build
go test ./...
go vet ./...
go fmt ./...
go mod tidy
这些命令具有明确的输入、输出和执行结果。
对于 AI Agent 来说,这意味着它可以通过执行命令、观察结果、修复问题、再次执行,形成一个相对清晰的反馈闭环。
Go 的静态类型、统一格式化工具、快速编译和标准化工具链,也让 Agent 更容易获得确定性的反馈。
这与 Google 工程师 Cameron Balahan 和 Richard Seroter 此前提出的观点不谋而合:Go 的设计特点使其非常适合 AI 辅助软件工程。
但报告中还有一个比 AI 使用率更值得关注的数字:
79% 的 Go 开发者经常或总是审查 AI 生成的代码,然后才接受它。
这说明,AI 使用率高,并不意味着开发者愿意无条件信任 AI。
JetBrains 还调查了 Go 开发者审查 AI 生成代码时最关注的内容:
| 审查维度 | 关注比例 |
|---|---|
| 功能正确性 | 79% |
| 代码质量 | 75% |
| 解决方案架构 | 69% |
| 代码安全性 | 64% |
| 代码可读性 | 62% |
| 是否符合项目规范 | 59% |
| 代码性能 | 56% |
这组数据很有意思。
开发者最关心的并不只是代码能不能运行,而是功能正确性、代码质量和架构是否合理。
这恰恰是 AI Agent 当前仍然需要人类参与的关键环节。
另外,29% 的 Go 开发者认为 AI 生成的解决方案不如自己完全手写的代码,这一比例甚至高于全体开发者的 25%。
这说明,Go 开发者并没有因为频繁使用 AI 就对 AI 产生盲目崇拜。
他们愿意让 AI 执行任务,但仍然保留工程判断权。
我认为,这才是 AI 时代更值得提倡的开发模式:
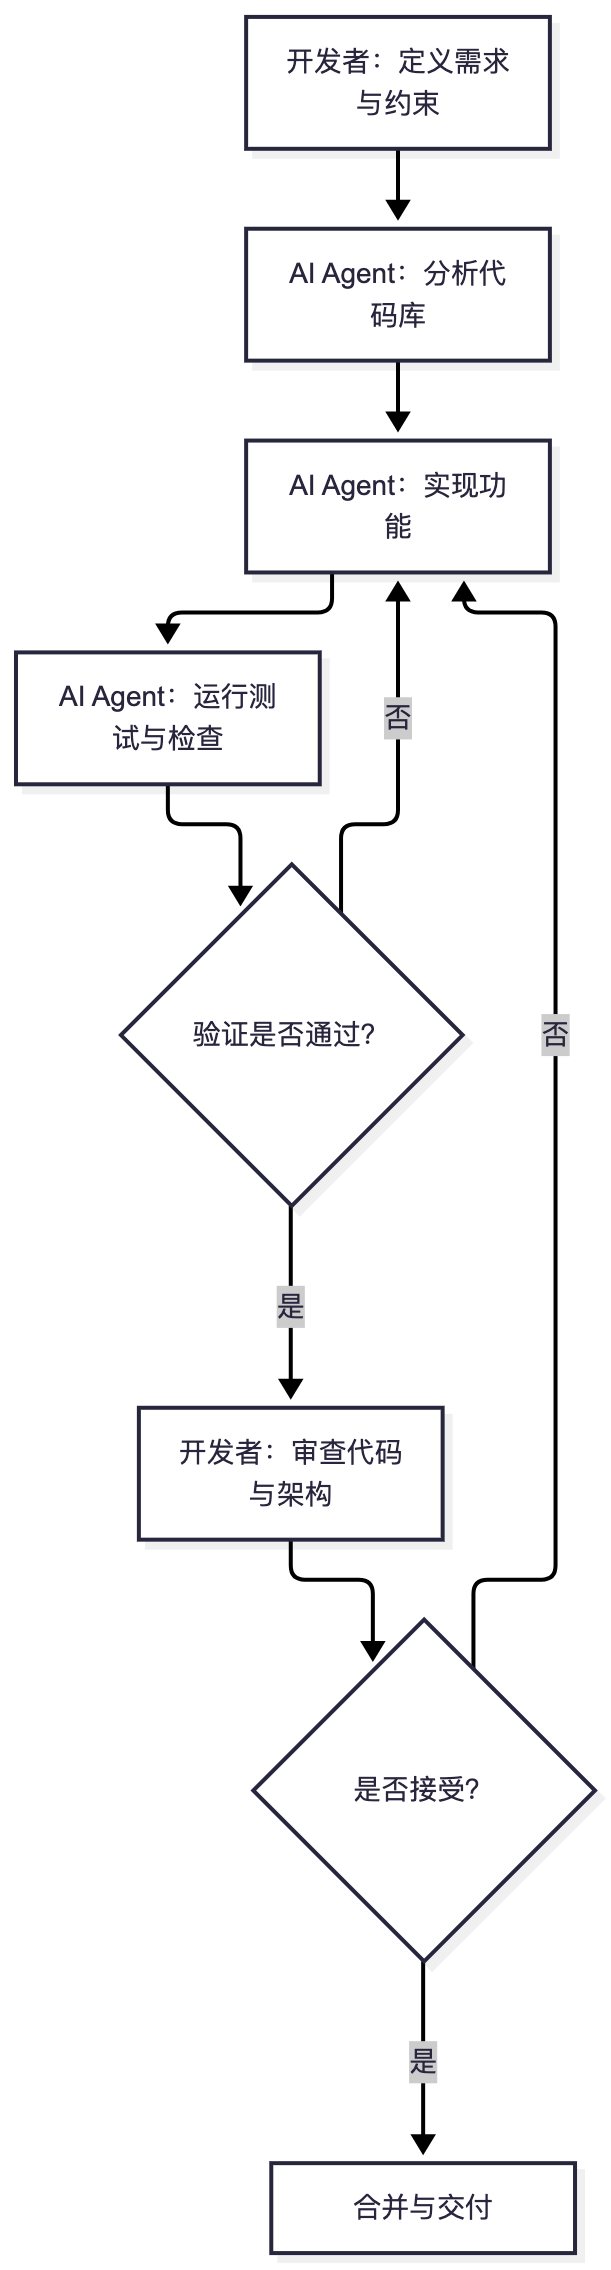
AI 负责提高执行效率,人类负责目标、约束、架构和质量。
这也解释了为什么 AI Agent 的普及并没有让 Go 开发者集体抛弃 IDE。
报告显示,44% 的 Go 开发者表示过去一年自己使用 IDE 的时间增加了,超过表示使用时间减少的 33%。另外,61% 的 Go 开发者每天都会在 IDE 中运行 Coding Agent。
终端 Agent 和 IDE 并不是非此即彼的关系。
越来越多的开发者正在形成一种混合工作流:终端负责自动化任务和复杂操作,IDE 负责代码浏览、调试、审查和精细修改。
真正发生变化的不是 IDE 是否还存在,而是 IDE、终端和 AI Agent 在开发流程中的分工。
再来看 Go 和 Rust 的关系。
2026 年的 TIOBE Index 中,Go 回到了第十位,Rust 则暂时跌到了第十一位。
但如果只看排名,很容易忽略 JetBrains 报告中的另一个重要信息。
在 Go 开发者计划学习的新语言中,Rust 仍然排在第一位,占比达到 16%。
同时,过去一年使用过 Rust 的 Go 开发者比例已经达到 25%。
也就是说,每四名 Go 开发者中,就有一名在过去一年接触或使用过 Rust。
不过,这并不意味着 Go 开发者正在大规模将现有 Go 服务改写为 Rust。
从调查数据看,Rust 更多是作为新技能、个人项目技术,或者性能敏感组件的实现语言被采用。
我更倾向于把这种关系理解为互补:
未来的软件系统,很可能不是由一种语言包打天下,而是由不同语言承担各自最擅长的部分。
对于 Go 开发者来说,学习 Rust 并不意味着放弃 Go,而是扩展自己的工程能力边界。
最后,我们再把视角拉回 Go 语言本身。
2026 年,Go 生态也迎来了一些值得关注的技术进展:
encoding/json/v2:JSON 编码和解码能力的重要演进。这些变化说明,Go 并不是一门停止进化的语言。
但与一些语言不断引入大量新语法和复杂抽象不同,Go 依然坚持自己的演进节奏:在保持语言整体简洁性的同时,持续改善开发者真正需要的能力。
我认为,这种克制在 AI Agent 时代可能具有新的价值。
为什么?
因为 AI Agent 开发软件,最需要的并不只是丰富的语言功能,而是能够快速理解项目、可靠地修改代码,并通过工具链获得明确反馈。
Go 的一些长期设计特点,恰好符合这些要求:
gofmt 减少了代码风格上的无谓争论。go test、go vet、go build 等工具具有一致的使用方式。这些特点过去主要是为了提高团队协作效率而设计的。
现在,它们也成为 AI Agent 参与软件工程时的优势。
这或许是 Go 在 AI 时代值得重新认识的地方。
回顾 JetBrains 2026 年的 Go 生态报告,我认为有三个趋势值得 Gopher 长期关注:
第一,Go 开发者群体正在变得更加成熟。
大量拥有多年经验的工程师持续选择 Go,并且愿意在个人项目中使用它。这种开发者认同感,是生态长期发展的重要基础。
第二,Go 的工程化优势正在重新获得价值。
标准库、统一工具链、静态类型和快速编译,不仅能够帮助人类开发者提高效率,也让 AI Agent 更容易参与真实的软件工程。
第三,AI Agent 正在改变 Go 开发者的工作方式。
86% 的 Go 开发者每周使用终端 AI Agent,84% 使用 AI 辅助开发功能或程序。但与此同时,79% 的开发者仍然经常或总是审查 AI 生成的代码。
这三个数字放在一起,可能比 Go 重回 TIOBE 前十更有意义。
Go 的下一阶段竞争力,或许不在于它能否成为排名最高的编程语言,而在于它能否继续成为构建可靠软件系统(尤其是 AI 原生系统)的优秀工程工具。
而在 AI Agent 开始深度参与软件开发的今天,Go 的简洁、稳定和工程化,可能正迎来一个新的价值窗口。
对于 Gopher 来说,值得学习的不只是如何用 Go 写代码,更是如何用 Go、AI Agent 和成熟的工程实践,一起构建软件。
报告原文:JetBrains:The State of Go in 2026 - https://blog.jetbrains.com/go/2026/11/10/state-of-golang-2026/
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
「Go & AI 精进营」已全面升级为「Go, Rust & AI 精进营」知识星球,快来加入星球,开启你的技术跃迁之旅吧!
我们致力于打造一个高品质的 现代系统级开发(Go / Rust) 与 前沿 Agentic AI 工程实践 平台。在这里,你将获得:
衷心希望「Go, Rust & AI 精进营」能成为你拓宽技术边界、持续精进与交流的温暖港湾。让我们在此相聚,享受代码与工程之美以及技术精进的快乐!欢迎你的加入!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
2026-11-10 09:00:00
本文永久链接 – https://tonybai.com/2026/11/10/rust-reference-array-slice-fn-params
大家好,我是Tony Bai。
【导读】
你写过 fn foo(s: [i32]) 吗?编译器会告诉你:大小在编译期未知。你又写过 fn foo(a: &[i32; 3]) 吗?它能跑,却只收长度为 3 的数组。[i32; 3]、[i32]、&[i32; 3]、&[i32],四个长得几乎一样的东西,是 Rust 初学者最容易搞混的语法细节之一。这篇文章用内存布局和函数传参的视角把它们彻底讲清楚,并和 C++、Go 做对比,最后给你一条可以直接抄走的结论。
【文章要点】
[i32; 3] 与 [i32; 4] 是两种不同的类型。[i32] 是动态大小类型(DST),不能单独作为变量或参数,只能藏在指针后面。&[i32; 3] 是瘦指针(8 字节),&[i32] 是胖指针(16 字节,地址加长度)。std::span 相比,Rust 的 &[T] 在语义上最接近 span,但有借用检查器保驾护航。&[T] 或 &mut [T],只有需要严格限定长度时才用 &[T; N]。&[T; N] 到 &[T] 靠的是编译器内置的非固定大小转换(Unsized Coercion),&Vec<T> 到 &[T] 靠的是 Deref 强制转换,二者机制不同。
假设你要写一个函数,打印一串整数。如果你从 Go 或 Python 转来,手感大概是这样的:
fn print_all(s: [i32]) {          // 编译失败
    println!("{:?}", s);
}
编译器会毫不客气地报错:error[E0277]: the size for values of type [i32] cannot be known at compilation time。
你改成 [i32; 3],能跑了,但传一个 4 个元素的数组又报错。你再改成 &[i32; 3],还是一样。最后,你在别人的代码里看到 &[i32],什么都能传,于是照抄,却不知道为什么。
这是 Rust 新手遇到的第一道“暗礁”,很多写了一两年的开发者也只是“知道这么写”,说不清背后的原理。这篇文章要解决的问题是:这四种写法到底差在哪里,函数参数应该怎么选?
这个问题值得花时间弄懂,因为Rust的所有权、借用、Vec、String、迭代器等,几乎都建立在“切片”这个概念之上。这里一知半解,后面每个知识点都会隐隐作痛。
我会先从内存布局讲起,再对比 C++ 和 Go,然后逐一分析四种函数形参,最后给你一张可以直接用的决策表。
假设要表达 1, 2, 3 这串整数,Rust 里有四种相关的类型。先看结论:
| 写法 | 名称 | 大小是否编译期已知 | 64 位系统下的大小 |
|---|---|---|---|
[i32; 3] |
定长数组 | 是 | 12 字节 |
[i32] |
切片(DST) | 否 | 不存在固定大小 |
&[i32; 3] |
数组引用 | 是 | 8 字节 |
&[i32] |
切片引用 | 是 | 16 字节 |
下面逐个拆解。
[i32; 3]它就是栈上连续的 3 个 i32,没有任何额外信息。关键在于:长度是类型的一部分。[i32; 3] 与 [i32; 4] 是两种不同的类型,关系就像 i32 和 String 一样,不能互相替代。
[i32]这是新手最大的坑。它的类型名里没有长度,意味着编译器无法知道它占多少字节。Rust 把这类类型称为动态大小类型(DST,Dynamically Sized Type)。而 Rust 要求局部变量和函数参数的大小必须在编译期确定,所以 let s: [i32] = ... 和 fn foo(s: [i32]) 都是非法的。DST 只能“躲在指针后面”使用。
&[i32; 3]这是一个普通的指针,只存首地址,占 8 字节。长度不用存,因为类型签名已经把“3”锁死了。
&[i32]这就是平时大家口中的“切片”。它是一个胖指针(Fat Pointer),由两部分组成:数据首地址(8 字节)和元素个数(8 字节)。长度信息从类型里搬到了运行时的值里。
用代码验证一下:
use std::mem::{size_of, size_of_val};

fn main() {
    let arr = [1, 2, 3];
    println!("{}", size_of::<[i32; 3]>());   // 12
    println!("{}", size_of::<&[i32; 3]>());  // 8
    println!("{}", size_of::<&[i32]>());     // 16
    println!("{}", size_of_val(&arr[..]));   // 12:切片指向的数据大小
}
内存布局如下图:
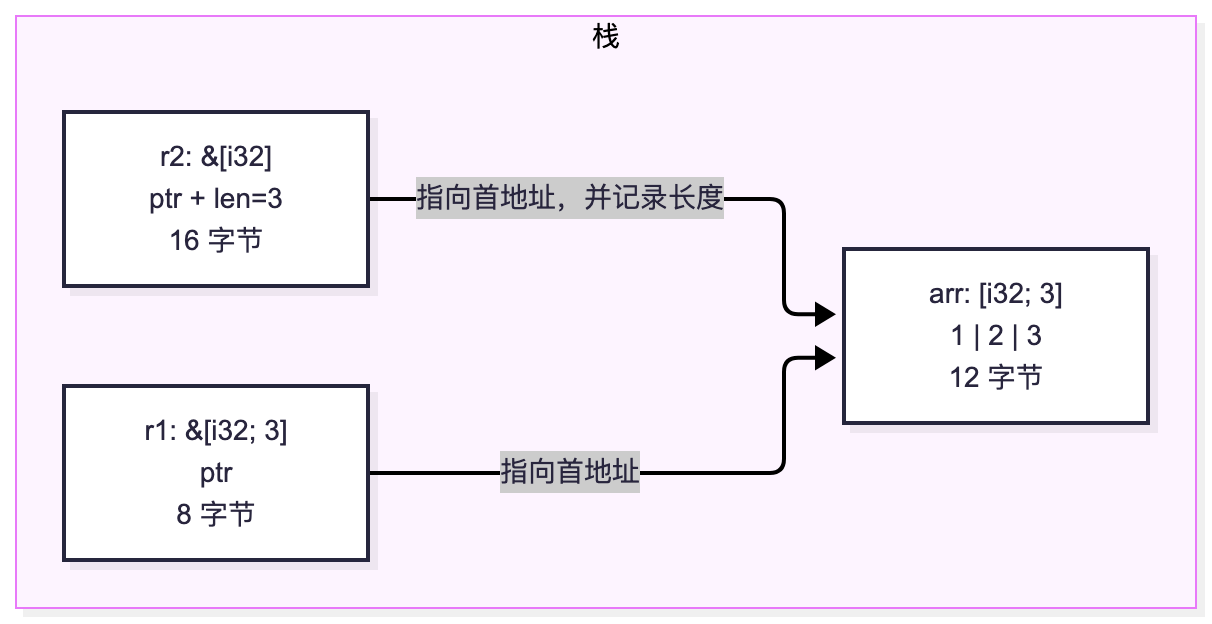
记住一个关键对比:瘦指针靠类型记住长度,胖指针靠值记住长度。这个差别决定了后面所有的行为。
理解 Rust 的设计取舍,最好的办法是看看别人怎么处理同一个问题。
C++:长度会丢失。
C++ 里的原生数组 int arr[3] 传给函数时会“退化”为指针,长度信息当场丢失:
void foo(int* p, size_t n);        // 必须额外传长度
void bar(int p[3]);                // 看似有长度,实际仍是 int*
bar 里的 sizeof(p) 得到的是指针大小,不是 12。这是无数越界 bug 的源头。C++20 引入的 std::span<int> 才算补上了这个缺口,它同样是“指针加长度”,在语义上与 Rust 的 &[i32] 最接近。
Go:切片是一等公民。
Go 把 [3]int(数组,值类型,传参会整体拷贝)和 []int(切片)都做进了语言里,且切片是 24 字节的描述符:指针、长度、容量。Go 的切片天然能“长大”,代价是多个切片可能共享同一块底层内存,写入互相影响,需要程序员自己小心。
Rust:把“视图”和“所有者”拆开。
&[i32] 只有指针和长度,没有容量,因为它只是一个借用的视图,既不拥有数据,也不负责扩容。扩容是 Vec<i32> 的事。
| C++ | Go | Rust | |
|---|---|---|---|
| 定长数组传参 | 退化为指针,丢失长度 | 整体拷贝 | 按值拷贝,或传引用 |
| 通用序列视图 |
std::span(C++20) |
[]int(24 字节) |
&[i32](16 字节) |
| 能否扩容 | 视图不能 | 切片可以(append) |
视图不能,Vec 可以 |
| 安全保证 | 无 | 无借用检查 | 借用检查器保证无悬垂、无别名写 |
所以你会发现:Rust 并不是“没有切片”,而是把切片拆成了更精确的两层:[T] 是数据,&[T] 是借用它的视图。
回到开头的问题。假设函数要读取一串整数,我们逐个分析。
写法 1:按值传数组 fn foo(arr: [i32; 3])
fn print_by_value(arr: [i32; 3]) { println!("{:?}", arr); }

let a = [1, 2, 3];
print_by_value(a);   // i32 是 Copy,整个数组被逐字节复制
问题有两个:只接受长度恰好为 3 的数组,且数组越大,栈上拷贝越贵。
写法 2:传数组引用 fn foo(arr: &[i32; 3])
fn print_array_ref(arr: &[i32; 3]) { println!("{:?}", arr); }

print_array_ref(&a);   // 只传 8 字节地址,无拷贝
没有拷贝了,但依然死板:你无法为它扩容,无法用它打印 [1, 2, 3, 4]。
写法 3:按值传切片 fn foo(s: [i32])
直接编译失败,原因前面说过:参数入栈需要确定大小,而 [i32] 是 DST。
写法 4:传切片引用 fn foo(s: &[i32])
这是标准库和绝大多数第三方库的做法:
fn print_slice(s: &[i32]) {
    println!("len: {}, data: {:?}", s.len(), s);
}

let arr3 = [1, 2, 3];
let arr5 = [1, 2, 3, 4, 5];
let v = vec![10, 20, 30];

print_slice(&arr3);        // 数组引用
print_slice(&arr5);        // 不同长度也行
print_slice(&arr5[1..4]);  // 子区间 [2, 3, 4]
print_slice(&v);           // 堆上的 Vec 也行
一个签名通吃四种输入。如果需要修改元素,用 &mut [i32]:它允许改写元素,但不能增删,因为“视图”没有扩容的能力。
你可能会问:我传的明明是 &[i32; 3] 或 &Vec<i32>,为什么能被 &[i32] 接收?这里其实有两套不同的机制,很多教程把它们混为一谈。
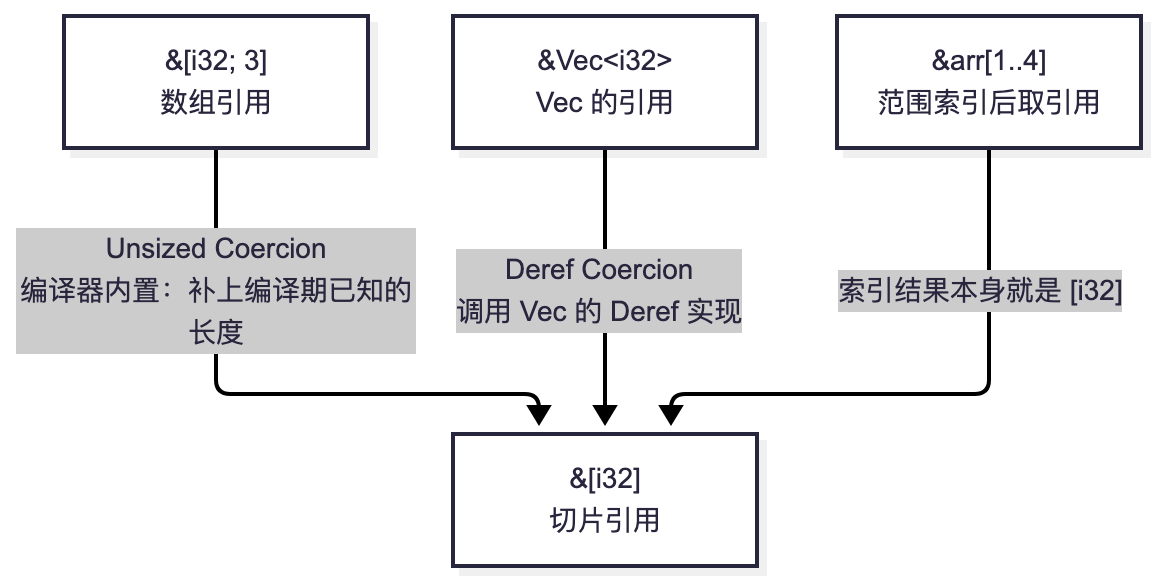
数组到切片:Unsized Coercion
编译器知道数组长度是 3,于是把 8 字节的瘦指针升级成 16 字节的胖指针,补上长度 3。这是编译器内置的转换,不经过 Deref。
Vec 到切片:Deref Coercion
Vec<T> 实现了 Deref<Target = [T]>,编译器在需要 &[T] 的地方,会自动对 &Vec<T> 解引用一次。String 到 &str、Box<T> 到 &T 也是同一套机制。
两者的共同点是:转换发生在函数调用处,由编译器自动完成,零额外成本。
1. 反向转换:从切片得到数组
有时你手里是 &[i32],却需要一个定长数组,比如解析二进制协议头:
let s: &[i32] = &[1, 2, 3, 4, 5];
let head: [i32; 3] = s[..3].try_into().unwrap();      // 拷贝出数组
let head_ref: &[i32; 3] = s[..3].try_into().unwrap(); // 或者得到数组引用
转换会在运行时检查长度,不匹配就返回 Err,因此用的是 try_into 而不是 into。
2. 既要定长,又要通用:const 泛型
如果你确实需要“任意固定长度”的数组参数,不要为每个长度写一遍函数,用 const 泛型:
fn sum<const N: usize>(arr: &[i32; N]) -> i32 {
    arr.iter().sum()
}
这样 N 在编译期被推导出来,长度仍然是类型的一部分,编译器可以据此做更激进的优化。
我们回顾一下这篇文章的主线:Rust 把“序列”拆成了数据本身([T; N]、[T])和对数据的借用(&[T; N]、&[T]),其中 [T] 因为大小未知,只能通过胖指针 &[T] 使用。
最后给你一张可以直接用的决策表:
| 你的需求 | 形参写法 | 说明 |
|---|---|---|
| 只读任意长度序列 | &[T] |
默认选择,兼容数组、Vec、子区间 |
| 就地修改元素 | &mut [T] |
可改元素,不能增删 |
| 必须恰好 N 个元素 |
&[T; N] 或 const 泛型 |
如矩阵运算、固定协议头 |
| 小型定长数据,需要所有权 | [T; N] |
如坐标 [f32; 2],仅限很小的数组 |
| 需要增删元素 | &mut Vec<T> |
视图做不到,需要所有者 |
一句话口诀:参数想通用,就写 &[T];想严格,才写 &[T; N]。
最后留两个思考题,欢迎在评论区讨论:
&mut [i32] 不能 push,而 &mut Vec<i32> 可以?impl AsRef<[i32]>,和 &[i32] 相比有什么取舍?还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
2026-11-10 06:00:00
本文永久链接 – https://tonybai.com/2026/11/10/go-cgo-without-c-toolchain-proposal-update
大家好,我是Tony Bai。
【导读】
9 月,Go 核心开发者 Matloob 提出了一个颇具想象力的方案:让 cgo 在调用预编译 C 库时,不再依赖 GCC、Clang 等 C 工具链。当时,这项提案引发了社区的广泛讨论。
近两个月过去,这项工作没有停留在设计讨论阶段。Matloob 连续提交了多个 CL,Go runtime 和编译器负责人 Cherry Mui 也在 11 月 4 日给出了专门用于 Proposal Review 的精简设计,将方案具体落实到了 cmd/go、cmd/cgo 和 runtime/cgo 三个层面。
其中,不仅包括新的 Binding 指令、动态库加载 API,还涉及 CGO_ENABLED 的行为调整。
这意味着,Go 正在尝试的不只是给 cgo 增加一种构建模式,而是重新梳理 Go 与 C ABI 之间的边界。
【文章要点】
cmd/go 将根据包内 C 源码、Binding 指令和 CGO_CFLAGS 等条件,自动选择无需 C 工具链的构建模式。cmd/cgo 将增加 -gen-binding、-dynlibdir 等参数,并引入 //cgo:binding、//cgo:dynamic_library、//cgo:variadic 和 //cgo:funcptr 等指令。runtime/cgo 也将改用 Go 和汇编实现,并提供统一的动态库加载 API。CGO_ENABLED=auto 有望成为交叉编译时的新默认行为,使绑定模式下的 cgo 不再依赖 C 交叉编译器。
9 月 10 日,Matloob 在 Go 官方仓库提交了提案:
proposal: cmd/cgo: cgo without a C toolchain(#81450)。
我在 9 月 14 日曾专门写过一篇文章《Go 核心团队放大招:cgo 不用 C 编译器也能跑,AI/GPU 库调用将迎来大简化》,详细介绍了提案的背景、核心设计和潜在影响。
这里简单回顾一下核心思想。
传统 cgo 有一个看起来不太合理的地方:即使 Go 程序调用的只是一个已经编译好的 C 动态库(.so),构建时依然需要安装 C 编译器。
原因在于,cgo 不仅要理解 C 头文件,还会生成一部分 C 胶水代码,这些代码仍然需要 C 编译器参与编译。
Matloob 的思路是将这两个环节拆开:
这样,C 工具链就从终端用户的构建依赖,变成了库开发者在必要时才需要使用的工具。
而过去近两个月,这项工作明显加速了。
Matloob 连续提交了多个 CL,涉及 Binding 生成、C 可变参数函数支持、runtime/cgo 改造等内容。
11 月 4 日,Cherry Mui 在原始 Issue 中发布了一份精简版设计,并明确表示:
Here is a compact version of the proposal with the specific changes, for proposal review purposes.
这句话值得关注。
这不再只是讨论一种可能的技术方向,而是把具体需要修改哪些组件、增加哪些指令、采用什么默认行为,集中整理成了一份供 Proposal Review 使用的设计。
下面重点看看这次更新。
Cherry Mui 首先明确了 cmd/go 的改动。
在满足以下条件时,Go 命令将选择新的「cgo without C toolchain」模式:
.c、.S 等;import "C" 和 //cgo:binding 指令的 Go 文件,或者存在 //export 指令;CGO_CFLAGS。一旦满足条件,cmd/go 就会通知 cgo 使用新的方式生成调用包装代码,整个构建过程不再调用 C 工具链。
这里有两个值得注意的细节。
第一,新旧两种 cgo 模式将并存。
如果一个包包含真正需要编译的 C 源代码,它仍然需要传统 cgo 和 C 编译器。
因此,这项提案并不是要废弃传统 cgo,而是增加一种适用于预编译 C 库的构建路径。
第二,模式选择发生在包级别。
一个 Go 项目可以同时包含使用新 Binding 模式和传统 cgo 的包。不过,只要整个依赖链中仍有包需要传统 C 编译,最终构建依然可能需要 C 工具链。
这是一种渐进式迁移方案,而不是一次性切换整个 Go 项目的构建机制。
这次更新最值得开发者关注的部分,是 cmd/cgo 的具体改造。
Cherry Mui 明确提出,cmd/cgo 将增加两个参数:
go tool cgo -gen-binding
go tool cgo -dynlibdir <dir>
其中:
-gen-binding:处理当前包并生成 Binding 文件。这一步仍然可能调用 C 工具链。-dynlibdir:指定生成 Binding 时搜索动态库的目录。更重要的是,Binding 文件支持的能力被进一步细化。
//cgo:binding:绑定 C 类型、常量、变量和函数这是整个机制的核心指令。
例如,绑定一个 C 类型:
//cgo:binding C.point
type Point struct {
    X, Y float32
}
绑定 C 常量:
//cgo:binding C.SOME_CONSTANT
const SomeConstant = 10
绑定 C 全局变量:
//cgo:binding C.global ["libfoo.so"]
var Global Point
绑定 C 函数:
//cgo:binding C.compute ["libfoo.so"]
func Compute(p Point) float32
这里有一个值得注意的设计:函数和全局变量的 Binding 可以关联具体的动态库名称。
另外,Cherry Mui 还提到,对于 struct 类型,未来可能要求嵌入 structs.HostLayout,以明确 Go 结构体需要遵循宿主平台的内存布局规则。
这背后解决的是 Go struct 与 C struct 内存布局兼容的问题。
//cgo:dynamic_library:动态库成为一等对象这是此次更新中另一个很有意思的设计。
//cgo:dynamic_library libVar "libfoo.so"
var Lib LibType
它允许开发者将一个 Go 变量与动态加载的 C 库关联起来。
这里的 LibType 需要嵌入后面将介绍的 runtime/cgo.Library。
这样,开发者就可以围绕动态库构建类型安全的 Go API,而不必自行维护大量 dlopen、dlsym 和函数指针调用代码。
//cgo:variadic:支持 C 可变参数函数C 语言中有大量可变参数函数,例如:
int printf(const char *format, ...);
这类函数的调用约定与普通 C 函数有所不同,尤其涉及不同平台的 C ABI 规则。
此次设计增加了:
//cgo:binding C.printf ["libc.so"]
//cgo:variadic 1
func Printf(format *byte, args ...uintptr) int
这里的 1 表示固定参数的数量。
需要注意,示例中的 Go 声明是概念性展示。按照提案设计,Go 声明本身并不是一个 Go 可变参数函数,后续参数由新的 cgo 机制按照目标平台的 C 可变参数 ABI 传递。
//cgo:funcptr:支持 C 函数指针调用C API 中经常通过函数指针实现回调机制。
此次设计增加了:
//cgo:funcptr
func (fp FPType) Call(...) ...
它允许为绑定的 C 函数指针类型生成一个 Call 方法,执行间接调用。
其中,FPType 的底层类型需要是 uintptr。
这意味着,新机制不仅考虑普通 C 函数调用,也开始覆盖 C API 中比较复杂的函数指针场景。
总体来看,Binding 体系已经从最初的类型和函数声明映射,逐渐扩展为一套更完整的 C API 描述机制。
如果只改造 cmd/cgo,实际上还不足以彻底摆脱 C 工具链。
原因很简单:Go 标准库中的 runtime/cgo 自己也包含 C 源代码。
因此,即使业务代码不再需要 C 编译器,runtime/cgo 仍然可能成为整个构建过程中的依赖。
Cherry Mui 的最新设计明确提出:
runtime/cgo 将改用 Go 和汇编实现,不再依赖 C 源代码。
与此同时,还将引入一个新的 API:
// A Library represents a dynamically loaded C library.
type Library struct {
    // ...
}

// Open opens the shared library.
func (*Library) Open(path string) error

// Close unloads the library.
func (*Library) Close() error

// IsLoaded reports whether the library is currently open.
func (*Library) IsLoaded() bool
这组 API 为动态库的加载、卸载和状态查询提供了统一入口。
前面提到的 //cgo:dynamic_library,正是建立在这个 API 之上的。
值得注意的是,Cherry Mui 特别说明,这里的 runtime/cgo.Library 目前主要是一个原型接口,目的是先明确 API 的形态,具体方法和签名仍可能调整。
从架构角度看,这一步很关键。
它意味着 Go 团队不只是想让 cgo 生成的胶水代码摆脱 C 编译器,还准备把 cgo 运行时自身的 C 依赖也逐步移除。
这可能是此次更新中,对普通 Go 开发者影响最直接的变化。
Cherry Mui 提出,未来 CGO_ENABLED 将允许一个新的取值:
CGO_ENABLED=auto
尤其值得关注的是交叉编译场景。
按照目前的设计方向,在交叉编译时,如果没有显式设置 CGO_ENABLED,默认的 auto 模式将启用无需 C 工具链的 Binding 模式,但不会自动启用传统 cgo 模式。
举个例子:
GOOS=linux GOARCH=arm64 go build
假设项目使用的是符合条件的 Binding 模式,那么未来就有机会直接完成交叉编译,而不需要额外配置 ARM64 交叉 C 编译器、sysroot 和对应的头文件。
这对于 Go 开发者来说,无疑是一个非常有吸引力的变化。
不过,这里有一个重要边界:
它并不意味着 Go 可以自动把 x86 平台的 C 库变成 ARM64 平台的 C 库。
目标平台对应的预编译 C 库仍然必须事先准备好。新机制解决的是 Go 与 C ABI 之间的胶水代码生成问题,而不是 C 库本身的跨架构编译问题。
另外,Cherry Mui 对非交叉编译场景的默认行为仍然保留了讨论空间:究竟是默认只使用新模式,还是通过检查 CC 来决定是否允许使用传统 C 工具链,目前尚未最终确定。
尽管这份设计已经相当具体,但 Cherry Mui 也在评论中明确标出了几个尚待讨论的问题。
我认为其中三个尤其值得关注。
1. C TSAN 如何处理?
新的 runtime/cgo 不再包含 C 代码,这意味着传统 C ThreadSanitizer 对运行时和生成包装代码的插桩方式可能受到影响。
Cherry Mui 提出,可能需要在 TSAN 场景下回退到传统 cgo,也可能增加新的构建选项或 build tag。
这里需要特别区分:讨论的是 C TSAN,而不是 Go 自带的 race detector。
2. 如何避免 Binding 与真实 C API 不一致?
Binding 文件可以手写,也可以生成,还可以被提交到代码仓库长期维护。
但如果底层 C 库升级,函数签名、结构体布局发生变化,而 Binding 文件没有同步更新,就可能产生严重问题。
一个候选方案是:当开发者本地存在 C 工具链时,通过 go test 重新生成 Binding,并检查其与仓库中已有文件是否一致。
这实际上是在为 Binding 引入类似代码生成文件的校验机制。
3. 动态库依赖如何保证正确链接?
对于函数和全局变量的 Binding,是否必须显式指定动态库名称,目前仍在讨论。
原因在于,如果遗漏了库名称,程序可能编译成功,却没有在最终二进制中生成正确的动态库依赖信息,例如 ELF 的 DT_NEEDED 或 Mach-O 的 LC_LOAD_DYLIB。
这会让程序在运行阶段才暴露问题。
因此,Cherry Mui 倾向于要求显式声明库依赖,系统库或静态库等特殊场景则可以使用 _ 作为显式省略标记。
这些细节说明,Go 团队已经开始处理真正落地时不可回避的工程问题。
回头看 Matloob 在 9 月提出的方案,再看 Cherry Mui 11 月 4 日的更新,可以发现这项工作的重心正在发生变化。
最初讨论的核心问题是:能不能让 cgo 在不安装 C 工具链的情况下调用预编译 C 库?
如今,Go 团队已经开始明确:
cmd/go 如何选择新旧构建模式;cmd/cgo 如何描述和生成 C API Binding;runtime/cgo 如何摆脱 C 源码;这已经不只是一个简单的构建优化,而是 Go 工具链对 C ABI 支持方式的一次系统性扩展。
当然,需要强调的是,截至 2026 年 11 月 5 日,这项工作仍处于 Proposal Review 阶段。Cherry Mui 的精简设计并不意味着提案已经正式获批,也不意味着相关功能已经进入某个 Go 正式版本。
但从 Matloob 持续提交的 CL,以及 Cherry Mui 开始系统整理设计细节来看,这项工作的工程推进已经相当深入。
我尤其期待它对 Go 跨平台生态带来的改变。
过去,Go 开发者在调用 Rust、C/C++、CUDA 等原生库时,经常需要在构建环境、交叉编译和部署复杂度之间做取舍。
如果这项提案最终落地,至少对于那些只需要调用预编译原生库的 Go 项目来说,C 工具链将不再是终端用户必须承担的构建负担。
cgo 不会消失,但它可能不再意味着你必须安装一个 C 编译器。
这或许才是这项提案最值得期待的地方。
参考资料:
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
2026-11-09 07:00:00
本文永久链接 – https://tonybai.com/2026/11/09/cpp26-historic-dis-rejection-herb-sutter
大家好,我是Tony Bai。
【导读】
C++26 遭遇了一次载入语言标准化历史的挫折。
2026 年 10 月 23 日,经过为期 12 周的国际投票,C++26 的最终国际标准草案(DIS)未能获得通过。据参与标准化工作的委员披露,这是 C++ 历史上首次出现这样的情况。
更戏剧性的是,这场风波的核心,竟然是 C++26 新增的一项语言特性——Contracts(契约)。
投票失败后,C++ 标准委员会的重要人物 Herb Sutter 发布了一篇文章,标题相当耐人寻味:
When a language’s creator and its owners strongly disagree: C++26 post-DIS, historical experience, and paths forward
翻译过来就是:
当一门编程语言的创造者与它的所有者发生严重分歧时:C++26 投票失败后的历史经验与未来出路。
这里的语言创造者,指的是 Bjarne Stroustrup,也就是 C++ 之父。
这已经不再是简单的技术争论,而是涉及一门成熟编程语言究竟应该由谁来决定其未来的问题。
【文章要点】
先说一个背景。
C++ 标准并不是由某个公司或者某个人直接拍板发布的。
它背后有一套复杂的国际标准化流程。
负责 C++ 语言标准制定的工作组是 ISO/IEC JTC1/SC22/WG21,通常简称 WG21。
我们熟悉的 C++11、C++14、C++17、C++20、C++23,都是通过这套机制逐步形成并最终发布的。
一份新标准在正式发布之前,需要经过多个阶段。其中,DIS(Draft International Standard)是非常靠后的一个阶段。
简单来说,DIS 就是提交给 ISO 成员国进行最终审查和投票的国际标准草案。
按照 ISO 的投票规则,DIS 需要满足两个条件:
2026 年 10 月 23 日,C++26 的 DIS 投票结束。
结果:Disapproved!
这是一次极为罕见的结果。
据 C++ 标准委员会成员 Andreas Fertig 的调查,在他能够查到的 ISO 编程语言标准记录中,除了 2006 年未获通过的 C++/CLI 标准草案之外,很难找到类似先例。而 C++/CLI 项目最终被终止。
这意味着,C++26 遇到的并不是普通的标准化流程延迟,而是一次真正的国际标准投票失败。
需要强调的是,ISO 并未公开各国的具体投票明细。网上流传的具体票数属于参与者或其他渠道披露的信息,不能当作 ISO 官方公布的完整统计。
那么,究竟是什么让 C++26 在最后关头翻了车?
答案是:Contracts。
Contracts,中文通常翻译为契约。
它的核心思想并不复杂:让程序员能够在函数接口层面表达前置条件、后置条件以及断言。
例如:
int divide(int a, int b)
    pre(b != 0)
{
    return a / b;
}
这里的 pre(b != 0) 表达了一个前置条件:调用者必须保证除数不为零。
与传统的 assert 相比,Contracts 希望提供更加系统化、标准化的机制,让函数接口中的约束成为语言的一部分。
这项特性并不是 C++26 临时塞进去的新玩具。
事实上,C++ 社区围绕 Contracts 已经讨论、设计和争论了很多年。
最终进入 C++26 的设计,来自提案 P2900 及其后续修订。
支持者认为,Contracts 可以帮助开发者表达程序的正确性约束,为调试、运行时检查和代码质量提升提供统一机制。
但反对者认为,当前设计还存在一些根本性问题。
而站在反对阵营前列的,恰恰是 C++ 之父 Bjarne Stroustrup。
2026 年 8 月,Bjarne Stroustrup 等人提交了提案:
P4334R0:P2900 Contracts’ fundamental flaws
这份文档直接指出了当前 Contracts 设计存在的根本缺陷。
争议主要集中在几个方面:
1. 设计是否真正成熟?
反对者认为,Contracts 是一项会深刻影响语言语义的基础设施,不应该在缺乏充分实现和大规模实践验证的情况下匆忙进入标准。
2. 不同检查模式带来的语义问题。
Contracts 允许不同的检查模式,例如 ignore、observe 和 enforce。
这些模式在不同编译配置下可能表现不同。
反对者担心,这会给程序行为、跨翻译单元的一致性以及程序员对契约语义的理解带来复杂性。
3. 关键能力还没有得到充分解决。
包括契约检查的保证机制、虚函数相关语义,以及一些关键设计细节。
反对者认为,不能把尚未解决的问题简单推迟到未来版本。
这背后其实存在两种不同的工程哲学:
一方希望先将一个经过多年讨论的实用方案纳入标准,再通过后续迭代完善。
另一方则认为,Contracts 这样的基础语言设施一旦进入标准,就可能影响未来几十年的代码,必须在发布前充分验证。
这不是简单的喜欢与不喜欢,而是对语言长期演进风险的不同判断。
这里才是整个事件最值得关注的地方。
2026 年 3 月,WG21 在英国 Croydon 举行的会议上完成了 C++26 的技术工作。
Herb Sutter 在当时的会议报告中披露,委员会全体会议对是否将 Contracts 保留在 C++26 中进行了投票:
最终,委员会决定保留 Contracts,并将 C++26 草案提交给后续国际投票。
从委员会内部的投票结果看,支持者占据明显优势。
然而,到了 ISO 国家成员机构投票阶段,结果却完全不同。
这揭示了一个非常重要的制度事实:
WG21 内部的技术共识,并不等于 ISO 国际标准层面的最终认可。
WG21 负责制定和维护 C++ 标准草案,但最终国际标准的批准权属于 ISO 的标准化程序。
两者并不是同一回事。
而这一次,反对 Contracts 的声音最终在国际投票阶段获得了足以阻止标准通过的支持。
这也让原本已经接近终点的 C++26 陷入僵局。
更重要的是,这场争论并非只有技术层面的分歧。
支持者认为,委员会已经进行了多年讨论、反复投票,并且形成了明确的多数意见。既然按照既定规则完成了决策,就应该尊重结果。
反对者则认为,对于一项尚未成熟的基础语言设施,即使委员会内部形成了多数意见,也不意味着所有重大技术问题都已经得到解决。
双方都在强调程序和工程责任,只是对两者的优先级理解不同。
投票失败后,Herb Sutter 发布了这篇非常值得阅读的文章:
P4454R0:When a language’s creator and its owners strongly disagree: C++26 post-DIS, historical experience, and paths forward
这篇文章最值得关注的,不只是对争议的回顾,而是它试图回答一个更现实的问题:
现在,C++26 到底应该怎么办?
Herb Sutter 将问题放到了更大的历史背景中讨论:当语言的创造者与负责维护标准的组织出现严重分歧时,应该如何处理?
这里需要区分两个概念。
Bjarne Stroustrup 是 C++ 的创造者,但 C++ 并不属于他个人。
WG21 负责标准的技术演进,ISO 负责国际标准的批准。编译器厂商、工具链开发者和全球开发者则共同构成了 C++ 实际生态。
因此,创造者的意见具有极高的技术和历史分量,却不等于拥有最终决定权。
而标准组织拥有制定标准的制度权力,也不意味着它可以忽视语言设计的长期一致性。
Herb Sutter 的文章围绕这个矛盾,讨论了 C++26 投票失败之后的多种可能路径。
结合文章及其讨论,可以将这些路径归纳为六种:
路径 A:放弃单独发布 C++26,将已完成的工作合并到 C++29。
这意味着 C++26 不再作为一个独立的正式标准发布。
相关特性需要重新进入下一轮标准化流程。
优点是可以避免在争议没有解决的情况下仓促发布。
缺点也很明显:大量已经完成的标准化工作可能被推迟,整个 C++ 演进节奏受到影响。
路径 B:从 C++26 中移除 Contracts,再重新提交投票。
这是一条相对直接的路线。
既然 Contracts 是当前争议的核心,那么将其移除,让其他已经完成的特性继续进入标准化流程。
但问题在于,Contracts 已经与部分标准库强化设计产生了关联。移除它并不是简单删除几段标准文本,还可能需要调整相关设计。
同时,这也意味着支持者需要接受此前已经通过的委员会决策被重新推翻。
路径 C:保留现有设计,争取重新投票。
如果委员会认为原有技术决策仍然成立,可以尝试重新提交修订后的草案,争取获得国际成员机构认可。
但如果没有解决反对者的核心疑虑,仅仅重新投票,很可能只是重复之前的结果。
路径 D:针对 Contracts 的部分争议进行有限修改,再重新投票。
例如,针对虚函数等有争议的语义进行调整。
这样可以尝试在保留 Contracts 主体设计的同时,回应部分反对意见。
但修改范围如何确定、是否足以获得新的共识,都存在不确定性。
路径 E:探索通过不同国家的国家标准体系发布相关内容。
如果国际标准化路径陷入僵局,可以考虑其他国家标准化机制。
但这会带来标准协调和国际认可方面的问题。
路径 F:进一步调整标准化组织路径。
包括讨论是否继续沿用现有 ISO 路线,或者探索 ANSI/INCITS 等其他标准化渠道。
这无疑是最具争议、也最具制度影响的一条路线。
需要说明的是,这些路径是对文章讨论及相关社区讨论的归纳,并不意味着它们都已经成为 WG21 正式通过的决议。
六条路径背后,其实只有一个核心问题:
C++26 应该优先维护已经形成的委员会决策,还是应该优先回应国际投票暴露出来的技术分歧?
这才是这场风波真正难以解决的地方。
Hacker News 上,这篇文章也引发了大量讨论。
其中一个非常有意思的话题是:
一门编程语言究竟应该由谁来决定它的未来?
有人认为,语言设计需要一个有明确权威的领导者。
他们举出了 Python 早期 Guido van Rossum 的 BDFL(终身仁慈独裁者)模式,以及 Linux 内核由 Linus Torvalds 主导、逐步形成维护者体系的例子。
这种模式的优势在于,决策链条相对清晰,语言可以保持比较一致的设计方向。
但它也有明显局限:个人的精力、判断和生命周期都有限,如何完成权力交接,也是长期治理必须面对的问题。
另一派则认为,像 C++ 这样拥有庞大生态、众多厂商和数十年历史的语言,根本不可能由某个人决定一切。
它需要委员会,需要公开讨论,需要让不同国家、厂商和技术专家共同参与。
但委员会模式同样存在成本。
决策过程漫长,技术共识难以形成,而且当多数意见与少数重要技术参与者发生冲突时,如何平衡效率与审慎,是一个长期难题。
这次 C++26 的争议,恰好将这些问题集中暴露了出来。
还有一个值得注意的观点:
标准不等于语言本身。
Hacker News 上有参与者指出,ISO 标准定义的是标准化的 C++,而实际开发者使用的 C++,还受到 GCC、Clang、MSVC 等编译器实现以及各自生态的影响。
这提醒我们,标准组织虽然对语言演进具有重大影响,却并不是整个 C++ 生态的唯一参与者。
但反过来,如果缺少统一标准,编译器和平台之间也可能出现越来越严重的分歧。
所以,无论采用个人主导还是委员会治理,都没有绝对完美的答案。
截至 2026 年 11 月 9 日,C++26 的 DIS 投票已经失败,但这并不意味着 C++26 就此终结,更不意味着 C++ 语言本身出现了危机。
ISO 标准化流程仍然提供了重新提交草案、返回委员会草案阶段、发布技术规范以及终止项目等不同处理方式。
下一次 WG21 全体会议计划于 2026 年 11 月 16 日至 21 日在巴西 Búzios 举行。
如何处理 C++26 的国际投票意见,以及如何重新建立委员会内部的共识,将成为会议的重要议题。
对开发者来说,还有一个值得关注的细节:
这次投票针对的是整个 C++26 草案,而不是只针对 Contracts。
因此,Reflection、std::execution、标准库强化等已经进入 C++26 的其他特性,也会受到这次投票失败的影响。
这才是这件事对 C++ 开发生态真正的影响。
我觉得,这次事件最值得思考的并不是 Contracts 到底应该保留还是删除。
而是:
一门已经发展了 40 多年、拥有庞大产业生态的编程语言,如何在保持技术演进速度的同时,确保每一次重大设计决策都经得起长期实践的检验?
C++ 的复杂性,来自它对历史兼容性的承诺,也来自它需要同时满足不同领域、不同厂商和不同世代开发者的需求。
它不可能像一门刚刚诞生的新语言那样轻装上阵。
但也正因为如此,C++ 的每一次标准演进,都需要更高程度的审慎和共识。
这次 C++26 的投票失败,也许会让 C++ 的下一个标准晚一些到来。
但对于一门可能还要服务未来几十年的编程语言来说,有时候,慢下来把问题解决清楚,比按时发布一个存在重大争议的标准更加重要。
参考资料:
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
「Go & AI 精进营」已全面升级为「Go, Rust & AI 精进营」知识星球,快来加入星球,开启你的技术跃迁之旅吧!
我们致力于打造一个高品质的 现代系统级开发(Go / Rust) 与 前沿 Agentic AI 工程实践 平台。在这里,你将获得:
衷心希望「Go, Rust & AI 精进营」能成为你拓宽技术边界、持续精进与交流的温暖港湾。让我们在此相聚,享受代码与工程之美以及技术精进的快乐!欢迎你的加入!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。


