2026-09-28 12:29:56
 我是 08 年毕业的,到现在,已经过去了超过 18 年。但是,我开始学软件的时间,要早得多,并且是从 VB 开始的,正儿八经接触的第一门编程语言是 C,毕业使用的是 Groovy on Grails 做的网站(可远不如现在的毕业生们使用的高大上技术了),在这篇文字里面有所介绍。如今在 AI 火遍全世界的年代,我会想起当时我是怎样学写软件的,更感慨的是,对于选择软件工程师作为职业的我来说,真的幸运地赶上了好时代。这个时代的激动人心,是前无古人的。
跳出琐碎的具体事件,如果我们站到非常高的视角,想想整个世界软件工程的演进,可以分成这么几个阶段:
首先是五六十年代的手工业时代,硬件是催化剂,随着硬件性能提升,极易崩溃的软件称为了瓶颈,这才有了把工程化从传统产业搬到软件上的第一个阶段。在这个阶段末,北约会议中提出了 “软件工程” 的概念。
接着是结构化编程时代,相当于是七八十年代,标志性的事件是 C 语言和 Unix OS 的诞生,Dijkstra(就是那个最短路径算法的作者)提出了 goto 语句的害处。从此大家都认可软件应该自顶向下、模块化编写。这段时间很多的观点也是我大学里面逐步接触到的。
接着九十年代到 2010 年代中期,互联网行业爆发,软件工程飞速发展,跨平台的 Java 语言诞生,敏捷的概念开始兴起。这段时间最浓墨重彩的两个词是 OO(面向对象)和 Web,我觉得从我的技术背景和积累来看,主要的知识内容就是那个年代产生的。
第四个阶段就是 2010 代中到 2020 年代初,大致可以归纳为云计算和云原生时代。这也算是记忆犹新,不过我自身的这方面的技术更新并不快。其中标志性的事件,我认为就是 Docker 和 Kubernetes 的开源。职业路线上,慢慢专注于 platform 和 infra 以后,我已经较少开发纯 web 的项目或者软件了,技术方面涉及云原生的可以说越来越频繁。
第五个阶段,处于刚兴起的一个大阶段,就是AI 驱动的时代,这可以说是说算是从 2022 年的 ChatGPT 爆发开始算起,依然非常早期。华尔街和资本把它炒的火热的程度,兴许可以说仅次于当年的互联网泡沫。自然语言开始成为编程语言,开发效率爆发,编程语言的 “语言” 特性本身,逐渐变得廉价,代码生成成本越来越低。
如果把这几个阶段的技术摆出来,再从一个随着时间演进的高屋建瓴的角度看,还能发现一些变化的规律:
第一个是抽象层级越来越高。
比如一开始是硬件机器语言、汇编语言;然后结构化编程阶段的 C 和 Unix,屏蔽了许多硬件指令的复杂性;接着就是互联网阶段的 JVM,做到一次编写,到处运行这样跨平台;而云平台的 Kubenetes+Docker 则是让运行环境和资源一并打包;到了 AI 则是让人类语言翻译成传统编程语言这一步都省了,基本上的最高的抽象层级了,也是最接近人类思维模式的形式。
第二个是软件复杂程度的爆炸。
从最早的直接接触硬件的操作,到逐步引入高级编程语言、面向对象等等对抗软件复杂度,再到治理方面使用 Kubernetes 等编排技术整合各种各样的微服务,最后是 AI 时代使用大模型来接管人类大脑对于软件整体体系的认知。
在 AI 的这个阶段,软件工程师的价值在哪里,这个行业的未来会怎样,和很多这行的人一样,我也在反复思考这个问题,比如这篇。
关于这个问题,如果尝试站得高一点,拨开那些具体技术和实践的迷雾,只是从软件工程和软件工程师的本质去思考问题,那么软件工程这一个行业,很很多工程行业一样,其实并没有什么特别的——技能会被替代,行业反而会持续进步。每一类具备普遍性的问题,每一种能够得到大规模使用的技术,都会关联到一种职业。所以,如果思考软件工程师这个职业是否会被淘汰掉,不如思考软件工程这个技术领域是否会被淘汰掉?进而再思考,软件领域所解决的问题是否会被淘汰掉?
显然,是否定的。
我来尝试解释一下。来想想看,软件工程诞生的动机是什么?一个词来概括,就是复杂性。人类的需求是社会进步的动力,这是无止境的。而正是因为需求不断进展,软件不可避免地变得越来越复杂,人类就迫切需要一个可以重复和实践的办法,来保证软件交付的时间和质量,这才有了软件工程。
再来思考未来,未来的软件是怎样的暂且不论,可以确定的是,未来需要软件解决的问题依然在变得更为复杂,那么未来软件的本身也自然需要更为复杂,于是,为了保质保量交付,为了社会化大规模实践和推广最佳的方法,软件工程就需要持续存在,并且也将更为复杂,专业门槛只会更高。这就是最本质的软件工程和软件工程师不被淘汰的逻辑。只不过,那时的技术未必是现在的技术,那时对于工程师的要求未必是现在对于工程师的要求。这一点结论,其实和 AI 本身没有关系,也可以是其他技术手段,只不过 AI 恰好成为了这个时代扣动扳机的那个角色。
再把视角缩回到 AI。我们时常听到 AI 替代论和 AI 自我进化论。在某些领域,AI 确实会不断替代当前软件工程师在软件工程中所扮演的许多角色,很多技术问题也能够通过 AI 完成解决,而 “人” 只需要很低程度的参与;不过,也有很多领域,广泛存在确定的逻辑壁垒,让 AI 自我迭代和强化变得非常困难。具体说,AI 自己来生成代码,并且使用它来进行训练,不断强化,它就会缺乏人类真实的应用场景,本质上也无法产生针对真实的改进和创新。这种模式,一定程度上可以视作封闭系统的自我更新,极易放大微小的误差,最终结果天差地别,形成不可思议的谬误。
把时间维度放到未来几年到十几年来看,我觉得 AI 还是更适合作为一个辅助者的身份,软件工程师来做抽象,做统筹,做高屋建瓴的规划性工作,让 AI 成为一个辅助者、好帮手,帮助完善内容,作为智囊团提供建议和实施者搞定经过人类审核分派的具体任务。社会依然需要软件工程师这样的角色,甚至需要更多,只不过他们的技能树可能会发生大幅变化。软件工程师对于问题的简化能力、抽象能力、规划能力,将得到前所未有的重视。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》
2026-09-14 13:33:00
 投资美股已经有些年了,之前也基于自己的体会和理解陆陆续续写了一些文章,每个持续投资的人都会有自己的理念和方法论,我也不例外。今天想来谈论一个有意思的话题,为什么我美股投资,对于我主要的资金(401k 以外的),多年来都不买大盘(标普 500),只投资个股,并且是坚持持续地投资个股。
巴菲特曾经说过,对于大多数人来说,标普 500 指数,是一个最佳的选择。一些在争论是不是应该投资大盘的时候,经常听到这样的回答——“费那么大劲,还不如直接买标普 500 呢”。这其实是一个普遍的问题,但是不见得参与讨论的人都说得清楚。如果某段时间的投资收益高于标普,尚且会被如此评论,如果这段时间的收益低于标普,那就更得被奚落了。但是我思考了几次这个问题,我觉得对于个股的投资,于我来说,有着诸多清晰且不可替代的好处。
首先,要理解的一点是,为什么投资标普 500 那么值得推崇?
投资大盘的逻辑其实很简单,就是相信未来,相信这最具代表性的五百家企业,同时,在相信的同时也接受平庸。
我非常同意这就是大多数人的最佳选择。因为买了标普,就放弃了超越市场获取α收益的可能性,获得的是根上市场平均收益β的确定性。对于没有时间去研究板块和公司的人来说,这是最省心、也是在得到市场收益的前提下,最不容易亏钱的途径。
具体来说,买标普 500 就意味着:
听起来很美好,对以上几条我也没有异议。但是,我一直都有一些对于闭眼买大盘的疑虑,并且这些疑虑逐年加深。
首先,买大盘就放弃了个体投资者的认知优势。
是的,通常我们说群体优势,但并非任何事情都是群体比个体更有优势的,特定领域的认知就是一个例子。我认为,很多人都是有自己独特眼光的。比方说,我虽然看不懂能源公司,我看不懂医疗赛道,我却研究过某些科技公司,甚至某几家科技公司自己就曾经工作过,有过比一般人更多一些的认识。我有自己熟悉的领域,我认为,对于某些商业模式的理解,相较于那些只看财报和数据的分析师,我更相信我的判断。我也有医生朋友,他对于医疗领域就有很多研究,这是一样的道理。
需要说明的是,每个人的认知是有局限性的,很难能够在广泛程度上打败市场,但在特定的少数几家公司和几个生意上,却是有可能击败大众共识的。
为什么要在谈论投资的时候首先谈论认知?因为投资回报,本质上就是认知的变现。
其次,买自己理解的公司,心里更踏实,睡觉更安心。
踏实和安心,说的其实就两件事情:
难道不是标普大盘更踏实、更安心吗?我并不这么认为,市场的平均并不能取代对于公司和商业模式的理解。一篮子的公司,大部分我都是不了解的,却让我把大量的资金押注在它们上面,逻辑上的矛盾始终都在,我也不太能长期接受。
从我的角度来说,越是觉得自己理解的公司,我就越愿意用一个更大的仓位去长期持有,把资金集中到具备最优秀商业模式和最宽阔护城河的公司投资上面。
能理解一家公司,需要考察方方面面,但是要排除一家公司,只要挑一个刺就可以了。特别是商业模式,能找到优秀的并且自己能理解和认可的,实在是凤毛麟角。对于那些有着明显缺陷的生意,我就是压根不想参与。
再次,市场有时会疯狂,而市场的疯狂会被写进大盘指数里。
标普 500 是市值加权指数。如果一家公司因为短期狂热而被炒高,指数基金会激进地买入,而反之则会减少持有比例,甚至,这和 “卖在人声鼎沸时,买在无人问津处” 这样的逻辑恰恰是相反的。
我认为标普 500 就代表了一种大众群体的共识,而这种共识就一定会包含群体的狂热。如果想远离它,就要远离标普指数。勒庞写过一本讲大众心理学和社会学的书,叫做《乌合之众》,里面有一句话说得好:“群体只会干两种事——锦上添花或落井下石”。
最后,个股投资可以让我接近投资的本质:找到一个好生意,在一个好价格买入它,做时间的朋友,去兑现复利的价值。
我认为一家公司的基本面当中,最重要的就是生意模式,它也是 “好生意” 最重要的部分。坚持投资个股,就迫使我去研究一家公司的生意,这件其实是一件很有意思的事情。买标普 500,我十之八九不会有这个动力去做这件事情。
投资当中,带来回报有很多种方式,但是最让我开心的一种方式,是在和市场有分歧的时候买入,静待春暖花开,市场逐渐认可自己的观点。这件事并不容易,但是它却能带来无比的快乐。
求学,是十几年的事;工作,是半辈子的事;投资,是一生的事。
而你的投资回报,是你认知的变现。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》
2026-08-07 06:10:11
工作上的原因,最近学习了一下 Run:ai,也考察了一下它的替代技术。在这里记录一下。
 Nvidia 当年收购 Run:ai,还是很有前瞻性的。并且它并没有阻拦开源版本的继续演进,只不过,商业分支提供了更强大的能力。
Run:ai 是一个企业级的 AI 基础设施编排和管理平台,核心能力就是最大化 GPU 的资源利用和调度能力,在它的主页上,列出了四大特性:
抛开那些商业宣传和拥抱开源等等方面,我们只讨论技术层面,我觉得拥有核心竞争力的 feature 主要是:
Run:ai 的官方文档上这张组件图是最好的 overview 的材料:

从远处看,Run:ai 分成 control plane 和 cluster 这样两个部分,一般说来,一个 control plane,一个或多个 cluster。这让我想起了前段时间学习过的 Flyte 的架构,类似的部署方式。值得一提的是,出于安全等原因的考虑,没有从 control plane 主动去连接和发送请求到 cluster 的情况,只有从 cluster 发起去读取 control plane 的情况。
除了官方文档,DeepWiki 上面也有很有用的材料可以学习,比如下面这张组件图:

在 Control Plane,scheduling 等 metadata 是存放在 PostgreSQL 里面的;而每个 cluster 则是扩展 Kubernetes,数据存放在 Etcd。
部署方式上,其中的 Control Plane 可以部署在用户自己这里,甚至包括 docker registry(Air-Gapped 模式),也可以使用 Nvidia 提供的远程服务(SaaS 模式)。很多公司出于安全考虑都是使用本地部署的。
接着,从和 Kubernetes 结合的机制上去理解 Run:ai:
在运行的时候,我们能够从 job 资源的 labels 和 annotations 上面看到被 Run:ai 劫持后的标记。
Run:ai 是收费的,KAI Scheduler 是一定程度上 Run:ai 调度模块的平替,它是 Kubernetes 原生的调度器。功能实现的层面不太一样,总体来说 Run:ai 要更强大一些。
说说其中最核心的软隔离和硬隔离的问题。如果使用 KAI Scheduler,如果说用户提交一个 PyTorch 任务,上面申请了一定量的显存,但是如果 PyTorch 任务的实际代码中,用户申请更大的显存,KAI Scheduler 根本不会去阻止。这就会引发 Noisy Neighbor 的问题。这个问题不只是显存层面,在 GPU 层面也有,KAI Scheduler 的调度逻辑能把任务安排到相应的显卡上,但是没法强制设置某一张显卡部分使用时的百分比上限。
对此,如果要寻找解决方法:
总之,没有完美的办法,大概这也是 Nvidia 把 Run:ai 的商用 licence 卖那么贵的原因吧。
此外,除了上面这个软隔离和硬隔离的问题,还有一些其它的差异,比如:
在 KAI Scheduler 的 GitHub 页面上,有一个很有帮助的 presentation 列表和一个 key features 列表。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》
2026-06-01 12:03:31
这些笔记是在自己的 Mac Mini 上面折腾了一些记录,主要是安装一些重要的大模型工具,把这些工具连接起来,建立自己的私有本地知识库等等,以备查阅。后续不定时更新。
OrbStack 是专门为 MacOS 设计的快速、轻量级的虚拟化工具,可以作为本地 Docker、K8s 和 Linux VM 的超容易替代品。因为它丢掉了跨平台的包袱,直接在系统内核级别支持虚拟机指令,动态分配内存等等做法,让它变得超快。就以 Docker 为例,它可以把冷启动速度从几十秒优化到一两秒。
我是在 Apple M4 芯片的 Mac mini 上面折腾的,首先要保证我的应用全部都是 M4 芯片直接支持的,而不是通过 Rosetta 2 兼容性转换过来的。在检查 Homebrew 的时候,发现 brew 命令的路径在/usr/local/bin/brew,这就是说 brew 在 Intel CPU 的模拟路径上,因此重新安装了 Homebrew,修改 PATH 以后检测发现 brew 已经在 ARM 的原生路径上了:/opt/homebrew/bin/brew。
这再安装 OrbStack 就行了:
brew install --cask orbstack使用 orb 命令启动的时候,OrbStack 列出了三大核心功能:Docker、K8s 和 Linux VM,基本上足以完成我日常折腾的最核心需要了。
安装以后,docker 的命令就完全支持了,启动一下看看:
docker run -p 80:80 docker/getting-started我在公司里代码编辑器使用的是 Intellij 和 Windsurf,后者是真正的 AI 原生 IDE。不过现在打算安装 Cursor,作为 Windsurf 的竞品,它有更优秀的综合体验。
首先要安装 Conda,有很多其他的库管理系统,但因为 Conda 是一个更通用的环境管家,不仅限于 Python,包括 Python 库底层的 C++一并搞定。
Miniforge 把 Conda 工具包装了一下,并且针对 Mac 定制化了一下。Conda 的定制化有很多,Miniforge 是其中之一,开源免费,支持原生 ARM。
Ollama 是一个可以在本地电脑上运行 LLM 的工具。然后可以跑 Llama 模型了:
ollama run llama3.2用 Cursor 写一段小程序来调用它:
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.time.Duration;

public class LocalLLMClient {

    public static void main(String[] args) {
        String endpoint = "http://localhost:11434/api/generate";

        String jsonPayload = "{"
            + "\"model\": \"llama3.2\","
            + "\"prompt\": \"Who are you?\","
            + "\"stream\": false"
            + "}";

        HttpClient client = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(10))
                .build();

        HttpRequest request = HttpRequest.newBuilder()
                .uri(URI.create(endpoint))
                .header("Content-Type", "application/json")
                .POST(HttpRequest.BodyPublishers.ofString(jsonPayload))
                .build();

        try {
            HttpResponse<String> response = client.send(request, HttpResponse.BodyHandlers.ofString());

            System.out.println("HTTP status code: " + response.statusCode());
            System.out.println(response.body());

        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
运行它,可以得到:
HTTP status code: 200
{"model":"llama3.2","created_at":"2026-03-29T23:54:11.011864Z","response":"I'm an artificial intelligence model known as Llama. Llama stands for \"Large Language Model Meta AI.\"","done":true,"done_reason":"stop","context":[128006,9125,128007,271,38766,1303,33025,2696,25,6790,220,2366,18,271,128009,128006,882,128007,271,15546,527,499,30,128009,128006,78191,128007,271,40,2846,459,21075,11478,1646,3967,439,445,81101,13,445,81101,13656,369,330,35353,11688,5008,16197,15592,1210],"total_duration":868990167,"load_duration":99794167,"prompt_eval_count":29,"prompt_eval_duration":263381208,"eval_count":23,"eval_duration":497184294}
Ollama 这个工具是最核心的部分,其他很多工具都需要连接在 Ollama 上面跑的大模型来完成。
LM Studio 基本上就是本地的大模型图形化工具,和 Ollama 在功能上是有重叠的。一般说来,Ollama 可以用作后台程序运行和工程化调用,但是 LM Studio 适合选型和调试。
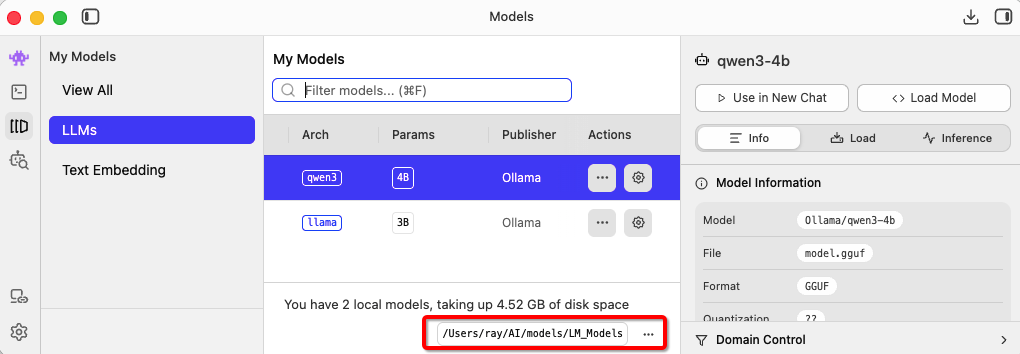
模型文件都比较大,已经使用 Ollama 下载了的,就不需要 LM Studio 再下载一遍了。模型都被下载到了~/.ollama/models/blobs/sha256-xxx,根据文件大小可以找到那个实际的模型文件。
然后创建 gguf 的软链接,比如:ln -s ~/.ollama/models/blobs/sha256-3e4cb14174460404e7a233e531675303b2fbf7749c02f91864fe311ab6344e4f ~/AI/models/LM_Models/Ollama/qwen3-4b/model.gguf,这样在加载以后,这个文件就能够被识别了:
我们可以配置 /Users/ray/Library/Application Support/Claude 来允许 Ollama 来访问 Claude 的 MCP 接口:
{
  "preferences": {
    "coworkWebSearchEnabled": true,
    "coworkScheduledTasksEnabled": false,
    "ccdScheduledTasksEnabled": false
  },
  "mcpServers": {
    "local_ollama": {
      "command": "/usr/local/bin/npx",
      "args": [
        "-y",
        "ollama-mcp-server",
        "http://localhost:11434"
      ]
    }
  }
}
再去问 Claude 的时候,它就能访问 Ollama 并得到安装的模型了:
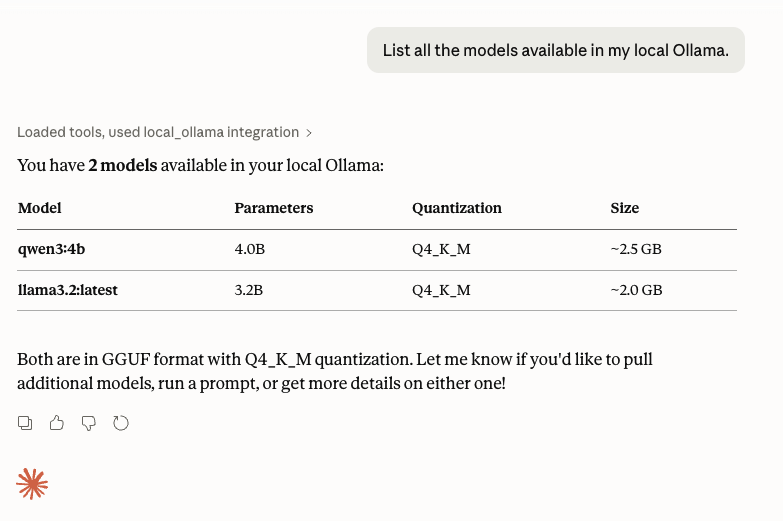
它的这个操作,其实是和本地运行 curl http://localhost:11434/api/tags 或者 ollama list 是一样的。
为了能更方便地使用,最好打开语音操作支持。在 Mac 的设置里面,找到 keyboard,语言列表里面需要把中文英文都勾上:
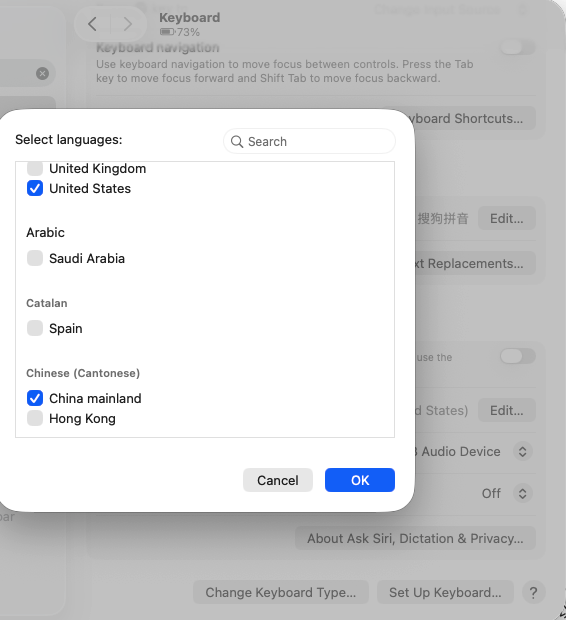
并且还可以设置为双击 Command 按键就可以调出语音输入。
在 general 的语言和地区设置里面,加上中文:
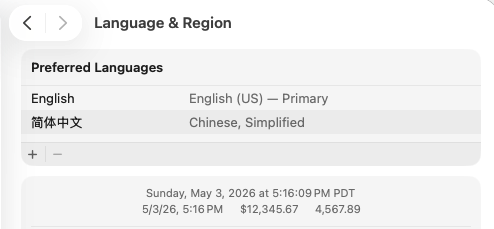
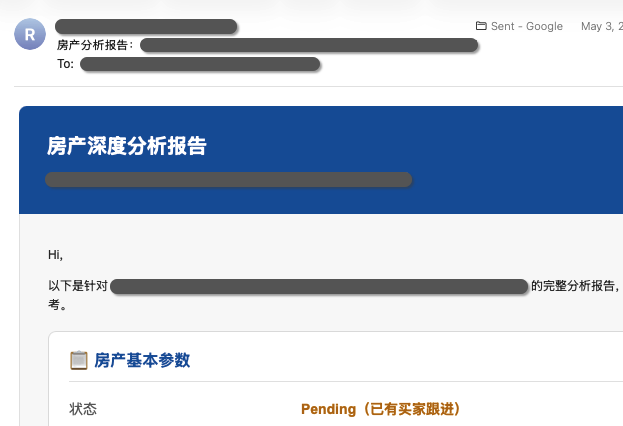
再配置好 Gmail 的 connector,就可以让 Claude 做一些更有意义的工作了。比如,我让它分析最近看的房子,生成一份详细的报告发到家人的邮箱里。
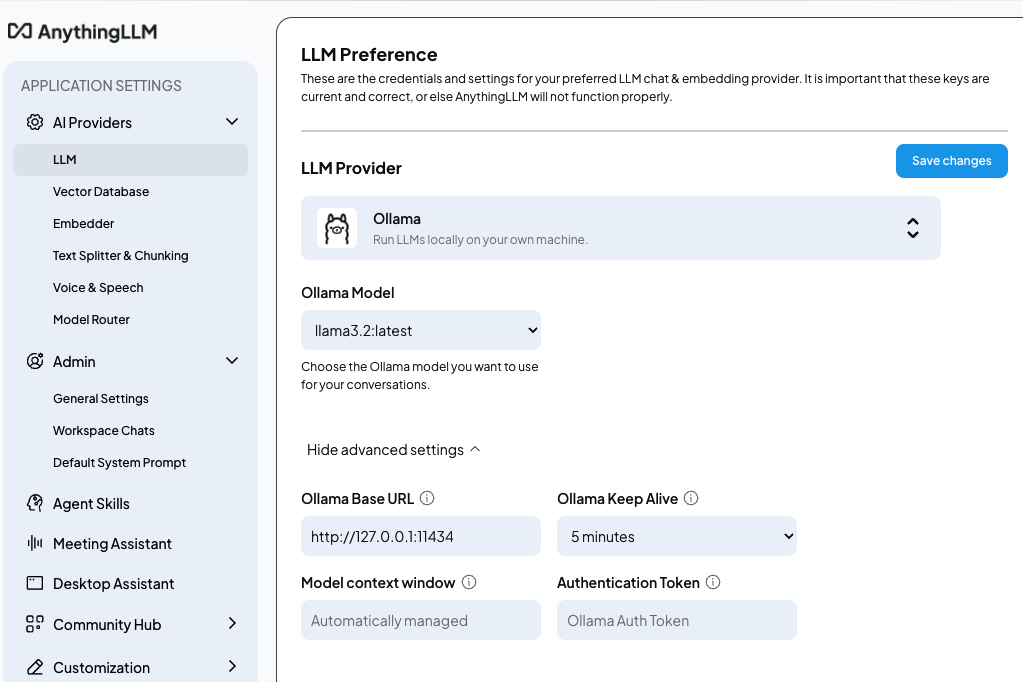
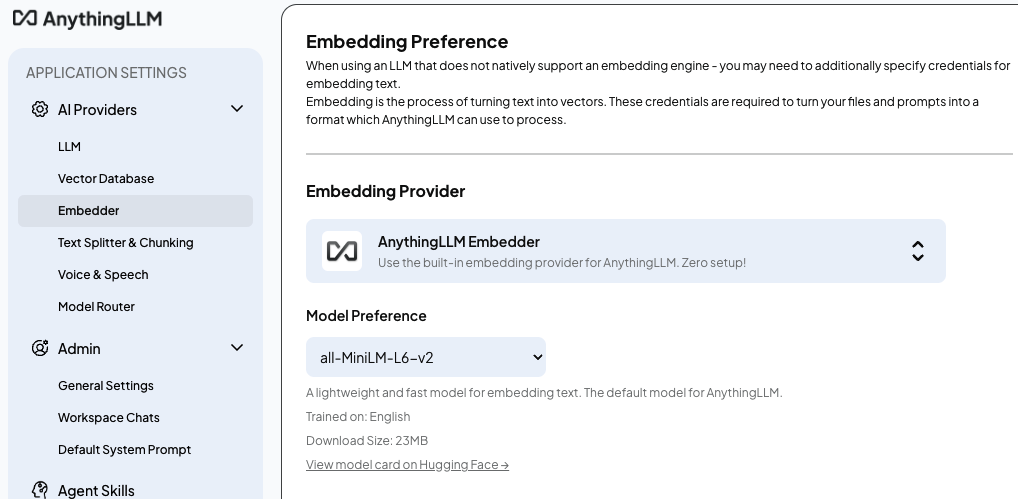
下载安装 AnythingLLM,下面使用它来选择本地模型,选择远程网站或者本地文件,并进行本地 RAG(检索增强生成,Retrieval-Augmented Generation),生成属于自己的私有/本地知识库。
设置里面,先选择推理模型(LLM Preference):
再选择嵌入模型(Embedding Preference):
最后选择向量数据库 (Vector Database),保持默认。
使用 Bulk Link Scraper 这个 Data Connector 可以去扒拉网站上的内容:
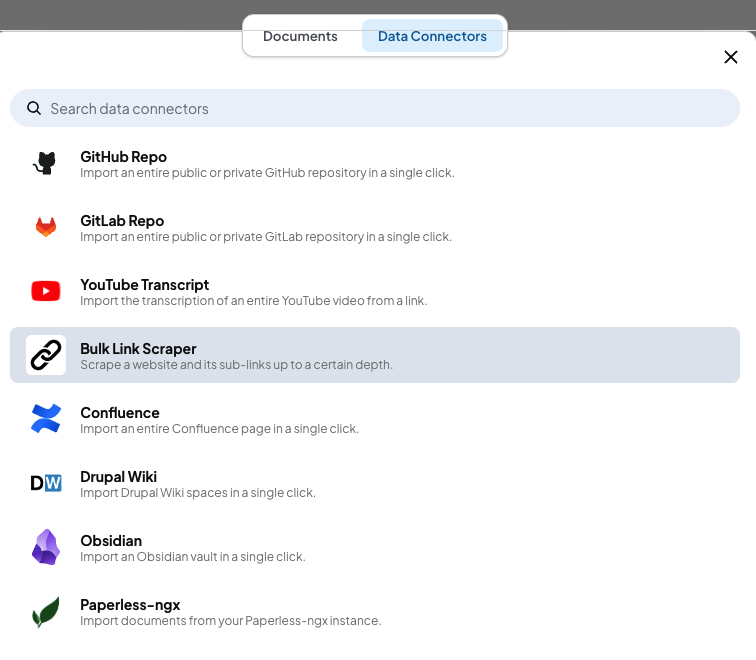
运行 tail -f ~/Library/Application\ Support/anythingllm-desktop/storage/logs/collector*.log 可以看到抓取的详细信息。
抓取完成后,回到 Documents 页就可以把抓到的内容加到 Workspace 里面去:Move to Workspace -> Save and Embed。
除了抓取网页,也可以上传一些本地的文件给它。
不过,文件较多的时候,它的可用性就比较差了。我们需要一些其他的工具。
为了解决前述问题,下面搭建搭建 Dify + 本地 Ollama 的组合。Dify 是一个 “Agentic Workflow Builder”,它底层集成了非结构化数据解析引擎,可以把各种格式的文件转成文本。
首先修改 Ollama 的环境变量,使其监听所有网卡:
launchctl setenv OLLAMA_HOST "0.0.0.0"这一步需要重启 Ollama。
现在本地有的 qwen3 和 llama3 都是 chat 模型,还需要专属的 Embedding 向量模型:
ollama pull nomic-embed-textDify 官方提供了完整的 Docker 编排文件,包含前端、后端、PostgreSQL 数据库、Redis 缓存以及向量索引组件。
git clone https://github.com/langgenius/dify.git
cd dify/docker
cp .env.example .env
再把上面.env 文件的 EXPOSE_NGINX_PORT 这一项端口从 80 改成 8080,以避免冲突。
还需要加上这样的配置以放宽文件上传限制:
UPLOAD_FILE_SIZE_LIMIT=10000
UPLOAD_FILE_BATCH_LIMIT=20000
环境配置文件准备好以后,就可以启动所有容器组件了。
docker compose up -d于是乎,pull 了一大堆 image:
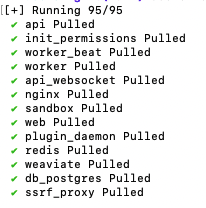
启动了一堆 container。以后要启动和停止,以及看日志,使用:
docker compose down
docker compose up -d
docker compose logs -f
访问 http://localhost:8080/ 并创建用户。
接着 Settings 里面添加 Ollama 的 plugin,
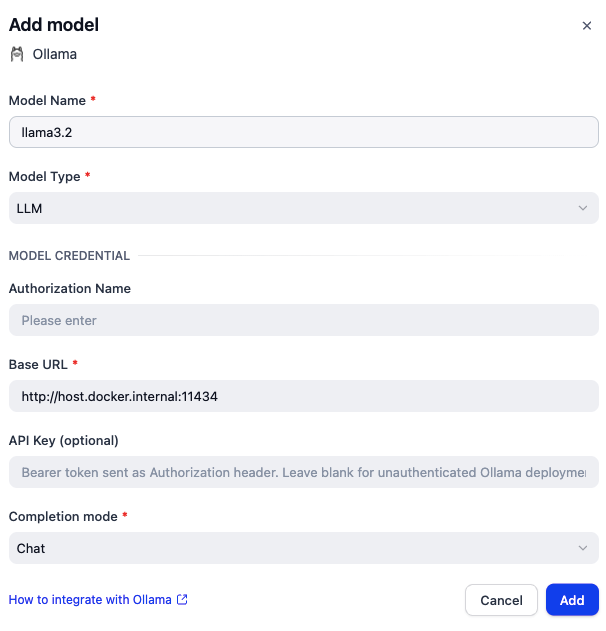
先配置 LLM 的 llama3 模型,再配置 Text Embedded 的 nomic-embed-text 模型。这其中的 Base URL 不能用 localhost,而是要使用 host.docker.internal,因为 Dify 在 Docker 内部运行。
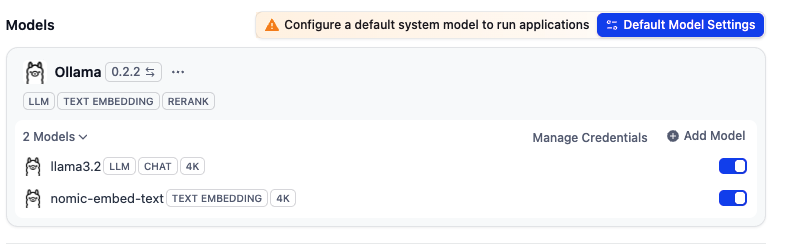
之后,就选中一个知识库,然后分批追加文件。因为软件一次性没法导入一个太大的文件夹,否则页面会卡死,所以这一点需要注意。
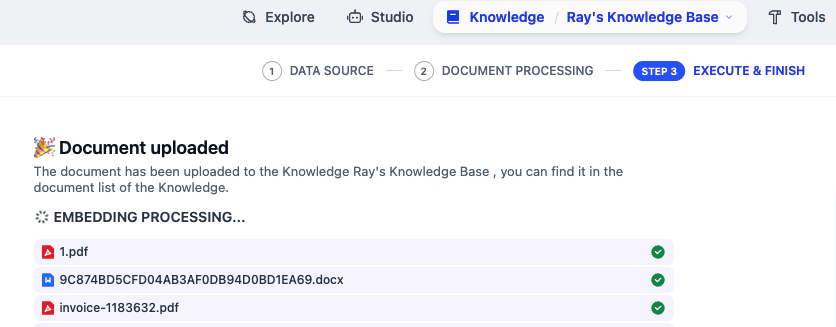
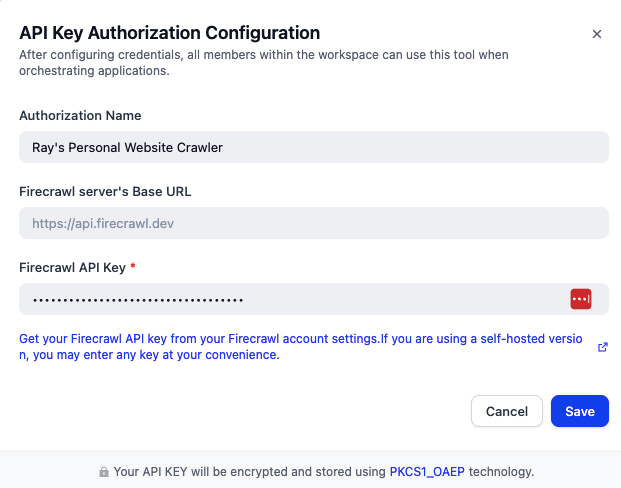
之后,还可以把网站等其它形式的数据导进来,这样自己的知识库就会更加全面。如果是爬网站的话,可以去 Firecrawl 注册一个账号,得到一个 API Key(免费版好像是最多只有 2 active browsers 一起工作,单月 1000 个 credit,不过对我来说也够了),填到 Dify 的 Firecrawl 插件配置中:
然后就可以去爬网站了。
最后,在 Studio 菜单里创建一个 Chatbot 或 Agent,在右侧的 “上下文” 中关联这个知识库。
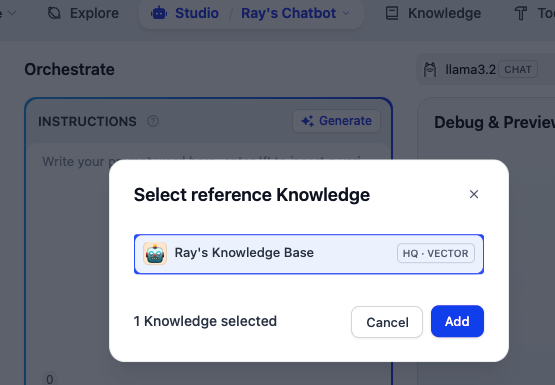
这样,后续问它任何问题,都可以从这个具备个人信息的知识库中进行检索。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》
2026-05-25 08:04:10
raychase.net 这个域名是好些年前申请的,最近申请了个更适合作为我个人标签的 rayxiong.me,简单记录下我把新域名应用到 blog(新、老域名都可以访问 blog),以及创建并使用新域名的邮件地址收发邮件的操作。
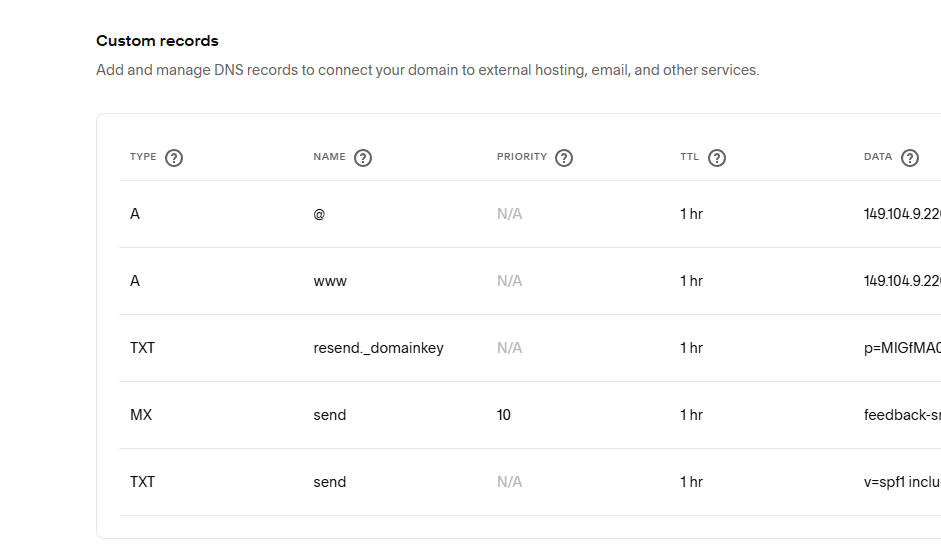
在 Squarespace 上面配置好 DNS 的两个 A 记录:
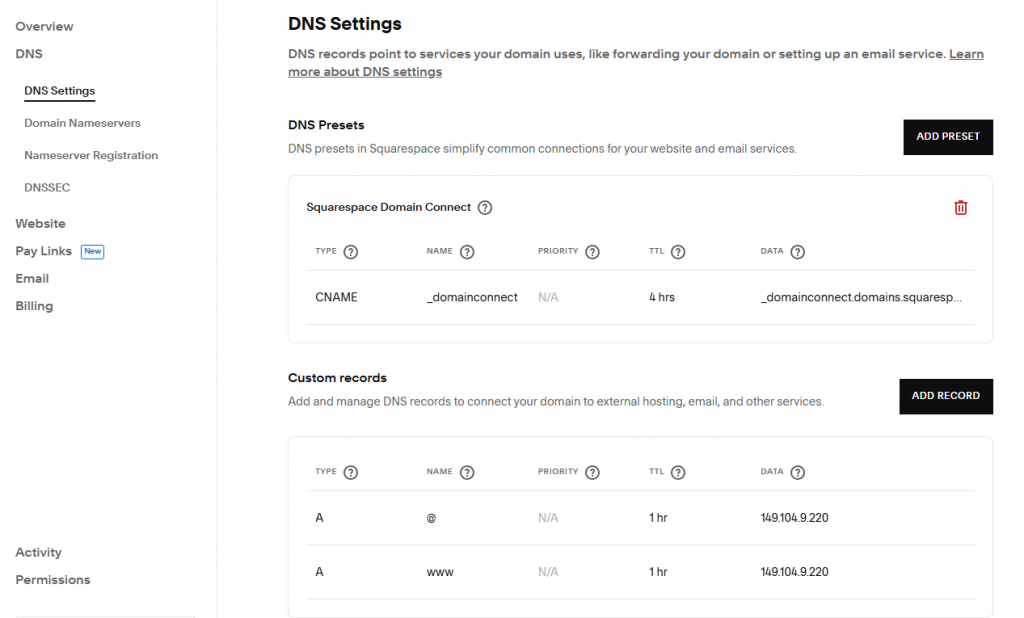
其中 @表示不带任何前缀,它和 www 前缀这样被视为两条独立的记录。没法再简单了,不过需要等几个钟头生效。
在网站的 Nginx 配置文件上面添加:
server_name www.rayxiong.me rayxiong.me;
以及:
    if ($host = rayxiong.me) {
        return 301 https://$host$request_uri;
    }
    if ($host = www.rayxiong.me) {
        return 301 https://$host$request_uri;
    }
做完之后检查一下有没有语法错误:
/usr/local/nginx/sbin/nginx -t我已经忘记之前证书怎么处理的了,重新安装 acme.sh:
curl https://get.acme.sh | sh -s [email protected]使用 acme.sh 来申请多域名证书:
~/.acme.sh/acme.sh --issue --nginx -d raychase.net -d www.raychase.net -d rayxiong.me -d www.rayxiong.me -w /home/www.raychase.net如果不想牵扯 Nginx 的瓜葛,因为已经指定了网站根目录,也可以使用 letsencrypt 的 server 来完成:
~/.acme.sh/acme.sh --issue \
-d raychase.net -d www.raychase.net \
-d rayxiong.me -d www.rayxiong.me \
-w /home/www.raychase.net \
--server letsencrypt --force
再把证书部署一下:
~/.acme.sh/acme.sh --install-cert -d raychase.net -d rayxiong.me\
--key-file /etc/letsencrypt/live/www.raychase.net/privkey.pem \
--fullchain-file /etc/letsencrypt/live/www.raychase.net/fullchain.pem \
--reloadcmd "/usr/local/nginx/sbin/nginx -s reload"
完工。访问网站看看证书的情况,再检查一下定时任务是不是已经顺利加上了:
crontab -lBlog 的文章里面,不能有写死域名的链接,全部要使用相对路径。接着就是给 wp-config.php 添加动态设置 Home 和 SiteURL,否则首页到不同栏目的链接都还是老地址:
if (isset($_SERVER['HTTP_HOST'])) {
    define('WP_HOME', 'https://' . $_SERVER['HTTP_HOST']);
    define('WP_SITEURL', 'https://' . $_SERVER['HTTP_HOST']);
}
设置了之后,WordPress 的管理台的 General Settings 里面,这两个变量会置灰:
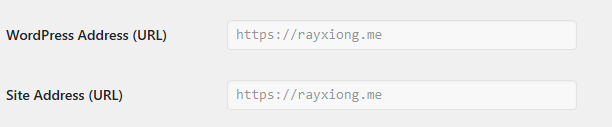
此外,考虑到两个域名包含相同的内容,需要告诉搜索引擎谁才是 canonical 的版本,否则搜索引擎可能会做出负面的判定。在 WordPress 菜单的 Apperance->Theme File Editor->Theme Functions (functions.php) 的尾部,写上:
remove_action( 'wp_head', 'rel_canonical' );

add_action( 'wp_head', function() {
echo '<link rel="canonical" href="https://www.raychase.net' . esc_url( $_SERVER['REQUEST_URI'] ) . '" />' . "\n";
});有了新的域名,打算搞一个个人标识鲜明的邮件地址 [email protected]。但是我打算只是创建一个邮件地址,邮箱服务依然使用 Gmail。
先配置收信,收信比较简单,保证 email 转发到原有邮件地址:
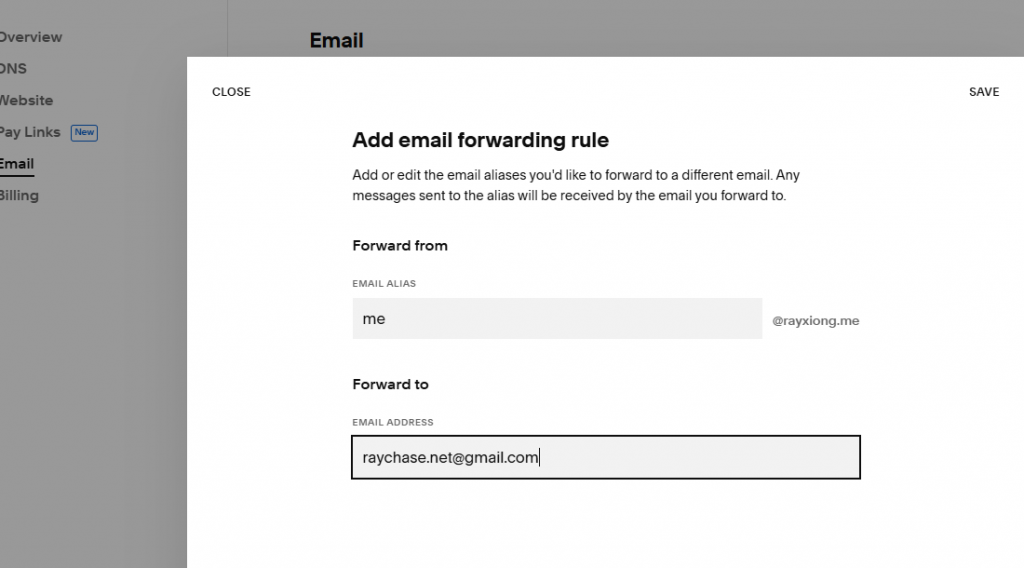
得花些时间生效,测试一下,发送到这个新邮件地址一旦成功,那收信路径就通了。
接着是发送。这需要 Resend 这样的工具。
建立一个 rayxiong.me 的 domain,然后添加如下的 DNS 记录:
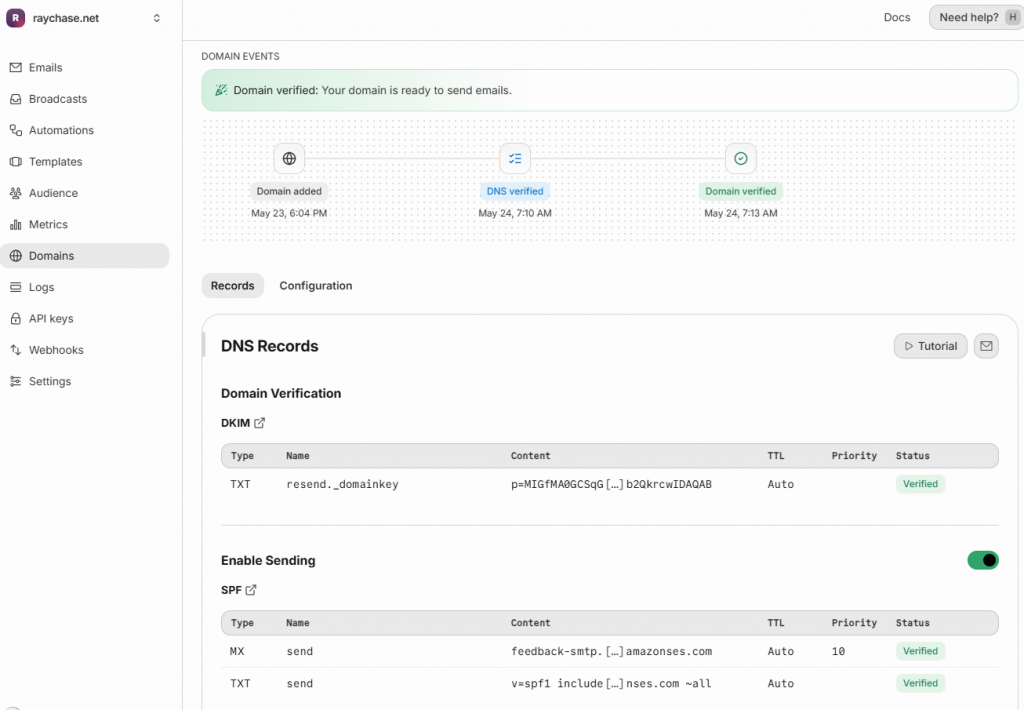
把这些 records 拷贝到 Squarespace 的 DNS 设置里面,然后再回到 Resend 上面来验证,确保验证通过。
如果失败了,可以去 Logs 页面看错误信息。
现在,去 Sender 的 API keys 里面,给配一个 Gmail-SMTP 的 API Key:
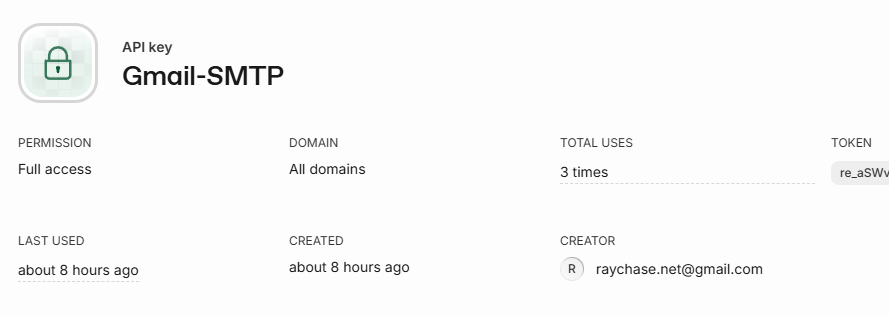
接着就可以给 Google 邮箱配置这个新的 email 地址了:
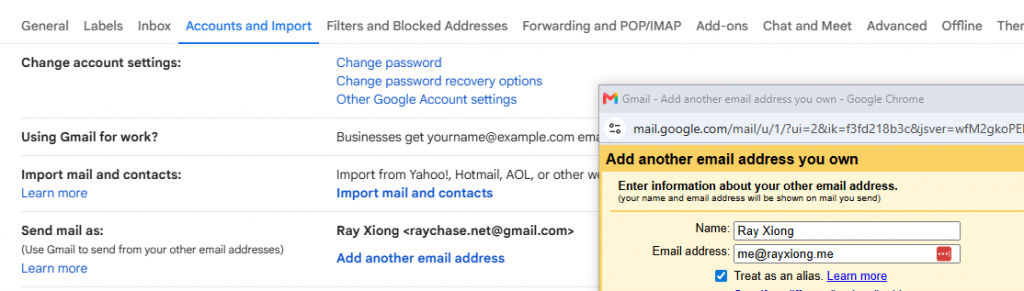
SMTP 服务器是 smtp.resend.com,这里需要使用到前面配置的 API key:
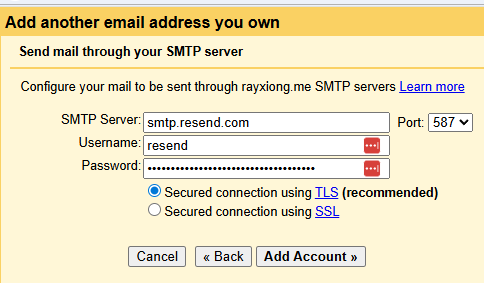
手机上面配置起来有点麻烦,需要创建一个新账户。
收邮件的部分,host name 写 imap.gmail.com,用户名写原本的 gmail 邮箱名,密码的话需要去 Google 的 App passwords 创建一个只能查看一次的密码,填在这里。
发邮件的部分,配置 SMTP 为 smtp.resend.com,用户名是 resend,密码就是前面的 API key。
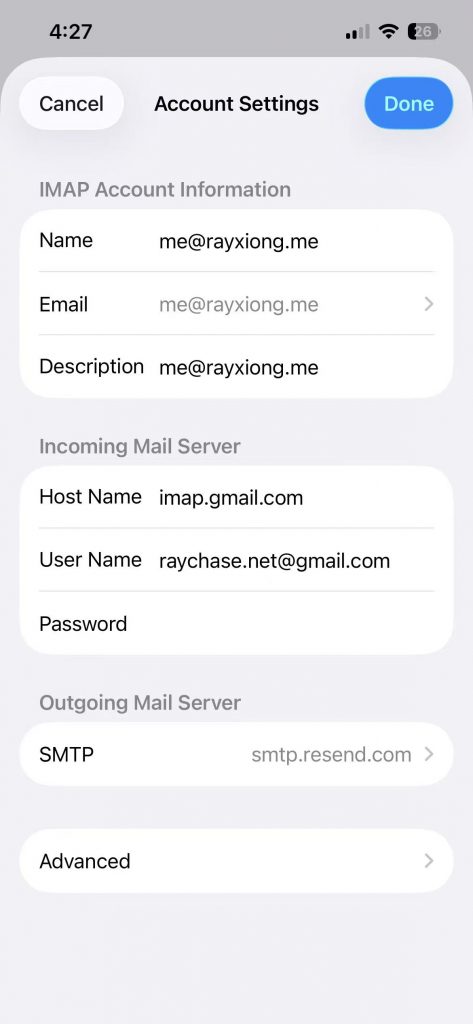
此外,Resend 的 DNS records 目前只配置了 sending,并没有 receiving。因为现在邮件的 receiving 是通过 Squarespace 的 Mailgun forwarding 来实现的,如果要配置 Resend 的 receiving,那是用于把邮件内容转成 JSON 数据并根据配置的 Webhook 来调用 API 只用了,目前不需要。
除了 blog 和 email,对于这样一个个人标签浓厚的域名,不知道还有哪些有趣的事情可以做。我想到的几个包括:
只是我的一些想法,不知道还有什么有意思的主意。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》
2026-03-23 07:38:30
 作为一个老暗黑粉,二十年前,写过一点关于它的碎文。那时候我还在读书,《暗黑破坏神 2》应该是对我影响最大的一款游戏。还记得第一次接触到暗黑的那天——在家乡暑假的某个阴沉的下午,窗外雨绵绵,一进入游戏,第一幕的罗格营地,就被呼应的下雨细节打动,音乐、雨滴声,还有可以追随地散布的鸡,一切都让我觉得有巨大的沉浸感。于是我一遍又一遍地杀到城外去,杀到地下洞穴去。暗黑游戏的视觉效果我相信不是最好的,但是游戏性和耐玩度却是顶级的。在这以后,也玩过不少类暗黑的游戏,比如《流放之路》(那时候还写过一点关于它游戏中通货膨胀的思考),再没有一款能给我带来那样的体验。
后来我慢慢知道,原来有这样感受的不止我一人。《暗黑破坏神 2》是整个电子游戏历史上具里程碑意义的作品,它几乎凭借一己之力奠定了整个 ARPG 的游戏框架和标准,如今的 ARPG 砍杀的游戏方式,就是从它开始的。暗黑 2 的装备系统、技能树,还有怪物系统等等,在当时都是首创,并且都引领了后来的游戏发展方向。比方说,从暗黑 2 开始,装备的颜色分级制和词缀系统开始流行开来,也是从暗黑 2 开始,一类被称为 “刷子游戏” 的游戏类型,也开始被玩家逐渐认识;再比方说,技能树和后来资料片引入的技能加成系统,也逐渐演化出了游戏角色流派构建的理论。
暴雪的暗黑 3、暗黑 4,尤其是暗黑手游版,口碑时好时坏,但拿暗黑 2 的标准来比,可真是不怎么样。其实,对于一款过于成功的游戏,推出续作总是充满挑战,甚至可以说凶多吉少。不过,暗黑 2 之后的续作充满故事的张力——暗黑 3 一开始是糟糕的,尤其是那个著名的拍卖行,彻底让游戏失去了原有的平衡,之后《夺魂之镰》的资料片,挽回了一定的名声。再是暗黑 4,一开始黑暗压抑的美术风格获得了好评,但在游戏性,尤其是可重复玩性上大不如前几作,后来才在装备系统的改革等变更中逐步挽回名声。但无论如何,我觉得和暗黑 2 的那种哥特式氛围,装备驱动的打怪逻辑,还有高自由度的角色培养系统这些方面比起来,如若拿巅峰之作和优秀作品类比一样,这两者完全不可同日而语。
说起来,2021 年,暗黑 2 曾出了高清重制版,让那些二十年前的充满情怀的老玩家,得已不借助非官方的高清分辨率补丁,在如今的高配置机器上重温暗黑 2。回想起来,其实这样炒冷饭的做法也不算特别,印象中不少以前一样感动一票玩家的游戏,比如《最终幻想》系列的好几款游戏,都出过重制版。不过,在暗黑 2 发售的将近 25 年后,居然再推出一个完整的新角色 “术士”——《术士君临》资料片,却是真正让所有人都大吃一惊。
从商业上看,这次试一次非常精明的商业决策,整个过程保密性做得非常好,间隔超过 25 年的产品营销,这冷饭炒得也可以说登峰造极了。同时,也算对玩家社区给足情面了,之前暴雪被微软收购,微软是下了一步绝好的棋,但是玩家群体之间的口碑需要建立起来,这次看起来是一次非常成功的操作。无论如何,从数据上看,日活玩家增长超过了 50%,这是一个非常正面的信号,这些玩家的粘性可比一般游戏高得多。别忘了,这个资料片只是增加了一个角色,它并没有增加任何主线故事情节上的内容,它卖得并不能算便宜。
现在,我好奇的是暴雪下一步会如何打算。如果往回倒退几年,你问暗黑 2 还会出资料片吗,那一定会被喷痴人说梦。但是现在随着术士资料片的上线,我觉得暗黑 2 再续写下去,看起来完全合理。如果我们再回想到 25 年前,很明显暗黑 2 的第四幕是明显缩短的,有一种讲故事草草收尾的感觉,而且分辨率那时候也只有 640×480,于是一年之后的 2001 年,暗黑 2 资料片《毁灭之王》就以一个内容足量的第五幕弥补了玩家的遗憾,并且带来了更高分辨率、引入技能加成、引入符文和宝石系统等等巨量变更。可是想一想,一款成功到载入史册的游戏,从游戏内容上看,有什么理由会只出这么两部资料片,尤其是只有第一部是有 “主线剧情” 的,无论是从商业上考量还是情怀上考量,完全可以制作第六幕啊。
如果是一个新玩家接触暗黑 2,他的视角会是怎样的?我觉得暗黑 2 的视觉效果肯定不算好,虽说重制版让它和当年相比有了改进——可是话说回来,暗黑 2 从来都不是一个以画面取胜的游戏,它的可重复玩的游戏性无可匹敌,它的社区有一群坚持原教旨主义的硬核支持者,它在这个游戏史上写下了独一无二、浓墨重彩的一笔,而我觉得,二十五年过去了,这一笔却还远没有写完。
文章未经特殊标明皆为本人原创,未经许可不得用于任何商业用途,转载请保持完整性并注明来源链接 《四火的唠叨》


