2026-10-05 10:01:38
整修博客的时候才注意到居然离上次更新已经超过一年了。虽然之前引入了 TIL 希望能有更频繁的分享,但最后看因为各种原因还是没有能继续下来。(不过 书签 和 书签摘要 倒是一直有在更新。)从 2025 年底到现在(2026 年 10 月)发生了许多事情,思想和心态也有了一些变化,想来还是写一篇随记,在此和各位读者分享,欢迎评论交流。
其实很早之前就有跳槽的想法了,25 年底也做了一些尝试,但是今年真正迈出了最大的一步。大厂固然很好,但是 25 年底到 26 年春,身边几个要好的同事相继选择了离开,有的内部转岗,有的跳去了其他公司;虽然没有和他们深入交流过原因,但其实自己也能逐步感觉到,工作压力的增加、监管日益趋严、组织中对 AI 的盲目推行、为汇报留痕的内耗空转…甚至于只要在内网看到 AI 相关的关键字,就会有一种生理上的厌恶,想要呕吐。
26 年 7 月,通过一位校友的内推,我更新简历并投递,正式开始了新公司的招聘流程。工作太久,对面试知识早已生疏,日常上班之外还得早起刷题。好在多轮面试(线上 + onsite)后,总算成功在 7 月底拿到了 offer。说来也巧,拿到 offer 的当晚我就提交了辞呈,然而第二天(前半年的评估结果公开日),我才知道自己获得了高等级,还有涨薪和股票。但即便有这些激励,还有多层上级的挽留面谈,我也无心再在这里耗下去了。(某位上级也提到,ta 之前已经注意到我的负荷过高,准备增添人手,但还没来得及调整。)因为担心触发竞业协议,离职理由写的是健康原因,不过也不算是借口,毕竟高血压和入睡困难是真实存在的。最后离职交接又花了一个月,补文档、画架构图、以及处理新的工作(是的,因为有同事休假,直到最后依然在干活),交接之后把我一个人的职责拆给了五个人。在 8 月底总算结束了我在前司 4 年多一点点的职业生涯,走出大楼的那一刻,久违看到了一次夕阳,如释重负。如果有我的前同事读到这里,感谢之前的合作和陪伴,在此祝你们后续一切顺利吧。
8 月底离职后,其实没有休息多久,9 月初就入职了新公司,现在也还在 landing 中。虽然新的岗位没有解决我的一切痛点(有些东西毕竟还是得入职了才知道,这样预期大概也不现实),但整个人的心态感觉好了很多,比起之前那种每天数日子的感觉算是极大的改善了。尽管有的时候还会思考跳槽是否值得(薪资增长幅度不高,还放弃了 27 年初已经确定的股票),但最后综合各方面充分复盘了一次,还是认为选择跳槽是当时的最优解了。后续可能会对新工作有更多分享,但是还是先不要太过期待吧。
和新的工作相伴而来的,是城市的变更,从深圳搬到了杭州。现在在杭州只住了一个月不到,还不能说对这个城市有充分的认识,但城市氛围的确与打工之城截然不同,感觉上更平静更松弛。非机动车道的划分也是杭州明显比深圳强的一点(不过可能几乎所有城市都比深圳强),走在路上被电鸡滴的概率大幅降低(虽然逆行的电鸡还是会走人行道)。之前 25 年 8 月和妹妹来杭州旅游过一次,但当时只是走马观花的看了几个景点,没想到现在却在此定居了。想要揭开这座城市的面纱,大概还需要后面逐步探索吧。此外江浙沪包邮区果然名不虚传,大部分购物都能做到次日达(甚至当日达),着实方便。
人际交往上,之前深圳的圈子就只能线上交流了,不过也在重新激活上海的好友。杭州-上海的高铁班次频繁,运行时间也不长,五十分钟可能比城市内长距离移动还短,后续也可以考虑周末去逛逛上海的各种活动。
最大的生活改善莫过于住宿条件了。此前在深圳的时候,在公司附近租了一室的小公寓,主要考虑的是距离近,上班一站地铁,下班直接走回去;但房价本身很小,价格却挺高,而且还在逐年涨价;来到杭州后,虽然找房颇有些波折,但最后还是选择了一个离公司两站路的商品房小区,以更低的价格租到了两室一厅的房子,甚至还搬了个椭圆机回家。不过也因此通勤时间有些上涨,单程门到门快半个小时了,天气许可的话走走还挺好的,但不知道后面降温或暴雨会如何(实在不行打个车应该也还好)。
24 年中我开始写周记,26 年初决定细化到日记。写周记的时候常常只记得几件大事,但日记写的频繁,即使只是写流水账,记录下一天中的事情和心情,但粒度会细很多,能捕捉更多细节。写的过程本身也是整理和释放,写完了会有一天真正结束了的轻松感。更重要的作用是细粒度数据也是 AI 极好的上下文,常常可以在讨论中发掘出之前的一些细节,其实已经暗示了某种动机,并引导出了最后的决策。
之前在深圳,回家就是半小时地铁的事情,每个周末都会回家吃顿饭。但来了杭州后,回一趟家就意味着单程 5 个半小时的高铁,或 5 个小时的飞机(算上机场来回时间)了,无论是时间成本还是金钱成本都增加了不少。其实很早就想过,成年后和父母家人陪伴的时间越来越少,可能累积起来 90% 和父母在一起的时间都是成年之前,成年之后就剩 10% 了。但之前还能以还在同一个城市,有什么事可以随时处理来安慰自己,现在则是要正视这一事实了。和几位同学朋友问过,他们也只是有意识安排回家的时间,但除此之外也无太多能做。可能这就是现实吧,不同世代终究会有自己的生活。
妹妹今年 9 月升入了初三,明年就要迎来她人生中的第一次大考。暑假和周末都有在上补习班,成绩总体来看在年级上游,但是没有那么拔尖,有的科目成绩依然不太稳定。国庆回家的时候,就妹妹的教育和父亲做了激烈的讨论,父亲的观点还是上一辈主流的收手机平板,多报班多看课,争取多拿几分干掉千人上个好高中。但我认为妹妹在这个年纪已经有自己的主见,能自己管理学习和兴趣爱好,知道自己需要什么样的帮助;家长应该做好副驾,可以指路,可以提供帮助,但是不要下手微操;作为学生,能维持住自己的排名就已经十分努力了,没有必要为了几分把关系闹僵,或者是进一步恶化现状。最后大家都默默看手机吃水果了,希望父亲能听进去吧。不过其实我自己也有点忐忑,这终究还是基于我自己对妹妹的理解,我看到的终究也只是一个侧面。但无论如何,还是希望做哥哥能做的一切,让她在家里能过得没这么压抑吧。
一转眼已经 27 岁了,身边的不少同学朋友都已经有了伴侣,进入了婚姻,甚至已经生孩子了。虽然家里之前也有过旁敲侧击的询问,但至少还没有主动的催婚操作。但可能是个人性格使然吧,对我来说我不太能感受到感情对我的吸引力和必要性,但不排除也可能之前伤得太深了。总之目前这不在优先级列表上,没有主动出击的想法,先边走边看吧。
我 22 年 8 月开始了自己的第一份工作,22 年 11 月 ChatGPT 惊天出世,拉开了波澜壮阔的 AI 时代。(爆发的主要是 LLM,但还是和主流语境一样统称 AI 了。)每一年模型的能力都在飞速提升,开源模型也在不断追赶闭源模型;到了 26 年 10 月这个时间点上,写代码这件事完全由 AI 承担几乎已经成为了每个程序员的日常,无人软件工厂也不再是幻想。目前流程中的主要卡点,将变更投入生产(灰度、监控、回滚),这些事情虽然目前还是人来做,但是前沿实验室也开始攻破这最后的堡垒了。
但是 AI 来了之后,作为程序员,其实并没有感觉工作变轻松了,反倒是工作量预期上涨,并行度增加,上下文切换更频繁。AI 提高了生产力,但也让更多之前没空做的需求被释放了出来,而这些需求是否真的要做反而可能存疑。另一个问题是对 AI 写的代码做 review,需要结合对当前代码库的理解,以及自己的架构品味,这都需要时间和经验来获得。代码评审引入 AI 基本已经成为共识,但当 AI 给出了十几条评论,到底哪些应该修,哪些是 nitpick 或者纯粹是被害妄想(例如对绝无可能出现的边界条件加防御性分支),目前看即使是前沿闭源模型依然无法比较准确的判断。有的公司相对激进,选择只靠测试和 AI 复审,自己跑 review - 修复循环,但长远来看都会造成代码量的暴涨,完成同样大小的需求变更范围越来越大(更为人所知的可能是 “屎山化”)。这些问题随着模型能力的提升,上下文窗口的增长,或许会有改善,但目前来看还是需要人在环中做一些事情的。
写到这里了就不得不提职业生涯的问题。前有新人断代,后有老人去哪。新人断代已经是老生常谈了,毕竟 AI 比招新人再培养更容易也更便宜,无论是前司实习生转正名额有限,还是现在校招暴跌但社招尚存,都是这一问题的表现。有人认为新人应该通过开源贡献、实习等方式尽早展示自己的能力,但我觉得有些悲观,开源社区本身已经被 AI slop MR 塞爆了,实习则有递归问题,难以找到第一份实习机会。然而我自己也没有很好的办法,更多的得看后人的智慧了。老人的标准也在不断下调,之前很多人说是 35 岁,目前看可能 30 岁就开始危险了,遇到比你年轻还比你能出活的年轻人是必然事实,即使模型因为某些限制未能完全掌握经验和品味,但至少需要的人数会少很多。我感觉也看不到解法,可能就是趁着年轻多赚点钱,尽早准备转型和后路吧。
之前有位好友问我,跳槽+跨城的决策这么重,影响这么大,ta 自己觉得没有这个魄力,我做决策的时候会犹豫吗?我想了下,之前的几次大决策(高考志愿、出国读硕士、毕业秋招offer选择、跳槽),虽然理性上列了对比表一项项评分,但最后还是感性占了上风,在各种情感的影响下做了选择。可能这就是性格使然吧,潜藏在 J 人(判断型)外壳下的 P 人(知觉型)内核。初中时我就发现,自己只能计划两周内的事情,更远的事情就只能顺其自然,尽人事知天命了。未来想必还有不少选择,小到生活细节、开源项目,大到工作和人生决策。希望自己能保持探索和开放,跟随本心前进吧。(当然如果能顺手更新下这个博客就更好了。)
想起来还有一件事,是找到工作之外的其他生活目标。之前陆陆续续有过一些,考过软考高级,拿到驾照…打算开始自己学着做饭,至少能到可以自己完成简单一日三餐的程度吧。
初中和高中还是作文困难户,没想到一下子洋洋洒洒写了三千多字了。如果你看到这里,感谢阅读我在高铁上没有头绪的大脑 dump。希望我的分享没有浪费你的时间。
(本文 AI 含量:0%)
2025-09-21 22:58:00
读某些新闻网站或公众号的时候,常常会越读越有种隐约的广告感(“这是广告吗?"),直到读到文末才彻底验证(”这果然就是广告吧!“)。之前买了 GLM 20 元一个月的 coding 套餐(agent 用的是 claude code),那就顺手 vibe coding 一个小工具来识别吧。于是就有了”软文检测器“。
这个小 app 本身并没有什么特别值得说道的,毕竟只是顺手做的玩具,代码我也没有仔细审查,看起来似乎没啥问题而且也能跑就提交了。作为一个 llm wraper,基本上就是一个 fastapi 后端加一个很简单的 vanilla js 前端(甚至没有用框架),前端提交内容后扔给 llm,然后用 sse 推送响应,来避免前端长时间卡住不出结果。模型上用的是 gemini-flash-2.0,是我能找到的速度-质量-价格最佳平衡点,而且 gemini flash 本身就极其便宜了,极大缓解了我的 llm 用量焦虑。prompt 是 deepseek r1 写的,在 repo 的 json 文件里可以找到,生成后稍微人工调整了一下但没有大改。
有人可能会好奇,在 llm 生成响应的过程中,返回的 json 并不完整,前端是如何保证展示有效内容的呢。实际上这里参考了苹果 wwdc 25 的 Snapshot streaming 的做法,虽然 llm 返回的响应并不是完整的 json,但是有库可以尝试从不完整的 json 解析出有效的 json,我用的是 promplate/partial-json-parser(原理大概是自定义一个更宽松的parser) ,在后端包一层,就可以确保前端每次 sse 拿到的 event 都是有效 json了(虽然可能部分字段不完整)。
自己稍微玩了玩,确认没啥问题了之后,就开始想怎么部署到公网上。vibe coding 极大简化了写代码(如果你不在乎这个项目的长期可维护性,只是想创建个能用的 mvp);但是 vibe deploying 并没有成熟度能与之相当的工具链。不少人用 supabase,但是对我这样一个简单的 llm wrapper 来说未免有点太重了,部署在别人的平台上也有点感觉不太安心(担心哪天超过 free tier 被收钱,虽然概率极其之小)。自己部署的话,又有不少前期工作需要做,例如子域名、网关、https、daemon化等等。我之前大部分分享出去的小工具都是纯前端的,扔在 github pages 上就完事了,最多写个 yaml 配置下 ci,带后端的对外工具实际上这还是第一个。最后分享欲还是战胜了嫌麻烦的心态,决定后端扔在一个不怎么用的云服务器上(服务器本身的开销可以忽略不计),前端还是放 github pages。最后满打满算下来,这个项目写代码&自测的时间,可能还没有准备部署环境&实际部署的时间长。
关于 llm 的应用,其实还涉及到一个控制用量(aka 限额)的问题。虽然我倒是不太介意在这种小玩具上每个月花点小钱(一瓶无糖可乐的价格都够一个便宜 llm 模型用很久了),但是我不想失去控制我能花多少钱的能力。一开始想的是在后端自己写个限额,或者直接用现成的库,但感觉涉及到钱的话还是有些危险,于是搁置了。手写限额的话,还需要考虑状态存储,就又多引入了一层复杂性(例如 cloudflare worker kv 每天只有 1k 写额度,上 durable object 或者 d1 也太重了。)顺带吐槽下,国内好几家主流的 LLM 服务提供商,都没有 by api key 限制使用额度的能力,但是在国外(如 openrouter)或各类中转商,这是基础的不能再基础的能力了。最后找了个支持 api key 限额的中转服务商,才算放下心来,知道再怎么刷也不会把我的账户刷爆了。
最后是可观测性,出于一些小小的私心,还是希望看看有多少人用过。为此前端加了 google analytics,后端用 opentelemetry 上报 trace 到 uptrace (他们家免费额度很宽裕)。最后实际上因为没怎么做推广(只在两个论坛上发了简单介绍),当然也没啥人用,最后大概是一天10个请求的样子,我自己的请求可能就占了一半。
一些未来的可能优化点(如果我还有兴趣在这个项目上继续投入的话):
另外还有一些想法:
这篇文章有点混乱,想到哪里就写到哪里了,只是我个人的 brain dump。如果你能读到这里,那真是辛苦了。
2025-08-13 00:45:01
起因是逛 YouTube 时看到了 Armin Ronacher 的这两个视频:
看起来很酷炫,但实际上原理很简单:screen/tmux 都支持通过命令行传递输入并返回当前正在展示的内容,只需要写个文档让 Claude Code 用就好了(见文末)。
-X stuff 输入,-X hardcopy 输出send-keys 输入,capture-pane 输出甚至还可以 attach 上去看看在做什么。
screen -r ${session_name} (Ctrl+A D 释放)tmux attach-session -t ${session_name} (Ctrl+B D 释放)两者相比,tmux 似乎更好一些,因为 screen 只能输出到文件,llm 还需要再 read 一次;tmux 的输出直接在 stdout,不用多绕一道。
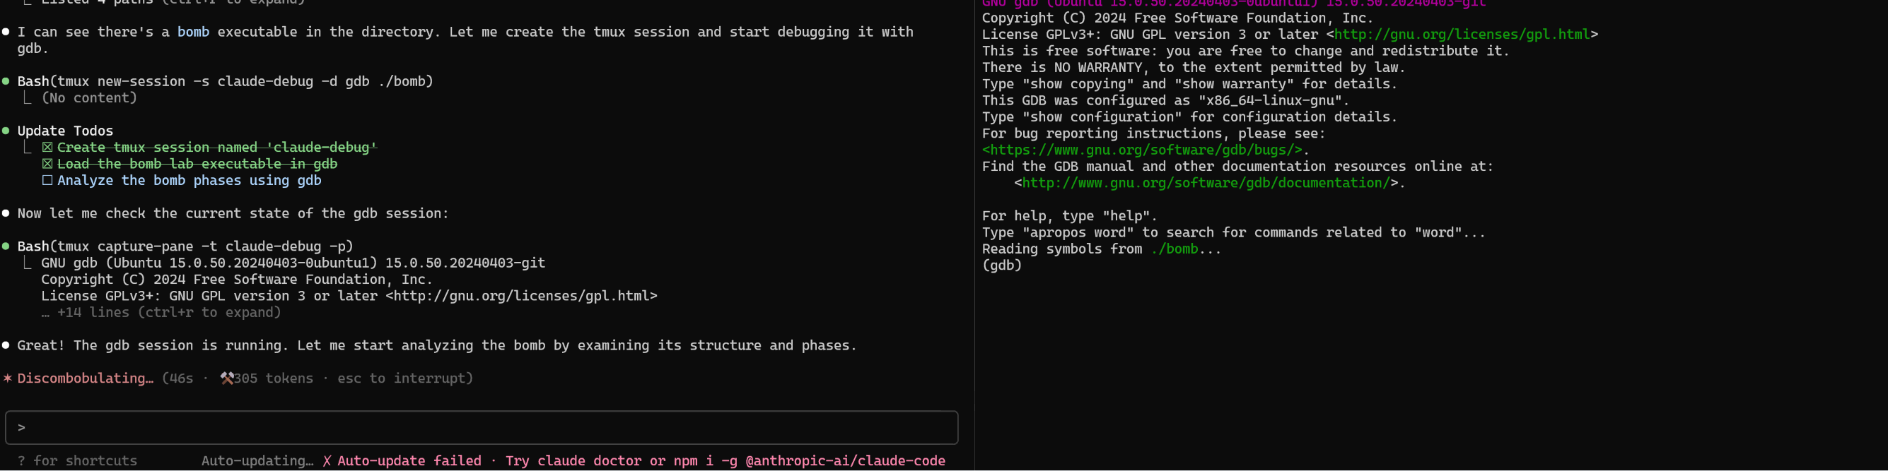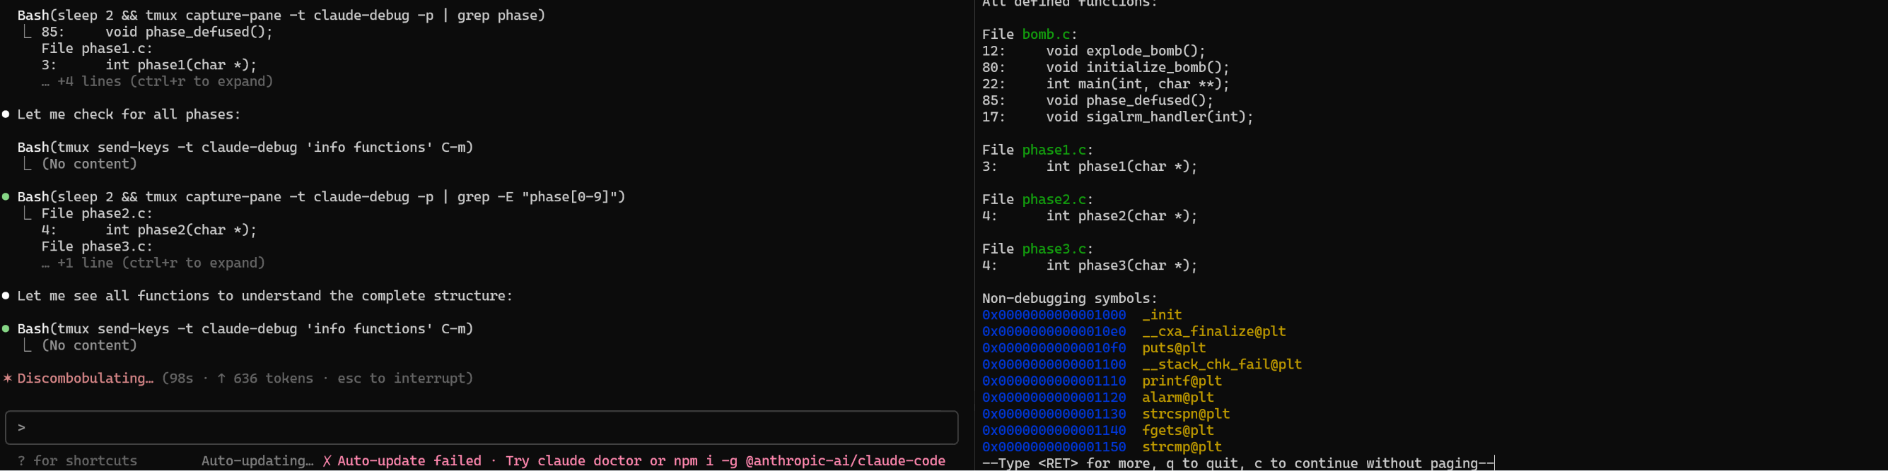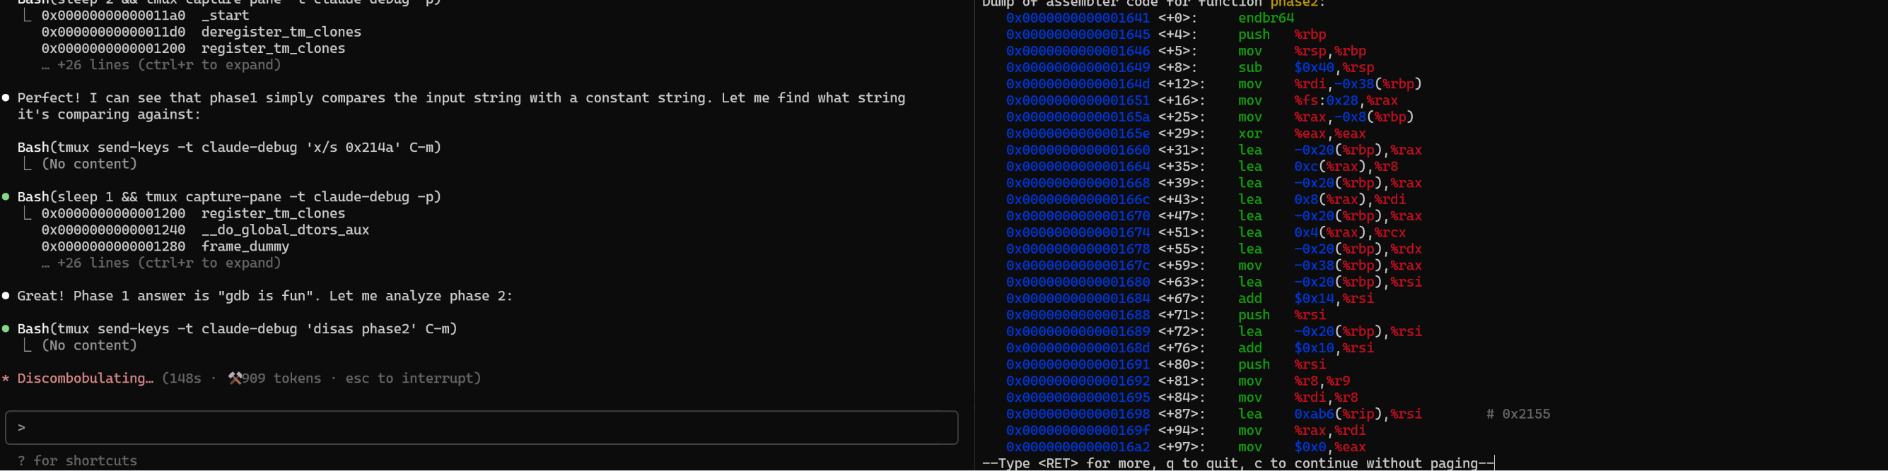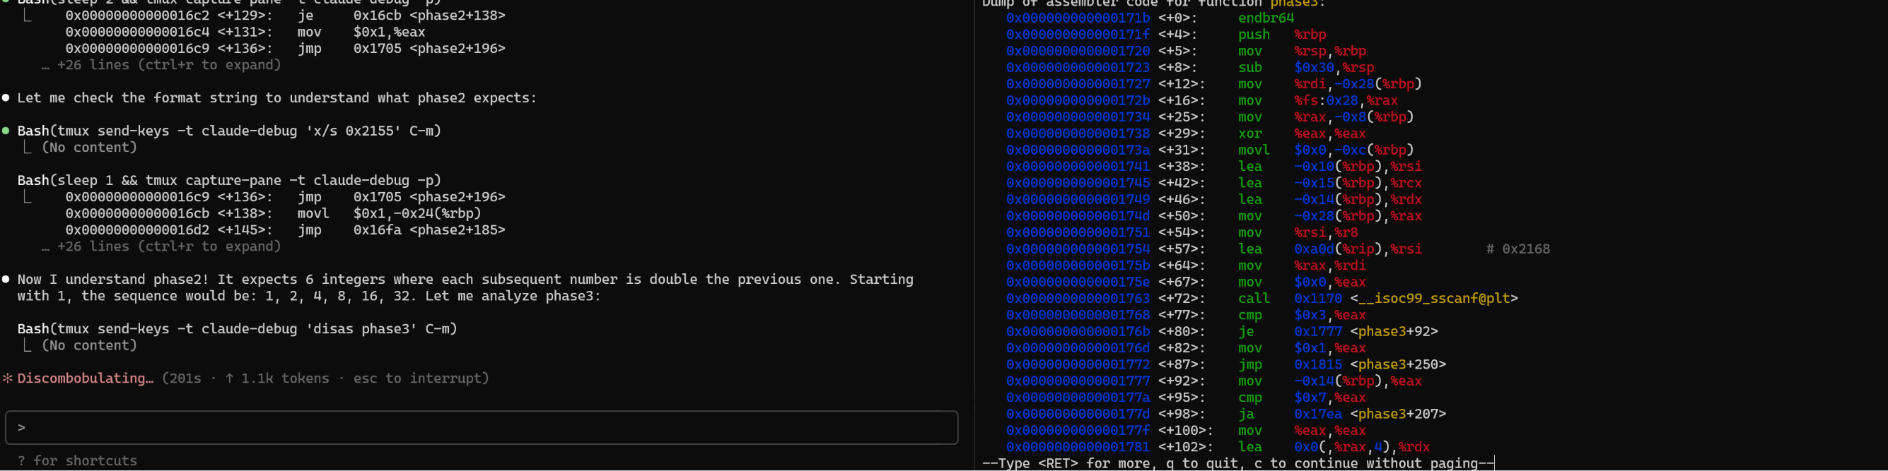
这是一个 GIF 示例,展示了 Claude Code 在 tmux 中使用 gdb 解决经典的 bomb lab 问题。(加速 10x)
这只是一个通用能力的展示;如果你真的想要用 gdb,可能 mcp-gdb 是更好的选择。
完整 prompt:
# Debugging Guide for AI Agents
This guide provides instructions for debugging using `gdb` within terminal multiplexers. It covers two options: `screen` and `tmux`. Use these multiplexers to run a command in a detached session, allowing for input sending, output capturing, and session management. Sessions are named using `${session_name}` for consistency.
Sessions can be started with a specific command (e.g., `gdb`) or empty, with commands sent later. Examples assume a session running `gdb`.
## Using Screen
- **Starting the Session**: Start a detached `screen` session named `${session_name}`. Use flags like `-S` (session name), `-d` (detach), and `-m` (create even if detached). The `${command}` can be `gdb [optional-program]` or any other command.
```bash
screen -S ${session_name} -d -m ${command}
# Example: screen -S my-debug-session -d -m gdb my_program
# Example: screen -S my-shell-session -d -m bash
```
- **Sending Input**: Send strings or commands into the session using the `stuff` command. Use `$'\n'` for newlines.
```bash
screen -S ${session_name} -X stuff $'${input_string}\n'
# Example: screen -S my-debug-session -X stuff $'run
2025-08-03 22:01:12
TLDR:虽然 JDK 镜像内容比 JRE 镜像多,但 JDK 镜像的压缩比更高,导致最后镜像大小反而 JDK 比 JRE 小;原因是 JDK 镜像主要用于 CI/CD 流水线,对性能和耗时要求不太高,所以可以用更高的压缩比;但 JRE 镜像主要用于线上服务,对性能要求极高,因此基本没有压缩。
AI 贡献提示:技术探索过程主要由 Claude Code + Kimi K2 完成;文字部分主要为 Gemini Pro 2.5 编写;我仅提供探索方向指导和简单内容编辑。我已在能力范围内确认下述内容的准确性。如发现问题,欢迎留言反馈。
感谢 @ziqin 提出了本文的探索问题。
一位群友在运行 docker image 时发现一个反常的现象:JDK镜像(111MB)竟然比JRE镜像(139MB)小了整整28MB!
但这感觉上不太合理,因为 JDK 是 JRE 的超集,不仅包含了 JRE 的全部功能,还包含了额外的开发工具(如 javac, jdb 等),为什么其镜像反倒还更小呢?这个反直觉的观察结果立刻激起了我们的好奇心。问题提出之时是个工作日的晚上,我并没有太多精力仔细思考,于是我让 Claude Code 来探索这个问题。
我们的调查遵循着从宏观到微观的路径,一步步逼近问题的核心。
我们首先通过 docker exec 进入两个正在运行的容器,对比其内部文件系统的差异。
docker exec jdk-analysis du -sh /usr/lib/jvm/liberica21-lite -> 98.5M
docker exec jre-analysis du -sh /usr/lib/jvm/liberica21-container-jre -> 125.2M
初步结论:差异的根源在于Java安装目录本身。JDK镜像使用的是一个名为 liberica21-lite 的发行版,而JRE镜像使用的是 liberica21-container-jre。
当我们继续深入,对比两者 lib 目录下的核心文件 modules 时,差异变得更加惊人:
modules 文件: 59.3MBmodules 文件: 97.1MBmodules 文件是Java模块化系统的核心,存储了所有的运行时模块。JRE的modules文件竟然比JDK的大了37.8MB! 这几乎完全解释了镜像大小的差异。
但新的问题随之而来:JDK明明包含了更多的模块(如编译器 jdk.compiler、文档工具 jdk.javadoc 等),为什么它的 modules 文件反而更小?
| 对比项 | JDK (liberica21-lite) | JRE (liberica21-container-jre) | 差异 |
|---|---|---|---|
| 模块数量 | 69 个 | 49 个 | +20 个 |
modules 文件大小 |
59.3 MB | 97.1 MB | -37.8 MB |
更多的内容,却占用了更少的空间。这背后一定有更深层次的原因。
为了彻底搞清楚 modules 文件内部的秘密,我们使用 jimage 工具将其解压,并分析了其中包含的每一个资源。真相终于水落石出。
这并非内容差异,而是压缩策略的根本不同!
观察以下对比数据:
| 指标 | JDK (liberica21-lite) | JRE (liberica21-container-jre) | 证据 |
|---|---|---|---|
| 压缩算法 | DEFLATE (zlib) | DEFLATE (zlib) |
jimage工具确认 |
| 压缩级别 | Level 9 (最大) | Level 0 (无) | 资源分析确认 |
| 总资源数 | 28,427 | 22,133 | jimage list --verbose |
| 压缩资源数 | 28,044 (98.7%) | 0 (0.0%) | |
| 未压缩资源数 | 383 (1.3%) | 22,133 (100.0%) | JRE裸奔存储 |
| 压缩后总大小 | 60.4 MB | 100.5 MB | JRE因元数据开销反而变大 |
| 压缩比 | 2.31 : 1 | 0.99 : 1 | JRE压缩比小于1 |
真正的技术根因:
liberica21-lite): 使用了激进的DEFLATE压缩(相当于 jlink --compress=2,级别9)。它将所有工具和资源(包括开发工具、调试信息、所有区域设置)都包含进来,然后用最高效的算法进行压缩,以实现最小的磁盘占用。liberica21-container-jre): 完全没有使用压缩(相当于 jlink --compress=0,级别0/STORE模式)。它精心挑选了生产环境必需的运行时子集,但为了追求最快的启动速度和运行时性能,放弃了压缩。(甚至因为压缩元数据,反而引入了额外的空间开销,导致压缩比小于 1。)这个看似矛盾的设计,实际上是BellSoft针对不同应用场景的深思熟虑的工程决策。
--compress=2)
--compress=0)
我们最初的谜题现在有了清晰的答案:
JDK镜像小,是因为它用极致的压缩,换取了分发和存储的便利。 JRE镜像大,是因为它用空间,换取了生产环境的极致性能。
换句话说:
这次从一个简单的 docker images 命令开始的探案之旅,最终带领我们深入理解了现代 Java 发行版在容器化时代的精妙设计。BellSoft Liberica 的这种差异化策略,并非一个错误,而是一个深刻理解开发者和运维者在不同阶段核心痛点的高级功能。
它告诉我们,在技术的选择上,没有绝对的“好”与“坏”,只有是否“适合”。理解了这些选择背后的逻辑,我们才能在自己的工作中,做出更明智、更高效的决策。
2025-06-22 19:43:02
最近在尝试各类 agent 项目,大部分都支持使用任何 OpenAI 兼容 API 格式的模型提供商,但是作为这个流派最著名的 Claude Code 却只能用自家模型。自家模型其实也不错,但是对我这种无法在生产环境使用,只是用来自己探索和 side project 的场景下太贵了。搜了下似乎没有人介绍过如何让 Claude Code 和非官方模型配合使用,于是决定记录下。
这一方法的核心是 Claude Bridge 这个项目。实现上,和任何计算机科学问题的解决方式一样,加了一个中间层。具体而言,是 patch 了 node 的 fetch 方法,拦截所有向 Anthropic 官方的请求,转换成标准的 OpenAI 格式(其实是作者自己的一个统一 format),调用指定的提供商,在流式响应的时候再转换回 Claude 的 SSE 格式。
这一步参考了 Claude Code 的一个 issue How can I use my API key without signing in?,以及这篇文章 Setting up Claude-Code with API Key。
本步骤解决的问题是,Claude Code 默认情况下只能以 Claude 账号的形式登录(重定向到官方登录页),但不能在不登入账号的情况下直接使用 API Key 发起请求。然而实际上有办法绕过这一限制,只需要创建一个 apiKeyHelper 即可。
首先在 ~/.claude/settings.json 中增加如下内容。(文件没有的话可以先创建)
然后创建 ~/.claude/anthropic_key.sh,填入如下内容:
(因为我们会用第三方模型提供商,所以这里可以随便填写)
最后给让这个 shell 脚本可执行。
用目标提供商和模型替换命令中的参数即可。第一个 openai 参数是提供商格式,也可以换成 gemini 等。详情请参考 Claude Bridge 的 readme 文件。
当然这一方法也不是万能的,有一些已知限制:
(之后可能会写一篇文章对比不同的 agent,但是得看有没有时间了…)
2025-05-25 23:14:16
大概是高一的时候,某个平凡的课间,我打了个哈欠,然后惊恐的发现右侧的下巴卡住了,完全合不上嘴。从此开始了和颞下颌关节紊乱共存的十年。
前几次发生的时候,每次我都如临大敌,校医对此也束手无策,最后只能叫家长来(跨越半个城市)到附近的医院,找口腔科的医生帮我复位。一般这个过程都很痛苦,医生需要在口腔里使劲和关节搏斗。那会大概一个月会出现一次。比较好笑的是,某一次晚自习脱臼又发生了,家长开车来学校,我上车后迷迷糊糊睡着了,醒来的时候还没到医院,但是我突然发现似乎脱臼自己恢复了,于是就直接掉头又回了学校。
但是总是叫家长去医院也不是个事,于是我开始主动寻找缓解方法。在知乎的一个回答上看到热敷的建议后,我尝试用水壶装满热水靠在关节上,用热量让关节放松(医院红外射灯大概也是这个原理)。这个方法有时有效,但效果并不稳定——就像这个病本身一样难以捉摸。
高二那年,我去图书馆在知网上查阅医学论文,试图找到一些思路。这一次有了新发现:口外复位法。这个方法如此重要且有效,以至于我需要在此原文摘录:
以手指在颧骨稍下方颊部的皮肤上确定喙状突顶部的所在位置,然后将拇指放在上面,向后向下按压就能使脱白复位。
这种口外复位方法的优点是:不需要将手指放入患者口内,在无条件洗手的情况下也能进行,不需要太大的按压力量,不需要助手的帮忙,在坐、站、卧任何体位的情况下都能进行复位。不仅医务工作者容易掌握这一方法,习惯性脱白者亲属也能掌握。
我把这段文字抄到了自己的本子上,并决定在下次脱臼的时候尝试。下次脱臼到来时,我惊喜地发现这是可行的(尽管很痛,会痛到流泪的程度)。至少我现在有了个有效的自救手段。
高三某个晚自习的课间,我打了个哈欠,然后脱臼又发生了。但这次伴随着一个新的突破:当时我刚趴桌睡醒,不知为何决定猛地一仰头,然后关节复位,脱臼消失了!我不太确定这是怎么实现的,可能是加速度让关节冲过了卡点,或者是仰头的操作扩大了移动范围?这个仰头复位的方法,在绝大多数情况下都有效,但是依然有限制:一是必须要在脱臼发生后立刻执行,超过五秒成功率就会大幅下降;二是有的时候不方便仰头(例如落枕了),那就做不到了。
脱臼第一次发生之后,我去看过医生,后面也陆续去过几家不同医院。医生怀疑和我小时候咬合习惯不佳相关(例如只用一侧牙齿咀嚼),但是没有什么好的治疗方式。可以手术,但是风险远高于收益,因此最后还是建议保守治疗,平常自己多注意。家长买过限位头套,但戴着像恐怖分子的造型让我几天后就放弃了。
如今,对我而言脱臼已经变得如此频繁,每天可能发生十几次,医学上称之为"习惯性脱臼"。幸运的是,绝大部分情况下我都能通过仰头自行复位,所以对日常生活的影响比较小。唯一的困扰可能是旁人偶尔会对我突然仰头的动作投来奇怪的目光。那些仰头无法解决的严重情况,我会找个无人的角落,用之前学到的口外复位法自己处理。每次这类无法自动复位的脱臼发生,需要我手动干预时,我会留下记录;前几年的时候情况比较糟糕,大概一个月一次,近期已经有所好转(可能和我拔了智齿相关),大概是每100天会出现一次。
值得庆幸的是,在高考和其他人生重要时刻,这个病都没有给我带来麻烦。现在的我已经完全接受了与它共存的状态,甚至发展出了一套"充电"理论——定期按摩关节区域就像充电,如果等到"电量耗尽",关节就会卡住。
如果你从未听说过这个病,那我衷心祝愿你永远不会有机会了解它。某种程度上说,在现代社会,对疾病知识知道得越少可能意味着越健康?但如果你或身边的人也受此困扰,希望我的经验能提供一些帮助。


