2026-09-28 13:00:00
上一篇 Meta Muse 介绍与注册指南:一个会替你跑腿的个人 AI Agent 把 [[Muse]] 是什么、怎么注册、额度怎么算都整理了一遍,但是留了一个结尾:注册完之后到底该让它干什么。Muse 上线这几周,我查阅了一些测评体验,整理了 X 和 Threads 上用户晒出来的用法,发现大家的使用路径其实很像:从提醒和文件这类零风险的任务开始,确认它靠谱之后再慢慢接入邮箱、日历,最后才让它碰钱。这篇就按这个顺序来整理,从界面和设置讲起,再到具体的案例和踩过的坑。
Muse 的 App 结构不复杂,但几个入口藏得比较深,第一次用很容易找不到自己要的东西。和它对话、布置任务都在 Chat 标签页,它的交互方式就像发消息,你可以连着发好几条,不用等它回复。不知道能让它做什么的时候,可以去 Ideas 标签页看看官方推荐的任务,或者直接问它「你能帮我做什么」。它生成的文件,比如 PDF、表格、仪表盘,都会放到 Library 标签页里。
| 想做的事 | 入口 |
|---|---|
| 对话、布置任务 | Chat 标签页 |
| 找任务灵感 | Ideas 标签页 |
| 查看它生成的文件 | Library 标签页 |
| 提醒和定时任务 | 助手图标 → Upcoming |
| 查看它做过什么 | 助手图标 → Activity log |
| 连接或断开应用 | Settings → Connectors |
| 设置什么时候需要先问你 | Settings → Permissions |
| 导入记忆、关闭训练 | Settings → Data controls |
另外一个很实用的功能是侧边对话(side chat),在 Chat 标签页左上角的菜单里点铅笔图标就能新开一个。它适合把不同主题分开,比如一个专门聊旅行计划,一个专门处理账单。Muse 的记忆是跨对话共享的,所以分开聊并不会让它忘掉你在别处说过的事,只是让每个对话的上下文更干净。
第一步在对话中告诉 Muse 你的名字、时区和偏好,比如「回答尽量简短」「我不吃辣」「周末不要安排工作」,Muse 会把这些存成记忆,之后的任务都会参考。你也可以让它换个名字、换种说话语气,这些都不用去设置里找,直接说就行。
第二步是设置权限,这一步个人认为最重要。在 Settings → Permissions 里,连接器和网页访问都有两档:「Ask for some actions」表示所有会改变东西的操作(发送、购买)以及一部分重要的读取操作要先问你;「Always ask」表示任何操作都先问你。刚开始用的时候建议全部设成 Always ask,虽然会多点几次确认,但你能清楚看到它每一步想干什么,这是建立信任最快的方式。
第三步是只接一个应用,而且先给只读权限。直接说「连接我的 Gmail」,或者去 Settings → Connectors 点 Connect 登录。大多数连接器都可以设成只读,也就是它能看你的数据但不能替你做事。比较稳妥的顺序是先接日历只读,再接邮箱只读,用顺手了再考虑放开写权限。Facebook、Instagram、Threads 只要在同一个账户中心里会自动连上,这一点注意一下,不想让它看的话要手动去断开。
Muse 每次要执行需要确认的操作时,会弹出一张审批卡片,选项有五个:Allow once(只允许这一次)、Allow for this task(这个任务里都允许)、Allow for this site(在这个网站上都允许)、Always allow(这类操作以后都允许)、Deny(拒绝)。每张卡片上还有一个 See task details,点开能看到它具体要做什么,我的建议是初期每次都点开看一眼再决定。
这几个选项里,Always allow 要格外小心。它是按「某个连接器的某一类操作」来放权的,一旦对发邮件、发帖或者付款这类操作点了 Always allow,之后它就不会再来问你了。发出去的邮件是撤不回来的,所以涉及发送和付款的操作,最好一直停留在 Allow once。
Muse 用浏览器干活的时候,你还可以随时介入:Open browser 可以实时看它在网页上的操作,Take control of the browser 会让它暂停,由你接手操作页面,Stop the task 则直接终止任务。遇到登录、验证码或者它明显走错路的时候,自己接手处理完再交还给它,往往比让它反复重试要快得多。
和聊天机器人不同,给 Agent 布置任务更像是给一个新来的助理交代工作。说得越清楚,它来回确认的次数越少,消耗的 token 也越少。综合官方文档和用户的经验,有几个技巧比较管用。
交代清楚背景和标准。不要只说「帮我找个搬家公司」,而是说清楚从哪里搬到哪里、几居室、有没有电梯、希望什么时候搬,以及一个好结果应该长什么样,比如「给我三家报价,按价格排序」。
指定输出格式。你想要表格、列表、PDF 还是一段简短的文字,最好直接说出来。有人反馈说没指定格式时,它经常默认生成一个 Word 文件。
划定边界。比如「只搜索我的邮件,不要看短信」,或者「预算不超过 200 美元」。尤其是填表和预约类任务,在结尾加一句「提交之前停下来给我看」,这句话几乎是所有教程里都会出现的一句。
把持续性任务写成检查,而不是目标。与其说「帮我盯着这件事」,不如说「每天早上检查一次 Gmail,只有对方回复了才告诉我」。前者太模糊,后者它知道该做什么、什么时候该来找你。
直接贴步骤。Muse 目前不能让普通用户安装自己的 Skill 文件,但你可以把一套写好的操作步骤直接贴在任务里,效果差不多。另外,结果不满意就直接纠正,「太长了」「语气随意一点」,它会慢慢记住你的偏好。
下面这些案例按风险从低到高排列,前面几类出错了也没什么损失,适合刚上手时练习,后面几类涉及外部沟通和花钱,建议等你熟悉审批机制之后再尝试。
最简单的起点是定时提醒,比如「每周一早上 9 点提醒我提交工时表」,它会一直重复,直到你取消为止,还支持基于位置的提醒。在此基础上可以升级成定时简报:「每个工作日早上 7 点,给我发一份 5 条要点的行业新闻摘要,并附上来源链接」。Muse 还会主动提醒哪些文章需要付费订阅才能看。所有定时任务都可以在 Upcoming 里查看和管理。
需要注意的是,这些定时任务本质上是在聊天里推送给你的提醒,Muse 目前没有「定时发帖」这类功能,如果要定时发布内容,得接入第三方排程工具作为连接器。
Muse 能读 PDF、DOCX、纯文本、Markdown、XLSX、CSV 和常见图片格式,最常见的用法是丢一份文件过去,说「帮我总结一下,并列出我需要处理的事项」。合同、账单、学校通知这类文件特别适合这样处理。
反过来它也能生成东西,而且因为背后有一台完整的虚拟机,它能生成的东西比聊天机器人丰富得多。比如「做一份一页的 PDF,对比三款适合自由职业者的记账软件」,或者「做一个按类别追踪每月开销的仪表盘」,之后你说「加一行」,它会直接修改同一个文件,而不是重新生成一份。
接入 [[Gmail]] 和日历之后,最直接的问法是「明天日程上有什么,哪些邮件还没回」。Muse 的邮件连接器是按需搜索,不会把你的整个收件箱下载下来,除非你明确要求。日历则是少数会主动推送的连接器,你的日程一有变化,它会自动收到通知。
我们可以让 Muse 从邮件里筛出学校和游泳课的通知,追踪各种截止日期,同步到日历上,家里人随时可以问它最近有什么安排。这类「从一堆邮件里提取结构化信息」的任务,正是 Agent 比人做得又快又不容易漏的地方。
这是目前用户晒单最多的一类,也是最能直观感受到 Agent 价值的地方。一个比较典型的起手式是:「翻一遍我过去 12 个月的 Gmail 收据,列出所有我可能已经不用的定期扣费」,或者「列出我正在付费的所有订阅,写上月费和最后一次使用的时间」。
退款和申诉也很适合交给它。有一些案例是让 Muse 处理 Google Cloud 上一个闲置数据库产生的费用,第一次申请被拒,Muse 起草了跟进邮件之后,39 分钟后 114.14 美元被全额免除。银行手续费减免、保险账单争议也是类似的套路:让它起草申诉,你确认后发送,然后「每周跟进一次,直到对方回复」。
X 上还有人晒出让 Muse 跟宽带公司谈判,把月费从 80 美元砍到 30 美元,或者锁定 5 年优惠价的案例。这些都是用户的自述,没有第三方核实,看看就好,但至少说明这个方向是可行的。
Muse 在 9 月 17 日开放了给美国商家打电话的 Beta 功能,可以帮你预约理发、问店里有没有货、找承包商要报价、订餐厅。打完之后会给你一份通话记录和摘要。Yahoo Finance 的评测者让它帮忙找搬家公司报价,Muse 问清楚了新旧地址、几居室、有没有楼梯或电梯,然后联系了本地四家公司,大约两分钟后就有两家打电话过来,其中一家当场报了价,另外几家发了邮件。
不过这个功能要多留个心眼。路透社报道,Meta 在内部测试时,有一部分电话其实是外包的人工客服打的,而且测试者事先并不知情,其中一次谈宽带账单的通话里,外包人员还说了带种族歧视的话。Meta 事后承认没有提前说明是个失误,已经暂时撤回了人工代打,并表示会在有明确告知的前提下再推出。另外也有用户反映电话打不通,或者商家一听是 AI 就挂断。所以电话里涉及的个人信息,尽量控制在完成任务所需的最少范围。
预约类任务是 Muse 宣传里的主打场景。Yahoo Finance 的评测者给了几个约会的大致想法,Muse 给出四个方案,他选了一个,通过 [[OpenTable]] 直接订好了位子。另一位用户让它在 [[Zocdoc]] 上找医保网络内的家庭医生,网上预约不可用时,它把事情转交给用户,第二天又主动提醒,直到预约完成。
购物的体验则更复杂一些。同一位评测者让 Muse 在任天堂官网买一款 Switch 2 游戏,它每一步都会告诉你在做什么,需要登录时把账号密码存进它自己读不到的安全存储,最后列出总价,把下单按钮留给你来按。整体很顺畅,但花的时间明显比自己去官网买要长。付款默认走 Link by [[Stripe]],每次生成一次性虚拟卡。现在 [[Shopify]] 已经开放了整个商品目录给 Muse,Walmart、Best Buy、Sephora 等也在陆续接入,但 Amazon 已经屏蔽了 Muse,Target 等网站在结账环节也会拦截自动点击。这位评测者的看法是,Muse 最适合一次性采购很多不同的东西,比如办派对或者搬家,单买一件东西自己动手反而更快。
Muse 能在你关掉 App 之后继续工作,所以它很适合处理需要持续一段时间的事情。比如「我的目标是在 11 月前上线一个月更的邮件通讯」,它会拆出一份计划,每周来跟你确认一次进度。Yahoo Finance 的评测者则让它接入 Yahoo 梦幻橄榄球账号,找出预测得分最高的防守组,提交了堪萨斯城酋长队的 waiver 申请,第二天申请通过后,它自动把酋长队排进了首发阵容。
这类任务建议放在最后尝试,因为它意味着你要让 Muse 在很长一段时间里、在你不盯着的时候自主行动,前提是你对它的审批边界已经心里有数。
9 月 18 日上线的 Mac 版能直接操作你电脑上的文件和应用,包括 iMessage、备忘录、提醒事项、邮件和日历。官方给的例子是「把上个月的三张发票整理到一个文件夹里」,也可以让它根据电脑里的文件填表,或者汇总当天的邮件、信息和笔记做一份日终总结。
Mac 上的应用不走连接器,而是在 Settings → File System Access 里逐个设置 Off、Read only 或 Read and interact 三档。上一篇提到过,Inc. 的记者就遇到了 Muse 在没有明确授权的情况下同步了他的 Messages 数据库,所以这里我的建议是,默认全关,只给当前任务需要的那一两个应用开只读。好消息是它删除的文件会进废纸篓,误删了还能找回来。
如果你用的服务不在连接器列表里,可以直接让 Muse 自己写一个,前提是那个服务有公开的 API 或命令行工具,凭据会存进安全存储。这对开发者来说挺有吸引力,比如接入自己的记账系统或者 Home Assistant。但要注意,Meta 只对官方连接器做功能、安全和法务审查,你让 Muse 做的自定义连接器是没人审过的,接入前要先看清楚那个服务的条款和它能拿到的权限。
它会编造信息。Yahoo Finance 的评测者问一家餐厅有没有无麸质啤酒,Muse 先给了一个电话号码,接着又换成另一个,追问之下它承认第一个号码是自己编的,没有核实过。它推荐的餐厅里也有一家早就关门了,被指出后它解释说用了「过时的数据」。CNN 的测试也遇到了同样的问题。所以电话、地址、营业时间这类事实性信息,它给出来之后最好自己再确认一遍。
两步验证码要你自己来。Muse 的邮件连接器会过滤掉一次性验证码、重置密码链接和登录链接,这是出于安全考虑,但也意味着遇到需要验证码的网站,得你亲自把验证码输进去,这时候 Take control of the browser 就派上用场了。
断开连接不等于它忘了。断开一个连接器只是不让它获取新数据,它之前已经看到的内容可能还留在记忆和聊天记录里,要彻底清除得明确让它忘掉。如果是手机或 Mac 上的系统级权限,还要去系统设置里一并撤销。
长任务可能会卡住。浏览器任务跑得太长时经常会停住等你帮忙,加上网站的反爬拦截,有时候一件事来回折腾半天。遇到这种情况,与其反复让它重试消耗 token,不如自己接手把卡住的那一步做完。
提示词注入还没有解决。Meta 自己也承认 Muse 并非对攻击免疫,它在网页上读到的内容里可能藏着恶意指令。Sentinel 能拦下大部分越界操作,但这也是为什么发送和付款最好永远保留人工确认。
Muse 目前最擅长的是那些流程清晰、跨好几个网站或服务、需要持续跟进,但单步又不太难的琐事:翻收据找订阅、追退款、比报价、盯截止日期。这些事情人不是做不了,而是懒得做、容易忘、容易半途而废,而 Agent 恰好不会累也不会忘。反过来,需要精确事实、需要快速完成、或者出错代价很高的事情,它现在还不太靠得住。
我的建议是把它当成一个刚入职的助理来带:先用 Always ask 看它怎么干活,从提醒和文件这类零风险任务开始,一个一个地接入应用、一点一点地放开权限。每次放权之前问自己一句,如果它这一步做错了,我能不能承受。等你摸清了它的能力边界,再把那些真正让你头疼的琐事交给它,这时候它才会真正替你省下时间。
2026-09-25 13:00:00
2026 年 9 月 8 日,[[Meta]] 发布了个人 AI Agent [[Muse]],宣传语只有一句:「它去做,而不是告诉你怎么做」。用 [[ChatGPT]] 或 [[Claude]] 时,我们得到的往往是一份说明书,真正动手的部分,打开网页、填表单、下单付款,还得自己来。Muse 想把这一段也接过去:你交给它的不是一个问题,而是一件事,它会自己打开浏览器一步步做完,需要你拍板时再回来问你。这是 Meta 迄今为止在消费级 AI 上下的最大一笔注,两周后的 Connect 2026 大会几乎整场都围绕它展开。
这篇先简单交代一下背景,再把 Muse 是什么、怎么注册、额度怎么算讲清楚。具体的使用案例和玩法,我会另外写一篇教程。
| 今年个人 AI 助手这股风,是 [[OpenClaw]] 带起来的。这个由 Peter Steinberger 做的开源项目在 1 月底爆红,它常驻在你自己的机器上,有长期记忆,能接入 WhatsApp、Telegram 这些聊天工具,替你操作浏览器和文件。很多人第一次意识到,AI 可以是一个一直在线、会主动做事的助手。不过它的门槛也不低,得自己准备机器、配模型、管权限,Steinberger 自己都说它不是给非技术用户用的。我之前也写过一个 [[OpenClaw 篇一:开源 AI 代理介绍及安装 | OpenClaw 系列]]。 |
Meta 也看中了这个方向。2025 年底它宣布以约 20 亿美元收购通用 Agent 公司 [[Manus]],结果中国监管部门介入审查,2026 年 4 月直接叫停交易并要求撤销,Manus 在 8 月宣布恢复独立。收购没成,Meta 最后拿出来的是自研的 Muse。Meta 超级智能实验室的产品负责人 Nat Friedman 也公开承认,Muse 在产品上「大量借鉴了 OpenClaw」,只是代码从零写起。
所以可以把 Muse 理解成面向普通人的 OpenClaw:搭机器、配模型、管权限这些麻烦事都收进了 Meta 的云端,代价是你得信任 Meta。
Muse 是 Meta 推出的个人 AI Agent,背后的模型是 Meta 自家的多模态模型 Muse Spark。它和聊天机器人最根本的差别,在于它背后跑着一台真实的机器。
每个用户都会分到一台 Muse Secure VM,也就是一台独立的云端 Linux 虚拟机,里面有完整的浏览器和文件系统,Agent 和你授权给它的数据都放在这台机器上。Meta 官方没有公布具体配置,用户和媒体实测的结果大致是 2 个 vCPU、8GB 内存、跑 Ubuntu,磁盘容量的说法从 8GB 到 100GB 不等,而且付费版和免费版分到的机器看起来是一样的。
你可以交给它各种琐事,比如取消一张信用卡的年费、盯着演唱会票价降到某个数字就买、把 Instagram 上收藏的食谱拆成一张采购清单。它会自己拟订计划,打开网页、读页面、点按钮、填表单,遇到需要你拍板的地方停下来问你。你把 App 关掉它也还在跑,做完或者需要你确认时再回来找你。
安全方面有几个设计值得知道:
Meta 还预告了一个 Confidential VM,整台虚拟机用只有用户自己持有的密钥加密,连 Meta 都进不去。但它要到 2026 年晚些时候才推出,现阶段的 Secure VM 只是把你和其他用户隔开,并不阻止 Meta 在运营服务时访问你的数据。
Muse 目前可以通过这几个入口使用:
9 月 23 日的 Connect 2026 上,Meta 还公布了一批后续计划:在智能眼镜上用唤醒词呼叫 Muse、给 Muse 一个可以视频对话的虚拟形象、给它一个独立邮箱地址,以及一个叫 Muse Charm 的钥匙扣大小的随身设备,计划 12 月出货,价格还没公布。这些大多只给了「即将推出」「未来几个月」这样的时间,暂时不要当成现在就能用的功能。
App 上线后势头很猛,9 月 18 日登上美区 App Store 免费榜第一,第二天也登顶了 Google Play,Sensor Tower 估计到 9 月下旬下载量已经超过 340 万。
在动手注册之前,先确认自己满足这几个条件:
关于地区限制多说一句:网上有不少教你用 VPN 或云桌面绕过去的文章,但 Muse 的地区判断是在账号层面做的,不只看 IP,再加上支付卡和应用商店的地区,基本是三道检查。强行绕过有可能连累你的 Meta 账号,而宣称有「内部渠道」能提前开通的,基本可以当成骗局。邀请码也只能给额外额度,没法帮你跳过地区限制。
满足条件的话,注册流程并不复杂:
Muse 的邀请机制是这样的:新用户在注册后兑换别人的邀请码,邀请人和被邀请人各得 10 亿 Muse token。这部分奖励额度在账户里显示为永不过期,按免费版每周约 1 亿的额度算,相当于多出 10 周左右的用量。它是使用额度,不能提现,也不能转让。
有两个限制要注意:
如果你打算试,可以用我的码:TOCKLC
注册地址:https://muse.ai/join
完成引导之后进 Settings → General → Redeem Invite Code 输入 TOCKLC,兑换成功后我们各得 10 亿 token,可以在额度页确认是否到账。顺便提醒一句,搜「Muse 邀请码」会跳出一堆专门做邀请码农场的站点,码的有效性没人保证,用认识的人给的码会稳妥一些。
Muse 的计费单位叫 Muse token,按周计算额度,每周重置,没用完的不会累积到下周。目前的方案如下:
| 方案 | 价格 | 每周额度 |
|---|---|---|
| Free | 免费 | 约 1 亿 token |
| Power | 20 美元 / 月 | 5 亿 token |
| Maximum | 100 美元 / 月 | 30 亿 token |
几个细节:
1 亿 token 到底能干多少事?Meta 没有公布单个任务大概要花多少 token,Agent 读网页、截图、规划、调用工具都在消耗,所以很难换算成「能订几张机票」。能参考的是 Gizmodo 记者的测试:他让 Muse 连续做了横版过关游戏、带关卡的射击游戏、一个网站、50 段配乐变奏和 50 段动画,这时只用掉周额度的 6% 左右,再加上一个仿 Mac 桌面的大项目,也才到 11%。这些都是很吃算力的生成类任务,日常的查资料、比价、填表单只会少得多。
所以结论比较清楚:大多数人用免费版就够了,再加上邀请码的 10 亿,短期内基本不用考虑付费。
顺带一提,Meta 敢给这么多免费额度,是因为 Zuckerberg 在 Connect 上说得很明白,他们打算从 Muse 促成的交易里抽一小笔手续费。它的商业模式不是订阅费,而是它替你花出去的钱。想明白这一点,对它推荐的商品和商家保持一点警惕是应该的。
注册完不急着让它去做事,建议先花几分钟把权限理一遍:
Meta 声明 Muse 的对话和虚拟机里的数据不会进入广告系统。但要注意,你通过 Muse 浏览和购物的行为,仍然可能通过常规的网页追踪间接影响你看到的广告。
我自己的做法是先用一个干净的账号试水,暂时不接入主邮箱和任何有支付能力的账户。这么谨慎是有原因的:Inc. 的记者 Jason Aten 反馈,他明确没有给 Muse 授权读取信息,Mac 版的 Muse 却同步了他的 Messages 数据库,主动根据他和朋友的聊天建议他写专栏,被问到时还给出了和实际情况不符的解释。TechRadar 的测试者也提到,使用过程中会不断被提示去连接金融账户、邮件、文档和身份信息。Mac 版能直接读本机数据,授权时尤其要看清楚。
在决定要不要花时间研究之前,这几个短板也应该知道:
另一方面,Connect 上公布的合作名单在变长,Shopify、Walmart、Best Buy、Sephora、Expedia、Notion、GitHub 等都在其中,Meta 还开放了第三方开发者接入。能用的服务会越来越多,但现在还是偏少。
Muse 让我在意的不是它现在能做什么,老实说以它目前的速度和被网站封堵的程度,很多任务自己动手更快。真正的变化在于交互方式:过去两年我们学的是怎么写更好的 prompt,Agent 时代要学的是怎么安全地授权,判断哪些事可以交出去、哪些事必须自己按下最后一个按钮。
如果你在美国或加拿大,注册成本很低,免费额度加上邀请码的 10 亿 token 足够玩很久,值得试一下。先从查资料、比价、整理清单这类出错了也无所谓的任务开始,把主邮箱和支付账户留在外面,等 Confidential VM 上线、长期使用的反馈多起来再说。
Muse 的具体使用案例和上手方法,我整理在了下一篇 Meta Muse 使用教程:上手设置、提示词技巧与实用案例 里。
2026-09-20 13:00:00
过去一两年,大模型的发展方向几乎都是更长的思考链、更大的上下文、更强的 Agent 能力。但在日常写代码和搭建自动化流程的过程中,我发现很多地方用到大模型,其实只是为了让它做一个简单的判断,却要付出几秒钟的等待和解析 JSON 的麻烦。TypeSafe AI 发布的 Jev 走了一条相反的路:不聊天、不写代码,只做快速的判断。
Jev 是 [[TypeSafe AI]] 在 2026 年 9 月 15 日以抢先体验(early access)形式发布的第一个公开模型,也是官方提出的第一个 System One 模型。Jev 不生成文字,而是做判断:输入一段非结构化的上下文,加上事先定义好的问题和可选答案,Jev 直接返回带概率的结构化结果,代码可以拿来直接做分支、排序或路由。
官方对它的定位是一句话:
Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out.
也就是说,Jev 更像一个「带智能的函数调用」,而不是聊天机器人。
传统的 LLM 的主要能力是和人聊天,以及在 Coding Agent 上生成代码。但在真实的软件和自动化流程里,很多环节并不需要一段文字,而只需要一个决定:这封邮件是否紧急、这个工单交给哪个部门、这条评论是否违规。用 LLM 来做这些事,通常要写 Prompt、等模型逐字生成、再解析输出,速度慢、成本高,还可能遇到格式错误。Jev 就是为这类场景设计的,官方把它称为「smart if-statements」,即可以嵌进普通代码里的智能判断规则。
官方把 Jev 模型称为 System One 模型,灵感来自 [[Daniel Kahneman]] 的《[[思考,快与慢]]》。
系统一是人类大脑中负责快速直觉判断的部分,系统二是负责缓慢、深度推理的部分。现在的大语言模型通过思维链等方式,越来越往系统二的方向发展;Jev 则反过来,专注于系统一,即「一个知识丰富的人在几秒钟之内就能做出的判断」。书中认为系统一容易出错,TypeSafe 的观点是,这类模型可以被训练得比其他方案更可靠。
需要注意的是,「不会幻觉」指的是答案的格式永远正确,并不代表判断一定正确。模型仍然可能在 3 个选项中很自信地选错。
Jev 这个名字来自英国经济学家 [[William Stanley Jevons]],也就是「[[杰文斯悖论]]」的提出者。杰文斯悖论指的是,当一种资源的利用效率提升、使用成本下降之后,它的总消耗量反而会增加。蒸汽机效率提升之后,煤炭的消耗不降反升。TypeSafe 认为机器智能也会走同样的路:当判断变得足够便宜和快速,软件中使用 AI 的地方会成倍增加。
TypeSafe AI 的创始人是 Diogo Almeida,他曾在 [[OpenAI]] 参与指令遵循方向的研究,这些工作后来成为 [[ChatGPT]] 背后的研究基础(InstructGPT / RLHF)。公司在隐身状态下研发了 2 年才对外发布产品,据媒体报道,公司由 DCVC 领投完成了 4000 万美元融资。
以下数据来自 TypeSafe 官方:
在我们的自动化流程当中,有大量这样的判断,比如这个任务要交给哪个模型处理、这封邮件是否紧急、这个工单要转给哪个部门。过去这些判断要么写成固定的规则,要么交给 LLM,前者不够灵活,后者又慢又贵,Jev 正好填补了两者之间的空白。
官方把 Jev 的用途归为 4 类:
官方文档中还有 20 多个 Cookbook 示例,比较有代表性的有:
从这些例子可以看出,Jev 并不是要取代 LLM,而是和 LLM 配合使用:LLM 负责生成和复杂推理,Jev 负责其中大量快速、便宜的判断。
Jev 的调用依赖两个部分:
然后 Jev 就能直接返回结构化的答案。
一次请求可以同时包含多个问题,每个问题都会针对同一个 state 并行、独立地进行判断,所以多加几个问题几乎不会增加响应时间,问题之间也不会互相干扰,不会出现 LLM 上下文越长效果越差的「上下文腐烂」问题。
Jev 支持 3 种问题类型:
3 种问题可以在同一次 API 调用中混合使用。
官方 Quick Start 中的例子,用一条客服工单同时问了 3 个问题:交给哪个部门处理、用户有多不满、是否紧急。
{
  "model": "jev-latest",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
返回结果:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": {"technical": 0.85, "sales": 0.0, "billing": 0.15}
    },
    "frustration": {
      "type": "score",
      "score": 1.0,
      "confidence": 1.0,
      "legend": {
        "0": "Calm, just stating facts",
        "1": "Frustrated but civil",
        "2": "Very angry, strong language"
      },
      "probabilities": {"0": 0.0, "1": 1.0, "2": 0.0}
    },
    "is_urgent": {"type": "noul", "noul": 1.0}
  },
  "usage": {"input_tokens": 392, "output_tokens": 65}
}
department 判断为 technical(概率 0.85,置信度 0.78),frustration 评分为 1.0,即「Frustrated but civil」,is_urgent 为 1.0。model 字段返回的是实际使用的版本号,这次请求消耗了 392 个输入 Token,而输出 Token 是免费的。
也可以使用官方的 Python SDK(需要 Python 3.10 及以上版本):
pip install typesafe-sdk
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

# 默认从环境变量 TYPESAFE_API_KEY 读取 API Key,默认模型为 jev-latest
client = TypeSafeClient()

ticket = "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP."

response = client.system_one(
    state=ticket,
    questions={
        "department": Choice(
            instructions="Which team should handle this",
            criteria={
                "billing": "Payment or subscription issues",
                "technical": "Bugs or integration problems",
                "sales": "Pricing or account questions",
            },
        ),
        "frustration": Score(
            instructions="How frustrated the customer appears",
            criteria=[
                "Calm, just stating facts",
                "Frustrated but civil",
                "Very angry, strong language",
            ],
        ),
        "is_urgent": Noul(
            instructions="The message conveys urgency or time-sensitivity",
        ),
    },
)

print(response.answers["department"].choice)  # "technical"
print(response.answers["frustration"].score)  # 1.0
print(response.answers["is_urgent"].noul)     # 1.0
Noul 用来回答一个「是或否」的问题,或者判断一句陈述是否成立,比如「这条消息是否在申请退款」「这份简历是否有 Python 经验」。
请求参数:
type:固定为 noul
instructions:要判断的问题或陈述criteria:可选,用 true 和 false 两个字段分别描述什么情况算「是」、什么情况算「否」返回结果只有一个 0 到 1 之间的数字 noul,表示答案为「是」的概率,0 表示否,1 表示是。因为一个数字已经同时描述了两种结果,所以 Noul 没有单独的 confidence 字段。
{"type": "noul", "noul": 0.99}
使用建议:
instructions 也可以传入对象,比如把一条待比对的数据库记录和问题一起传进去,一次请求就能用多个 Noul 把一份简历和多条记录做查重。
Choice 让 Jev 从一组事先定义好的选项中选出一个,适合分类和路由,比如工单分配给哪个部门、商品属于哪个类目、代码是哪种编程语言。Choice 是单选,不支持多选。
请求参数:
type:固定为 choice
instructions:问题本身criteria:选项名到选项描述的映射,模型会同时看到选项名和描述;如果选项名本身已经足够清楚(比如 calm、frustrated、angry),描述可以为 null
一个问题最多可以有 255 个选项,每多一个选项只多消耗几个 Token。
返回结果包含 3 个字段:
choice:概率最高的选项probabilities:所有选项的概率分布,加起来等于 1confidence:0 到 1 之间,根据概率分布的形状计算,只有一个明显的峰值时置信度高,概率分散在多个选项上时置信度低{
"type": "choice",
"choice": "returns",
"confidence": 1.0,
"probabilities": {"returns": 1.0, "shipping": 0.0, "billing": 0.0}
}
官方举了一个含糊的例子:一张工单同时提到了配送延迟、尺码不对和重复扣款,这时 department 在 returns(0.61)和 billing(0.35)之间摇摆,置信度只有 0.42。代码可以根据这些数字做进一步处理:
使用建议:
other 或「以上都不是」的兜底选项,否则模型只能在不合适的选项里硬选一个what、not_for、examples 等字段的对象Score 让 Jev 在一个有顺序的等级上给出评分,比如 Bug 的严重程度、用户的不满程度、候选人的经验水平。和 Choice 的区别在于,Score 的选项有高低顺序,结果可以落在两个等级之间。
请求参数:
type:固定为 score
instructions:问题本身criteria:按从低到高排列的等级描述,至少 2 个、最多 10 个,按顺序从 0 开始编号返回结果:
probabilities:每个等级的概率,加起来等于 1score:每个等级编号乘以对应概率后求和,得到的加权平均值legend:等级编号和描述的对应关系confidence:概率越集中在一个等级上,置信度越高以官方的 Bug 严重程度为例,3 个等级分别是「只影响外观」「功能受损但有替代方案」「阻塞且没有替代方案」,返回的概率分别是 0、0.57、0.43,所以 score 为 0×0 + 1×0.57 + 2×0.43 = 1.43,置信度 0.35。
{
  "type": "score",
  "score": 1.43,
  "confidence": 0.35,
  "probabilities": {"0": 0.0, "1": 0.57, "2": 0.43}
}
置信度偏低通常有 3 个原因:等级之间在这个内容上有重叠;一个问题同时在衡量多件事;内容本身没有提供足够的信息。
使用建议:
["0","1","2"] 作为等级时,一个按钮错位的问题得到 0.55 分、置信度 0.33;换成文字描述之后得到 0 分、置信度 1.0what、examples 字段的对象,补充一个相关的例子能明显提升置信度多个 Score 可以组合成一个综合评分:先把每个 score 除以最高等级编号(len(criteria) - 1)归一化到 0 到 1,再在代码中加权求和,官方称之为 Composite scoring 模式。这样当业务优先级变化时,只需要调整代码里的权重系数,而不用重写 Prompt。
| 类型 | 适用场景 | 选项特点 | 返回值 |
|---|---|---|---|
| Noul | 是否判断、规则检查、守门 | 只有是和否 | 为「是」的概率 |
| Choice | 分类、路由、打标签 | 多个选项,没有顺序 | 选中项、概率分布、置信度 |
| Score | 打分、分级、排序 | 多个等级,有高低顺序 | 加权分数、概率分布、置信度 |
复杂的判断不要塞进一个问题里。比如不要直接问「给这个创业项目打分」,而是拆成市场规模、技术可行性、差异化等多个独立的问题,再在代码里组合结果。这也是 Jev 和 LLM 使用思路上最大的不同:LLM 把逻辑写在 Prompt 里,Jev 把逻辑留在代码里。
直接在官网 Playground 中在线体验,或者创建 API Key,并编写代码使用。
每个新注册的账号,添加支付方式之后拥有 5 美元的体验额度。按照每百万输入 Token 0.042 美元计算,5 美元大约可以处理 1.19 亿个输入 Token,以 Quick Start 中那个 392 Token 的请求为例,可以调用约 30 万次,用来测试完全足够。
官方文档提供了 4 种上手方式,可以按照自己的习惯选择。
不写代码的话,最快的方式是 Playground:
Playground 适合在正式写代码之前,先验证问题的措辞和选项的描述是否合适。
在控制台的 API Keys 页面 创建 API Key,然后用任意语言发送 POST 请求即可:
export TYPESAFE_API_KEY="your-api-key"

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "state": "Hi, I have been trying to connect my Stripe account for 3 days and the integration keeps failing. Please help ASAP.",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }'
可以通过 GET https://api.typesafe.ai/v1/models 查看当前账号可以使用的模型。目前可用的模型是 jev-1.13.0,另外有两个别名:
jev-latest:最新的正式版本,也是 SDK 的默认值jev-preview:最新的预览版本,目前和 jev-latest 指向同一个模型别名会随着新版本发布而变化,模型的判断结果也可能随之改变。如果已经针对某个版本调好了置信度阈值,建议在生产环境中固定使用具体的版本号,比如 jev-1.13.0,再按照自己的节奏升级。每次响应中的 model 字段会返回实际使用的版本号,可以记录到日志中。
官方提供了 Python 和 JavaScript/TypeScript 两个 SDK。
# Python,需要 Python 3.10 及以上
pip install typesafe-sdk
# 或者
uv add typesafe-sdk

# JavaScript / TypeScript
npm install @typesafe-ai/sdk
两个 SDK 都会自动从环境变量 TYPESAFE_API_KEY 读取 API Key,默认使用 jev-latest 模型。Python SDK 同时提供同步的 TypeSafeClient 和异步的 AsyncTypeSafeClient,并且内置了重试机制,遇到限流时会按照 retry-after 自动退避重试。具体的调用方式见上文的请求示例。
TypeSafe 还提供了一个 Agent Skill,可以让 [[Claude Code]]、[[Codex]] 等 Coding Agent 了解 Jev 的 API、3 种问题类型和常见的架构模式,从而生成正确的集成代码。
Skill 的源码托管在 GitHub 的 typesafe-ai/skills 仓库中,核心文件是 skills/typesafe-ai/SKILL.md。下面 3 种安装方式任选其一即可,同时使用多种方式会装出重复的副本。
在 Claude Code 中,以插件的形式安装,先添加插件市场,再安装插件:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
在 Codex、Cursor 等其他 Agent 中,使用 skills.sh 的命令行工具安装,执行后会提示选择要安装到哪个 Agent:
# 默认安装到当前项目
npx skills add typesafe-ai/skills --skill typesafe-ai

# 加上 -g 安装到全局,所有项目都可以使用
npx skills add typesafe-ai/skills --skill typesafe-ai -g
也可以手动安装,把仓库中整个 skills/typesafe-ai 目录(包括其中的参考文件)复制到 Agent 的 skills 目录中,以 Claude Code 为例:
git clone https://github.com/typesafe-ai/skills.git /tmp/typesafe-skills
cp -r /tmp/typesafe-skills/skills/typesafe-ai ~/.claude/skills/
如果懒得自己敲命令,还可以把下面这段话直接发给 Coding Agent,让它自己完成安装:
Install the TypeSafe skill. If you're in Claude Code, run `claude plugin marketplace add typesafe-ai/skills`, then `claude plugin install typesafe@typesafe-ai`. If you're in another agent, run `npx skills add typesafe-ai/skills --skill typesafe-ai` and select your agent. Use one installation method. You can read the skill directly at https://github.com/typesafe-ai/skills/blob/main/skills/typesafe-ai/SKILL.md (raw: https://raw.githubusercontent.com/typesafe-ai/skills/main/skills/typesafe-ai/SKILL.md). Then use the TypeSafe skill when working on this project.
TypeSafe 的 API 还在快速迭代,Skill 版本过旧时,Agent 可能会编造出不存在的请求或响应字段,所以需要定期更新。
Claude Code 插件的更新命令:
claude plugin marketplace update typesafe-ai
claude plugin update typesafe@typesafe-ai
更新之后重启 Claude Code,或者在会话中执行 /reload-plugins 重新加载。也可以在 /plugin 菜单中依次选择 Marketplaces → typesafe-ai → Enable auto-update 开启自动更新。
通过 skills.sh 安装的,执行:
npx skills update
手动安装的,用 GitHub 上最新的 skills/typesafe-ai 目录整个替换掉旧目录即可。
安装之后,在 Claude Code 中可以直接输入斜杠命令调用:
/typesafe:typesafe-ai
在其他 Agent 中,或者 Agent 没有自动加载 Skill 时,在提示词中明确写上「use the TypeSafe skill」即可。如果仍然没有生效,检查安装时选择的是否是当前使用的 Agent,然后重启 Agent。
官方给出了几个可以直接使用的提示词。
找出项目中适合使用 Jev 的地方,让 Agent 扫描现有项目,寻找可以用智能判断代替复杂解析逻辑或脆弱代码的位置:
Using the TypeSafe skill, explore the project and find opportunities for using
intelligent judgement to stand in for complex parsing or other fragile code.
让 Agent 用真实的 API 做实验。先把 API Key 导出到环境变量,Agent 会自己发送一些低成本的测试请求,再根据结果给出修改方案:
export TYPESAFE_API_KEY="your-api-key"
Using the TypeSafe skill, run some experiments using the TypeSafe API key that I've
exported to `TYPESAFE_API_KEY`. Propose changes based on the most promising results.
对照官方 Cookbook 重构代码,让 Agent 检查现有代码是否有可以套用的官方示例:
Using the TypeSafe skill, analyze my code and see if there are any applicable
cookbooks (https://console.typesafe.ai/docs/cookbooks) that show how I could
refactor my code to be less fragile or complex.
从零开始写一个小工具,比如一个从多个维度评估文档的命令行程序:
Let's build a simple CLI that uses the TypeSafe API to evaluate a set of supplied
documents on multiple dimensions. Use the TypeSafe skill to understand how to use
the TypeSafe API and how to structure the system. Ask me questions about what kinds
of documents I want to evaluate and on what dimensions.
需要注意的是,Jev 本身并不能作为 Coding Agent 背后的模型。它不能写代码、不能对话、也不能调用工具,不存在把 Claude Code 的模型换成 jev-latest 这种用法。正确的思路是继续用 LLM 写代码,而在写出来的程序里调用 Jev 做判断。
官方还给了几条使用建议:把所有问题和阈值常量集中放在一个文件里,方便人工审查;Agent 并不擅长写问题,问题的措辞最好自己参与修改;不要轻易相信 Agent 的判断,让它用真实请求去验证假设。
和 LLM 模型一样,Jev 也一样会犯错。官方在文档中专门列出了当前版本 jev-1.13 已知的「锯齿」(jaggedness),也就是那些它做得不好的地方,并说明其中很多会在后续版本中改进。
Jev 的能力有明确的边界,不能生成文字,不能做数学推理,也无法比较日期。总的来说,Jev 擅长常识性的语义判断,但不擅长需要多步推理、数字精度的任务,而且对问题的理解非常字面化。
| 场景 | 表现 | 建议做法 |
|---|---|---|
| 数学和计数 | 算不准、数不清,看不懂十六进制颜色、RGB 这类数字表示,Score 的分数也不能用来插值出精确数值 | 计算和计数放在代码里 |
| 日期比较 | 把日期当文本,判断先后、间隔、是否在区间内都不可靠 | 用 Choice 提取年月日,在代码中比较 |
| 间接推理 | 双重否定、多跳推理时准确率下降 | 问题写得直接,在 state 中用字段名指明看哪里 |
| 无关上下文过多 | 无关内容成为干扰项,越多越不准 | 先在代码中过滤,只传问题需要的字段 |
| 对抗性内容 | 注入的指令、误导性表述会影响结果,同样存在 [[Prompt Injection]] 风险 | 写清 criteria,上线前测试边界情况 |
| 问题与描述矛盾 | instructions 和 criteria 意思不一致时判断混乱 | 让两者的表述保持一致 |
| 问题之间的换算 | 同一问题的正反两种问法,概率相加不等于 1(官方示例 0.72 + 0.47 = 1.19),Noul 和 Choice 的数值也不能互相比较 | 不依赖问题之间的数学关系,阈值不跨类型复用 |
| 生成文本 | 效果差且很慢 | 用正则或 LLM 找出候选项,让 Jev 从中选择 |
429 Too Many Requests。由于需求量很大,官方表示这个限制随时可能动态调整,更高的额度需要联系销售购买企业方案还有两点值得注意。
第一,「校准」是统计意义上的。Jev 返回的概率在大量预测上是准确的,比如所有 0.8 的判断里大约 80% 是对的,但这并不保证某一个具体的答案是正确的。同样,高置信度也不等于答案正确。
第二,目前公开的速度、成本和准确率数据主要来自 TypeSafe 官方,演示也多是在模拟环境中完成的,还缺少公开基准测试的成绩和大规模生产环境的验证。
官方文档最后总结了 4 条应该避免的做法:
总结下来,使用 Jev 的正确姿势是:把确定性的逻辑(计算、比较、计数、流程)留在代码里,只把「一个懂行的人几秒钟就能做出的判断」交给 Jev,再通过置信度决定是否自动执行,或者交给人工、交给更强的推理模型处理。
2026-09-07 13:00:00
同时使用 Claude Code,Codex,Pi,OpenClaw 等等 Agent 工具时有一个非常尴尬的状况,就是不同的 Agent 工具维护了不同的配置格式,如果要配置 MCP server 就需要分别到不同的配置文件中定义,相同的配置散落在系统的各个角落中。同一份 API Key 也需要重复粘贴到不同的配置中,更麻烦的是如果一旦有更新或者 API Key 变动就需要重复修改多个地方,我之前还调查过如何[[跨平台管理 MCP]],主要的思路还是通过脚本和同步来对齐配置,但本质上还是在管理多个副本,直到我看到了 Executor 这个项目。
Executor 项目的目的是为了简化各个 Agent 配置,在 Agent 和外部 API 之间做一层代理。集成只加一次,凭据只给一次,权限策略只设一次,然后所有 MCP 兼容的客户端都指向这一层,共享同一个工具目录。项目地址的作者是 Rhys Sullivan,之前在 Vercel、Microsoft、Epic Games 待过。
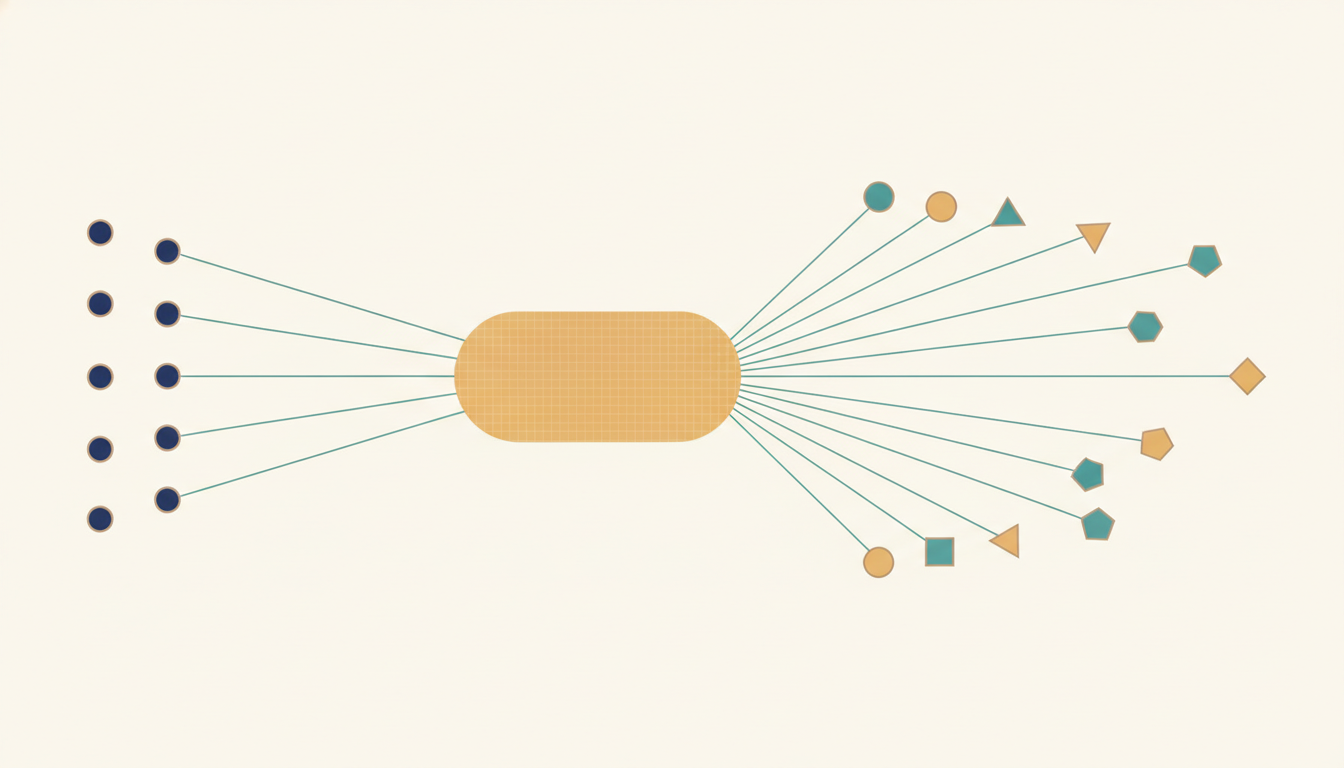
先说清楚 Executor 不是什么。它不是又一个 MCP server,也不是某个特定服务的封装。它的定位是集成层,或者说 MCP 网关,README 里的原话是 “The missing integration layer for AI agents”。
今天 agent 生态的现状是:每个客户端都是一座孤岛。你在 Claude Code 里接了 Linear 的 MCP server,Cursor 想用就得再接一遍;你给某个 agent 配了公司内部 API 的 token,另一个 agent 想调同一个接口,你得再找一遍那个 token 存在哪。这套模式在只有一个 agent 的时候完全没问题,但当你手上同时跑着桌面客户端、终端 CLI、云端 agent 的时候,配置的重复度和凭据的扩散范围就开始失控了。
更深一层的问题是权限。MCP 协议本身没有定义工具级别的授权模型,一个 MCP server 暴露出来的所有工具,对客户端来说要么全都能调,要么整个 server 不接。你没有办法说”这个 server 的读操作随便调,写操作必须先问我”。实际使用中这个粒度是不够的,尤其当 agent 有能力调用会产生真实副作用的接口时。
Executor 把这三件事——集成定义、凭据存储、权限策略——从客户端里抽出来,放到一个独立的服务里,然后通过 MCP 协议统一暴露出去。
Executor 的设计很简单,只有三个概念:
Integration 是集成本身,也就是你想接入的东西的定义。Executor 支持 MCP server、OpenAPI 规范、GraphQL 接口,以及 Google Discovery。README 里有一句话我觉得概括得很好:只要能用 JSON Schema 描述,它就能成为一个 integration。这也意味着接入方式非常直接,你有一份 OpenAPI 的 YAML 或者 JSON,扔进去就完事了,不需要为它单独写一个 MCP server 的包装层。这一点其实很关键,因为现实中大量内部服务都有 OpenAPI 文档,但几乎没有人会为它专门写 MCP server。
Connection 是集成的一个已配置实例。这里的设计有点意思:integration 和 connection 是一对多的。同一个 GitHub 的 OpenAPI 定义,你可以建三个 connection,分别用不同账号的 token;同一个内部 API,你可以建 staging 和 production 两个 connection,指向不同的 baseUrl。凭据是挂在 connection 上的,而不是挂在 integration 上。
Policy 是每个工具的权限级别,一共三档:allow 直接放行,require approval 调用时暂停等人工批准,block 完全禁止。关键在于默认值不是手工一个个点出来的,而是从规范里推导的。文档给的例子是 OpenAPI:GET 这类只读操作默认允许,写操作可以设成需要批准。这个默认值的推导逻辑很实用,因为一份稍具规模的 OpenAPI 文档动辄上百个 endpoint,指望人工逐个设策略是不现实的,能按 HTTP 方法自动分出安全和危险两档,剩下的手工微调量就小得多了。
Executor 对外的形态就是一个 MCP endpoint。agent 说 MCP,Executor 在后面把请求路由到具体的集成上:对上游 MCP server 说 MCP,对 OpenAPI 和 GraphQL 说 HTTP,然后把结果原路返回。
这个代理结构带来的第一个好处是配置的解耦。因为客户端只认识 Executor 这一个端点,你在 Executor 里增删改上游服务,客户端完全不需要动。加了一个新集成,agent 那边自动就能看到新工具,不需要重启、不需要改配置文件、不需要在 5 个客户端里重复这个动作。这一点对我来说是最直接的收益,我加一个内部 API,Claude Code 和 Cursor 同时就有了。
第二个好处更重要,是凭据的隔离。文档里的说法是 credentials stay out,凭据存在 Executor 持有的 connection 上,在实际发起上游调用的那一刻才附加到请求里。agent 从头到尾看不到 token,也就不存在 token 意外进入模型上下文、被写进日志、或者被 prompt injection 套出来的风险。如果你的 agent 跑在沙箱里,或者是一个你不完全信任的第三方客户端,这个隔离是有实际意义的。
第三是策略在每次调用时统一执行。不管请求从哪个 agent 来,走的都是同一套 policy 判断。你不需要在每个客户端里分别配一遍权限,也不会出现某个客户端漏配导致权限失控的情况。新接入的上游服务自动继承同一套策略机制。
需要提醒一点,大部分 MCP 客户端只在启动时加载 server 列表,所以第一次把 Executor 接进去之后,通常需要重启客户端或者开一个新会话,工具才会出现。这个坑文档里明确提到了,我也确实踩了一次,以为是配置写错了。
Executor 提供了 4 种运行形态,功能完全一致,区别只在打包方式。
本地 CLI 是最轻的方式,npm install -g executor 装上,然后 executor install 把它注册成常驻后台服务,executor web 打开网页控制台。这个后台服务会跨重启保持运行,如果你只想临时跑一下不留痕迹,用 executor web --foreground 起一个前台进程就行。默认监听 127.0.0.1:4788,端口被占用时会自动挑一个空闲端口。需要 Node.js 20 以上。
桌面应用是同一个运行时套了个原生壳,Mac、Windows、Linux 都有,适合日常桌面环境;CLI 更适合无头服务器。
Executor Cloud 是官方托管版本,有免费额度,什么都不用装,直接登录、加集成、把 agent 指向托管端点。如果你用的是云端 agent,这条路是唯一能走通的,因为云端 agent 连不到你本机的 127.0.0.1。
自托管有两条路径。[[Docker]] 版本是 ghcr.io/usefulsoftwareco/executor-selfhost:latest,单个容器里打包了 API、MCP、认证、代码执行和 Web UI,数据落在一个 SQLite 文件里,暴露 4788 端口,零配置起步。[[Cloudflare]] 版本是部署到你自己账号下的一个 Worker,用 Cloudflare Access 做认证,用 D1 做存储。
选择的判断标准其实很清晰:如果所有 agent 都在本机,用本地版本,桌面环境选 App,服务器选 CLI;如果需要多台机器或者云端 agent 访问同一份目录,就上托管或自托管。我自己的用法是 Docker 自托管,跑在家里的 NAS 上,这样笔记本、台式机和几个服务器脚本共享同一份集成目录,同时数据完全在自己手上。
接入客户端用的是 add-mcp 这个工具,它会自动检测你当前的 MCP 客户端并写入配置:
npx add-mcp http://127.0.0.1:4788/mcp --transport http --name executor
如果要走 stdio 传输:
npx add-mcp "executor mcp" --name executor
添加集成可以在 Web UI 里点 Add Integration,也可以走 CLI。这里有个细节值得注意:当 OpenAPI 文档里的 servers 字段用的是相对路径时,需要显式传 baseUrl,否则请求不知道该发到哪里。很多内部服务生成的 OpenAPI 文档都有这个问题,第一次接的时候容易卡住。
日常会用到的 CLI 命令大概是这几个:
executor tools search <query>        # 在目录里搜工具
executor call <path...>              # 直接调用某个工具
executor tools integrations          # 列出所有集成
executor tools describe <tool>       # 查看工具的详细定义
executor resume --execution-id <id>  # 恢复一次被暂停的执行
executor daemon status               # 查看后台服务状态
executor resume 对应的就是 policy 里 require approval 那一档,调用被挂起之后用它继续。这些命令都会自动拉起本地 daemon,不需要手动先启动。
如果要在自己的代码里用,官方提供了 TypeScript SDK,同时给了 Promise 和 Effect 两套 API:
import { createExecutor } from "@executor-js/sdk/promise";
import { openApiPlugin } from "@executor-js/plugin-openapi/promise";
用下来我觉得它最适合的场景,是你手上有多个 agent 客户端,并且有一批自己的、非公开的 API 需要接进去。如果你只用一个 Claude Code,接的也都是现成的公开 MCP server,那 Executor 引入的这一层收益不大,反而多了一个需要维护的服务。它的价值随着 agent 数量和自有 API 数量的增长而放大。
OpenAPI 直接导入这条路是我认为最被低估的能力。写一个 MCP server 需要理解协议、搭脚手架、处理传输层,而扔一份 OpenAPI 文档进去是零成本的。公司内部服务基本都有 Swagger 文档,这意味着让 agent 接触内部系统的门槛一下子降到了几乎为零。当然这也是双刃剑,接得越容易,就越需要认真对待 policy 那一层。
关于 policy ,默认按 HTTP 方法分档。但是 GET 也可能是危险的,比如一个导出全量用户数据的 GET 接口;POST 也可能完全无害,比如一个搜索接口。所以自动推导出来的默认值应该被当成待审阅的草稿,而不是最终配置。特别是刚导入一份大的 OpenAPI 文档之后,值得花点时间把明显敏感的接口手动降级。目前文档里对批准流程的细节说得不多,谁能批准、请求怎么呈现、有没有超时、批准是否会被记住,这些都还不清楚,需要自己试。
另一个需要清醒认识的是,加这一层意味着多了一个单点。Executor 挂了,所有 agent 的所有工具一起挂。本地跑还好,如果是团队共享的自托管实例,这个可用性问题得认真考虑。相应地,它也成了一个高价值目标——一个集中存放了你所有 API 凭据的服务,本身的安全边界需要被认真对待,尤其是自托管暴露到公网的情况。Cloudflare 版本用 Cloudflare Access 做认证这个选择,某种程度上也是在回应这个问题。
从生态位上看,Executor 经常被拿来和 Composio 这类服务比较,核心差异在于开源和可自托管。Composio 是托管的商业服务,你的凭据存在它那里;Executor 你可以完全跑在自己的机器或者自己的 Cloudflare 账号里。对于凭据敏感的场景,这个差异是决定性的。
我觉得 Executor 真正抓住的,是 agent 生态里一个还没被认真对待的结构性问题:随着一个人同时使用的 agent 从 1 个变成 5 个,集成配置的复杂度不是线性增长,而是集成数乘以客户端数的乘积增长。用同步配置文件的方式去对抗这个乘法,只能缓解,不能解决。把集成提取成一个独立的、被所有客户端共享的层,才是从根上消掉那个乘数。
它现在还很年轻,2026 年才起步,文档里不少地方——尤其是批准流程和沙箱执行——还没写透,policy 模型也还比较粗。但方向我认为是对的。MCP 协议解决了 agent 和工具之间的通信标准,但没有解决工具的管理、认证和授权,那部分空白总归需要有东西来填。Executor 是目前我看到的填法里比较完整的一个:概念足够少,部署方式足够多,而且完全开源可自托管。
2026-08-28 13:00:00
前段时间写过一篇 Plex 将终身会员涨价到 749.99 美元 的文章,当时就在思考一个问题:当自建媒体库的门槛(无论是硬件、资源还是订阅费)越来越高的时候,还有没有更轻量的方式来管理自己的观影需求。后来在折腾 [[Trakt]] 的时候,反复在各种播放器的集成列表里看到 Stremio 这个名字,于是花了一些时间把它装到了桌面和电视上认真体验了一番。这篇文章就来聊聊 [[Stremio]] 这款免费开源的流媒体聚合应用,它的设计思路和 [[Plex]]、[[Jellyfin]] 这类传统媒体服务器完全不同,某种程度上说它更像是「浏览器」而不是「硬盘」。
Stremio 是一款开源的跨平台媒体中心应用,由保加利亚索非亚的 Smart Code 公司于 2015 年推出,官方数据显示目前全球有超过 3000 万用户。它最大的特点是本身不托管、不存储任何影视内容,只提供一个统一的界面框架和元数据层,把电影、剧集、直播频道、体育赛事、播客等内容的信息聚合在一起。至于「从哪里播放」,则完全交给插件(addon)系统来解决。
这个定位需要稍微解释一下。Plex 和 Jellyfin 的逻辑是「先有文件,再有界面」——你需要先把视频文件下载到硬盘上,媒体服务器负责刮削元数据、转码、串流。而 Stremio 的逻辑是「先有界面,再找来源」——你在界面里浏览想看的内容,插件负责实时地从各种来源找到可播放的流。换句话说,Plex 是你私人图书馆的管理员,Stremio 则是一个帮你跑遍全城书店找书的导购。
Stremio 在 2024 年底发布了全新的 v5 版本,并在 2025 年 2 月将 v5 桌面端和 Web 端开源,核心库 stremio-core 使用 Rust 编写并采用 MIT 协议。经过一年多的迭代,v5 已经覆盖 Windows、macOS(含 ARM 原生支持)、Linux(2026 年 6 月 Flatpak 进入稳定通道),功能上也补齐了 HDR 直通、手柄操作、渐进式快进等细节。2025 年 11 月的大版本更新还加入了 [[Usenet]]、FTP、压缩包(RAR、ZIP、7ZIP 等)直接串流的能力,来源的适配面越来越广。
Stremio 的一切都构建在插件系统之上,理解了插件就理解了 Stremio。它的插件和 Kodi 的插件在概念上类似,但实现上要克制得多:Stremio 的插件本质上只是一个返回 JSON 的 HTTP 服务,不能执行任意代码,不能修改界面,只能向应用声明自己提供哪几类资源。插件能提供的资源主要有四种:
应用内置的 Cinemeta 插件基于 IMDb 的公开数据集提供元数据,覆盖了绝大多数影视条目,这也是为什么 Stremio 开箱即用就有一个完整、美观的影视浏览界面。当你点开某部影片的播放页时,Stremio 会并行询问所有已安装的 stream 类插件「你有这部片子的播放源吗」,插件各自返回链接列表,你从中挑一个清晰度和来源合适的开始播放。由于插件只是 URL,安装插件就是添加一个链接,所有插件配置还会跟随账号在全部设备间自动同步——在电脑上装好的插件,电视上登录同一账号后立刻可用,这个体验比 Kodi 逐设备配置舒服太多了。
这种「插件即 API」的架构还带来一个好处:插件的开发门槛非常低。官方提供了 Node.js 的 stremio-addon-sdk,内置 TypeScript 类型定义,自动处理 CORS,用脚手架工具 addon-bootstrap 回答几个问题就能生成一个 hello-world 插件。如果你有一些自己的内容源想接入 Stremio,一个下午就能写出可用的插件。
聊 Stremio 绕不开社区插件生态,其中最出名的就是 Torrentio。它是一个聚合了众多种子站索引的 stream 插件,配置页面提供了丰富的过滤和排序选项,可以按清晰度、编码、文件大小筛选结果。直接播放种子流时体验取决于做种情况,因此重度用户往往会搭配 Debrid 类服务使用:[[Real-Debrid]]、AllDebrid、Premiumize、TorBox 这类服务的作用是把种子链接转换为高速的 HTTPS 直连流,如果资源已经在服务商的缓存里,点开几乎是秒播,4K HDR 也不在话下。Torrentio 配置里勾选 Cached only 之后,列表里只会显示已缓存的资源,体验上和商业流媒体平台几乎没有区别。
社区在 Torrentio 之外还发展出了不少替代和补充:Comet 以响应速度见长,常被用作第一备选;MediaFusion 接入的来源更杂,还支持体育直播;AIOStreams 则是把多个来源插件聚合成一个入口的「插件的插件」。这些项目全部开源,可以自己用 Docker 部署,也有 ElfHosted 这类托管服务代为运行。
不过这里必须泼一盆冷水:这套玩法虽然在技术上很优雅,但访问的内容来源大多是未经授权的。Stremio 应用本身是合法的——它只是组织链接和元数据,不托管也不分发任何受版权保护的文件——但通过第三方插件播放盗版资源的法律责任在用户自己身上。各个国家对此的执法力度差别很大,日本对盗版内容的监管尤其严格,下载行为本身就可能构成违法。所以我自己的态度是把这部分当作了解生态的知识储备,实际使用还是以官方插件和合规来源为主,这一点在文末还会再展开。
抛开来源合规性存疑的部分,Stremio 官方插件目录里也有不少纯工具性的插件值得安装。OpenSubtitles v3 提供多语言字幕,对于看外语内容基本是必装;Trakt 插件可以把观看历史、进度、待看清单同步到 [[Trakt]],我之前整理过 Trakt 的详细功能,它解决的正是跨平台观影记录碎片化的问题,Stremio 是它官方支持的播放器之一;YouTube 插件可以把订阅频道当作剧集来追,配合电视端大屏体验意外地好。此外还有播客、公开领域老电影(比如接入 Internet Archive 的插件)、各国免费直播频道等目录类插件,这些内容完全合法且免费。
插件的安装方式非常简单:在应用内的插件页面浏览官方目录一键安装,或者把社区插件的 manifest 链接粘贴进搜索框。所有插件都可以随时卸载,互相之间不会产生冲突,这得益于前面提到的「插件只是返回 JSON 的 HTTP 服务」这个设计。
Stremio 的多平台覆盖在同类应用里算是相当激进的,但 2026 年以来各平台的可用性发生了一些变化,这里按平台梳理一下现状。
桌面端是体验最完整的平台,Windows、macOS、Linux 都有 v5 原生客户端,直接从官网下载即可,macOS 版支持 Apple Silicon 原生运行和 HDR 输出。如果不想安装应用,Stremio Web 网页版功能也基本齐全,配合本地运行的 Stremio Service 就能播放种子流。
Android 是个需要注意的平台:Stremio 在 2026 年 1 月被 Google Play 下架,目前手机端和 Android TV 端的 APK 都需要从官网直接下载安装。好在重写后的 Android 客户端本身质量不错,2025 年底从 beta 转正的新版从头重构,2026 年 6 月的更新还加入了 MPV 播放器内核、Usenet 支持和自动字幕选择。Fire TV 用户则可以直接从 Amazon 应用商店安装官方版本。
iOS 的情况比较曲折:App Store 里原本有一个功能阉割的 Lite 版本,2026 年 1 月也被移除了。目前 iPhone、iPad 和 Apple TV 用户想用完整版需要通过侧载安装 IPA,而借助欧盟、日本、巴西的第三方应用市场政策,完整版 Stremio 已经上架 [[AltStore]]——在日本的用户反而因此可以比较方便地装上带种子和 Usenet 支持的完整版,这算是政策红利的一个有趣例子。电视端方面,除了 Apple TV(tvOS)之外,LG webOS(2020 年后的机型)、三星 Tizen、Philips TitanOS 甚至 Meta Quest 和 Pico 的 VR 头显都有官方客户端。
对自托管爱好者来说,Stremio 也留了一些可玩的空间。Stremio Server 是负责种子串流和 FFmpeg 转码的后端组件,官方提供了独立的 Docker 镜像,可以部署在家里的 NAS 或者 VPS 上,HTTP 端口 11470,HTTPS 端口 12470(自签证书,生产环境建议反代 HTTP 端口并在反代层做 TLS)。部署好之后在客户端或网页版里把 Streaming Server 地址指向自己的服务器,就可以让性能更强的机器承担下载和转码工作,客户端只负责播放,这个架构和 Plex 的 Server/Client 模式异曲同工。
需要说明的是开源程度的边界:stremio-core(Rust 核心库)、stremio-web(React 前端)和 addon SDK 都是开源的,但 Server 的核心代码目前仍是闭源的,只有 Docker 打包是公开的。社区对此也有回应,已经出现了用 Rust 重写的开源种子串流引擎作为 server.js 的替代实现。整体来说 Stremio 的开源姿态在商业公司里算是诚意不错,但还没到 Jellyfin 那种完全社区驱动的程度。
体验下来我的感受是,Stremio 和传统媒体服务器并不是替代关系,而是覆盖了不同的场景。Plex 和 Jellyfin 适合「收藏型」用户:你有整理好的本地媒体库,在意文件的画质版本、字幕内嵌、多音轨,希望内容永远可用不依赖外部服务。Stremio 适合「消费型」场景:想看什么点开就看,不关心文件存在哪里,看完即走。前者的成本是硬盘、服务器和整理资源的时间,后者的成本几乎为零,但内容的可用性依赖插件背后的来源。
对我来说两者是并存的:值得收藏的内容依然会入库 Plex,配合 [[VidHub]] / [[Infuse]] 在 Apple TV 上播放;而临时起意想看的剧集、追热播的新番、或者在旅途中用笔记本看点什么的时候,Stremio 的「零仓储」模式明显更轻松。再加上两边都接了 Trakt 同步观看记录,切换起来没有任何心智负担。
最后还是要严肃地把风险讲清楚。Stremio 生态里最活跃的那部分社区插件游走在版权的灰色地带,甚至可以说大部分流量都来自未授权内容。在日本,2021 年修订的著作权法已经把下载盗版影视内容明确列为违法行为,通过 P2P 方式播放种子流的同时也在上传数据,风险更高。即使在执法宽松的地区,种子流也会把你的 IP 暴露给整个 swarm。所以如果你决定尝试 Stremio,我的建议是:优先使用官方目录里的合规插件,把它当作一个聚合 YouTube、播客、公共领域内容和你已付费订阅服务的统一入口;对于灰色地带的玩法,了解其技术架构即可,实际使用前务必评估自己所在地区的法律环境。
另外从安全角度,插件虽然不能执行代码,但你的每一次浏览和搜索请求都会发送到所有已安装的插件服务器上,安装来路不明的社区插件等于把观影行为暴露给陌生的第三方。只装知名开源项目的插件、或者干脆自托管插件实例,是比较稳妥的做法。
Stremio 给我留下的最深印象不是它能看什么,而是它的架构设计:把媒体中心拆解成「界面 + 元数据 + 插件协议」三层,内容来源完全解耦,插件退化成一个返回 JSON 的无状态 HTTP 服务。这个设计让它同时做到了界面统一、配置跨设备同步、生态开放这三件 Kodi 一直没能优雅解决的事情。v5 的开源和 Rust 核心库也让这套架构有了社区延续性,即使 Smart Code 公司哪天不再维护,stremio-core 和插件协议也大概率会以某种形式活下去。
如果你已经有一套 Plex 或 Jellyfin,Stremio 不会取代它们,但值得作为补充装一个试试,尤其是配合 Trakt 之后的跨设备体验。如果你从来没折腾过媒体服务器,只是想要一个统一的界面来管理「我想看什么」,那 Stremio 几乎零成本的上手门槛会让它成为一个很好的起点——只是请记得,工具是中性的,用它看什么、从哪里看,责任始终在自己手上。
2026-08-21 13:00:00
昨天我把一块装着 [[Proxmox VE]] 系统的硬盘从之前的 SER8 拆下来,插到 4 盘位的 Me Pro 上,本以为开机就能继续用,结果卡在了最基础的一步:Me Pro 的物理网口和我原来的网口对不上,物理网口变更了名字导致无法上网。屏幕上 PVE 的控制台在闪,ip addr 里却无法找到两个物理网口,Web 管理界面自然也打不开。
在和 Claude 交流寻找解决方案的过程中,我看到 Claude 说「用手机 USB 共享网络」,先确保 PVE 有网络,然后利用网络更新 Kernel。我开始还有点疑惑,这样也可以,但是手边正好有一台 Pixel,顺手就用 Type-C 数据线链接了,然后在 Android 端切换到 USB tethering,在 PVE 查看,立马就能看到多出一张网卡,利用 dhclient enxxx 就可以获取 IP 地址,立马就能 ping 通网络。
这个功能是,当手机自己连着 Wi-Fi 的时候,它同样可以把这份 Wi-Fi 网络通过 USB 线转发出去。换句话说,一根数据线加一台安卓手机,就等价于一张即插即用的 USB 无线网卡。
这件事让我开始重新审视抽屉里那几台退役的安卓手机。它们其实是完整的 ARM 计算机:有 CPU、有内存、有存储、有电池(相当于自带 UPS)、有 Wi-Fi 和蓝牙、有摄像头和屏幕、有 USB OTG。我们只是习惯性地把它们当作「淘汰的手机」,而不是「一台便宜的、带屏幕的、待机功耗只有几瓦的小型服务器」。
要理解为什么这招好用,得先知道手机在 USB 那端到底扮演了什么角色。安卓设备通过 USB 连接电脑时,可以以不同的 USB Gadget 身份出现:MTP 模式下它是一个媒体设备,ADB 模式下它是一个调试设备,而打开 USB 网络共享之后,它把自己声明成了一个 USB 网络适配器。
具体用的协议一般是 RNDIS(Remote NDIS,微软定义的一套通过 USB 承载以太网帧的规范),近几年不少设备也改用了更标准、效率更高的 CDC-NCM。这两种协议在 Linux 内核里都有现成的驱动,分别是 rndis_host 和 cdc_ncm,属于早就编译进主流发行版内核的东西。所以主机侧不需要装任何厂商驱动,插上线之后内核就会枚举出一张新的以太网接口,传统命名是 usb0,在启用了 systemd 可预测网卡命名的系统上则是 enx 加上 MAC 地址的形式,比如 enx0a1b2c3d4e5f。
有意思的是手机这一侧。它并不是简单地做一个透明网桥,而是实实在在跑了一套小型路由:手机在这个 USB 网络接口上给自己分配 192.168.42.129 这个地址,同时启动一个 DHCP 服务,把 192.168.42.0/24 网段的地址发给通过 USB 连过来的主机,然后对出站流量做 NAT,把它们转发到当前的上游链路。这个上游链路可以是移动数据,也可以是手机正连着的 Wi-Fi。安卓的 tethering 框架并不关心上游是什么,它只负责把默认路由指向那条可用的链路。这正是「手机变无线网卡」的关键:Wi-Fi 进,USB 出。
顺带一提,Wi-Fi 热点用的是 192.168.43.0/24,蓝牙共享用的是 192.168.44.0/24,这三个网段是安卓 tethering 的固定约定。知道这个在排查问题时很有用,看到 192.168.42.129 这个网关地址,你就能确定链路走的是 USB 而不是别的。
PVE 基于 Debian,所以下面的步骤在绝大多数 Debian 系发行版上通用。先把线插上,在手机的设置里找到「网络和互联网 - 热点与网络共享 - USB 网络共享」并打开。注意这个开关往往是灰的,直到系统检测到 USB 数据连接才会变为可点,而且它要求你用的是数据线而不是只能充电的线,这个坑我踩过不止一次。
打开之后回到主机,先确认内核有没有认出设备:
lsusb
ip link
dmesg | tail -20
正常情况下 ip link 里会多出一张 usb0 或 enx 开头的接口,dmesg 里能看到类似 rndis_host ... register 'rndis_host' at usb-0000:00:14.0-2, RNDIS device, 0a:1b:2c:3d:4e:5f 的日志。如果什么都没出现,先手动加载一次驱动:
modprobe rndis_host
modprobe cdc_ether
modprobe cdc_ncm
接口出来之后,临时用的话一条命令就够了:
ip link set usb0 up
dhclient usb0
拿到地址后 ip route 里会出现指向 192.168.42.129 的默认路由,此时 PVE 的 Web 界面就能通过这个新地址访问了。如果你希望它持久生效,可以在 /etc/network/interfaces 里加一段:
allow-hotplug usb0
iface usb0 inet dhcp
allow-hotplug 而不是 auto 是有讲究的,手机不一定一直插着,用 auto 会让开机时因为等待这张不存在的网卡而拖慢启动。
有一点需要提醒:这套方案更适合救急和临时维护,不适合长期作为服务器的主链路。手机会不断被主机供电,长时间维持在满电状态对锂电池不友好,而且系统更新、电话来电、后台清理都可能中断这条链路。我的做法是把它当成「带外管理通道」,用它把机器救活、把正式网络配置好,然后拔掉。
PVE 的特殊之处在于它既是宿主机也是虚拟化平台,所以这张「手机网卡」有两种用法,要根据目的选择。
第一种是留在宿主机上,也就是我前面救急时用的方式。适合的场景是宿主机自己失联了,你需要一条通道进入 Web 管理界面。配置就是上面那几条命令,不需要动虚拟化相关的东西。如果你还希望虚拟机也能借道上网,不要试图把 usb0 桥接进 vmbr0,这条路走不通。原因在于 RNDIS 接口只会为它对面的那一个 MAC 地址学习和转发,安卓侧不接受来自多个 MAC 的帧,桥接之后虚拟机发出的包能出去但回不来。正确的做法是在宿主机上做 NAT:
sysctl -w net.ipv4.ip_forward=1
iptables -t nat -A POSTROUTING -o usb0 -j MASQUERADE
这样挂在 vmbr0 上的虚拟机把网关指向宿主机,就能通过手机出网。要持久化的话把 net.ipv4.ip_forward=1 写进 /etc/sysctl.d/,NAT 规则用 iptables-persistent 保存。
第二种是把手机整个直通给某台虚拟机,比如你想让 OpenWrt 或者软路由虚拟机直接管理这条上行链路。在 PVE 的 Web 界面里,选中虚拟机进入硬件页,添加 USB 设备,这里会给出两种绑定方式:按厂商和设备 ID,或者按 USB 端口。
对安卓设备一定要选按端口。这是个容易忽略但很关键的细节:手机在切换 USB 模式时会重新枚举,Product ID 跟着变,比如 Pixel 在纯充电、MTP、ADB、网络共享几种状态下报的 ID 各不相同(Vendor ID 固定是 Google 的 18d1,Product ID 却会在 4ee1、4ee2、4ee7 之间跳)。如果你按 ID 绑定,用户在手机上一点「USB 网络共享」,设备就从虚拟机眼前消失了。按端口绑定则只认物理插口,无论手机怎么切换模式都能保持连接。
命令行的写法是先用 lsusb -t 找到总线和端口号,再挂给虚拟机:
lsusb -t
qm set 100 -usb0 host=1-4
其中 1-4 表示 1 号总线的 4 号端口,100 是虚拟机的 VMID。如果插的是 USB 3 口,可以加上 usb3=1。这个操作支持热插拔,虚拟机不需要重启就能看到新设备,虚拟机内部同样会出现一张 usb0,配置方法和前面完全一致。
两种方式不能同时使用。设备一旦直通给虚拟机,宿主机上的 usb0 就会消失,所以如果你的目的是抢救宿主机本身,老老实实用第一种。
救急之后我顺着这个思路想下去,安卓能做的远不止转发网络。最有想象空间的是 [[Termux]],它在不 root 的前提下提供了一个相当完整的 Linux 用户空间环境,有自己的包管理器 pkg,能装 Python、Node.js、Go、Rust、git、ffmpeg、nginx、openssh 这些常规工具。你可以在手机上跑一个 sshd,然后从笔记本 ssh 进去,体验和登录一台小型 VPS 没有本质区别。
实际能落地的场景不少:把 [[Syncthing]] 装在旧手机上,它就是一个永远在线的同步节点,比常开一台 NAS 省电得多;用 Termux 跑定时任务抓取数据、做备份;跑一个轻量的下载器,配合外接的 OTG 硬盘当离线下载盒子;甚至可以跑 [[copyparty]] 这类文件服务,把手机的存储变成局域网里的文件共享点。一台闲置的旧机器待机功耗大概在 2 到 5 瓦之间,比树莓派还低,而且自带屏幕和电池。
如果你需要的是更完整的发行版而不只是 Termux 的环境,[[Andronix]] 或者 Termux 自带的 proot-distro 可以在用户态跑起 Debian、Ubuntu、Arch 的根文件系统。性能会因为 proot 的系统调用拦截而打折扣,但对于跑一些依赖 glibc 的软件是够用的。
[[Scrcpy]] 是我用得最频繁的工具之一。它通过 ADB 把一个精简的 server 推到手机上,用 H.264 编码把屏幕流传回电脑,同时把电脑的键鼠事件注入回手机。延迟通常在 35 到 70 毫秒之间,实际体验接近于手机变成了电脑的一个窗口,可以直接用键盘打字、用鼠标操作,还能拖拽文件安装 APK。不需要 root,也不需要在手机上装任何应用。
配合 ADB 还能玩出更多花样。adb reverse tcp:8080 tcp:8080 可以做反向端口转发,让手机上的应用访问到你电脑本地的服务,调试移动端对接本地 API 的时候特别方便。adb shell 则是一个完整的命令行入口,很多在 UI 上被厂商藏起来的设置项,都能通过 settings put 直接改。
Android 14 开始,系统原生支持把手机作为 USB 摄像头使用,插上电脑就会被识别成一个标准 UVC 设备,不需要装任何驱动或者第三方软件。对于手上有旗舰旧机的人来说,这基本是白捡了一个画质远超普通笔记本内置摄像头的网络摄像头。如果你的系统版本较低,DroidCam 或者 IP Webcam 这类应用也能达到类似效果,只是要走 Wi-Fi 或者 USB 转发,多一层配置。
反过来,手机也可以当显示器。spacedesk 这类工具把手机变成 Windows 的扩展屏,出差时带一台平板或者旧手机,就多了一块放监控面板、放文档的副屏。
USB OTG 则打开了另一扇门。旧手机接上 OTG 线之后可以读取 U 盘、SD 读卡器、移动硬盘,也可以接键盘鼠标。我见过有人把旧手机加 OTG 键盘当成一个极简的写作机器,续航一整天。
这两个用法比较小众,但真到需要的时候特别救命。
DriveDroid 可以把手机模拟成一个 USB 存储设备或者光驱,直接把手机里存放的 ISO 镜像挂载给目标电脑启动。这意味着你不需要随身带 U 盘和 [[Ventoy]],手机里存几个常用的救援镜像就够了。代价是这个功能需要 root 权限,因为它要操作内核的 USB Gadget 配置接口。
另一个是串口控制台。很多服务器、交换机、软路由的管理口是 RJ45 转串口或者 USB 串口,配一根 USB 转 TTL 的线(CH340 或者 FTDI 芯片都行)和一个 OTG 转接头,再装一个 Serial USB Terminal 之类的应用,手机就变成了一台便携的串口终端。机房里不用再抱着笔记本蹲在机柜前,这个体验的差别是巨大的。
PCAPdroid 是一个不需要 root 的抓包工具,它的实现思路很巧妙:利用安卓的 VpnService API 把本机流量引到自己的虚拟接口上,然后落盘成 PCAP 文件。你可以按应用维度过滤,看某个 App 究竟往哪些域名发了请求,也可以把抓到的包导出用 Wireshark 分析。对于研究某个应用的网络行为、排查国内 App 的隐私问题,这是最低门槛的方案。
再加上各种 Wi-Fi 分析工具能看信道占用和信号强度,手机其实是一个相当称职的现场网络诊断设备。装修布网络、排查家里 Wi-Fi 死角的时候,比拿电脑方便太多。
数据线是第一个坑,也是最常见的一个。很多随手机附赠的线或者从充电宝里翻出来的线只有电源触点,没有数据线芯,插上去手机只会显示充电,USB 网络共享的开关始终点不亮。换一根确定能传数据的线,能省掉半小时的排查。
后台被杀是第二个坑。国内定制系统的省电策略非常激进,Termux 里跑着的服务可能在你锁屏几分钟后就被清掉。对策是在系统设置里把这个应用加入电池优化白名单,同时在 Termux 里执行 termux-wake-lock 持有唤醒锁。如果需要开机自启,装一个 Termux:Boot 插件,把启动脚本放到 ~/.termux/boot/ 下。
还有一个比较隐蔽的问题:从 Android 12 开始,系统引入了 phantom process 限制,会主动杀掉应用派生出的子进程,默认上限是 32 个。这对普通应用没影响,但 Termux 里跑多个服务很容易触发,表现为进程莫名其妙消失。可以通过 ADB 关掉这个监控:
adb shell device_config set_sync_disabled_for_tests persistent
adb shell device_config put activity_manager max_phantom_processes 2147483647
需要注意这个设置在部分系统重启后会失效,需要重新执行。
最后是应用来源。Termux 的 Google Play 版本早已停止维护,功能残缺且不再更新,务必从 F-Droid 或者官方 GitHub Release 安装。这类工具类应用普遍存在类似情况,装之前多确认一下渠道。
这次 PVE 迁移带来的最大收获是让我意识到自己对手上工具的想象力实在有限。一台安卓手机被我们默认框定在「打电话、刷视频、拍照」的用途里,但它的底层是一个跑着 Linux 内核的通用计算设备,具备网络栈、USB Gadget、传感器、编解码硬件这些完整的能力。厂商的 UI 只是把这些能力包装成了消费级的形态,而这些能力本身一直都在。
抽屉里那几台旧手机,我打算挑一台出来常年插着电,跑 Termux 加 Syncthing 当同步节点,顺便当成随时可用的救急网卡。它的性能可能不如一台四五百块的迷你主机,但它已经在那里了,边际成本是零。在折腾家庭实验室这件事上,先把已有的东西用起来,往往比再买一件新的更有成就感。


