
2026-10-05 18:20:00
我的整套方案,除了HDD等硬性开销以外,没有新增任何成本:笔记本是闲置的,云端服务器是已有的,软件全部都是开源的或者使用内置的功能。
flowchart TB
    subgraph HOME[家庭内网 192.168.31.0/24]
        Router[主路由器<br/>192.168.31.1]

        subgraph Win[Windows 服务器(联想 Yoga 13s Pro)]
            WinIP[本机 IP<br/>内网 192.168.31.187<br/>easytier 10.126.126.2]
            OPN[Hyper-V OpenWrt 旁路由<br/>192.168.31.188]
            Dock[USB 扩展坞<br/>千兆网口 + USB 3.0]
            SVC[SMB 文件共享 / RDP / Jellyfin / Docker]
        end

        HDD[单盘位硬盘盒 + 8T HDD<br/>NTFS]
        PC[台式机<br/>内网 192.168.31.64 / easytier 10.126.126.5]
    end

    subgraph ET[easytier 虚拟网 10.126.126.0/24]
        AZ[Azure K3S 集群<br/>主初始节点,wss 暴露<br/>10.126.126.1]
        GC[GCP e2-micro<br/>备用初始节点,公网 IP<br/>10.126.126.11]
    end

    subgraph OUT[外部 / 其他内网的客户端]
        NB[公司笔记本<br/>10.126.126.4]
        PH[Android 手机<br/>10.126.126.3]
        GPU[内网 GPU Linux 服务器<br/>10.126.126.11]
    end

    HDD -- USB 3.0 --> Dock
    Dock -- 千兆网线 --> Router
    OPN -. Hyper-V 网桥接入内网,<br/>作为其他设备的旁路网关 .- Router
    PC -- 局域网直连 --> Router

    Win <--> AZ
    Win <--> GC
    NB & PH & GPU <--> AZ
    NB & PH & GPU <--> GC
NB & PH & GPU <-. P2P 打通后直连 .-> Win整个配置的核心是一个2020年购入的超轻本联想Yoga 13s Pro,配置为i5 1135G7+16G+512G。
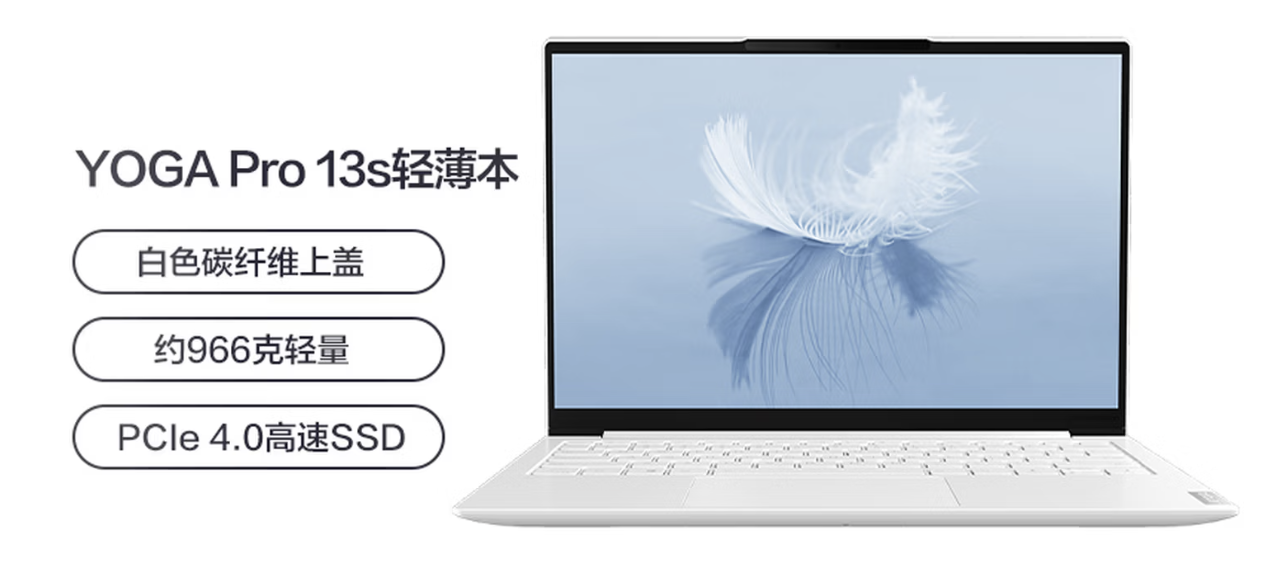
当时买这个电脑最看重的就是它的轻:966g的体重非常适合当时还在读书的我在各个场所之间转点。在购入这个本子之前,我长期用的是X1 Carbon 2018,所以超过1.12kg的笔记本用于通勤在我看来都是不可接受的。
这个电脑被我作为出门的主力用到了2023年。工作后公司配发了笔记本,出门要处理工作也只需要携带公司的笔记本,所以这个笔记本就闲置了,直到我开始想搞homelab配置的时候才想起来:与其重新买一个性能可能还不如这个笔记本的NAS,为什么不直接用它呢?
大多数用于搭建homelab的设备都会使用Linux,这当然可以理解:安装方便,作为服务器一般也不需要GUI,对配置要求低。但是,我最终还是直接用了笔记本自带的Windows,而没有重新装系统,主要考虑到以下几个因素:
我在搭建homelab之前就有了一个8T的HDD,但用法是直接接了个硬盘盒插到台式机上使用,所以直接格式化成了NTFS。这么多年了,Linux对NTFS的支持只能说是读没问题,而写入就有比较大的风险,甚至于2024年我用一个NTFS的U盘在Linux写了个简单的文件,再把U盘插到Windows电脑上后,Windows就报错。所以如果要在Linux机器上,就不得不格式化成Linux直接兼容的文件系统,而当时硬盘已经写了好几个T了,迁移数据的过程非常麻烦,所以索性就不格式化了,也不换笔记本的操作系统了。
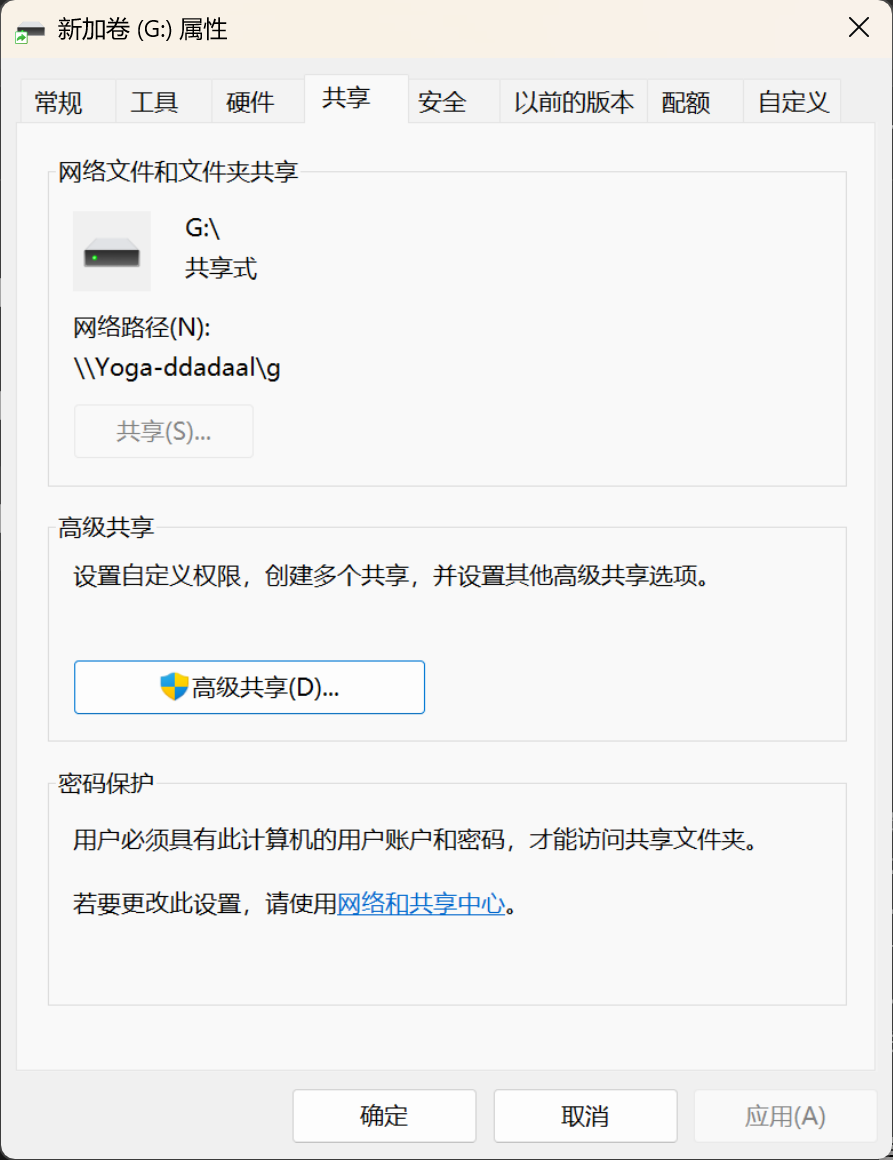
Linux能干的当然也能干。Jellyfin,Docker等常见软件Windows都有,文件共享也可以使用内置的SMB方案(右键要共享的目录,当然也有坑,见下文),有大量客户端软件都支持SMB。并且有了WSL2和Hyper-V,理论上Windows可以完成所有Linux可以做的事情,而Linux做不了的,例如各类仅Windows的国产软件,那在Windows上就可以直接使用、而不是用去找绕过方案了。
虽然我整天做Linux的运维,但是从易用性层面来说,Windows还是更胜一筹,几乎所有运维操作都可以用GUI解决,而不同于服务器集群运维,绝大多数homelab的运维工作都是临时的、一次性的,不需要自动化。加上RDP,我可以在任何地方,甚至从一个Android平台,连接到服务器并操作。另外,Windows还可以直接运行我需要的软件。例如,某些时候我需要往NAS上下载大文件,而与其在Windows电脑上下载好再传过去,不如直接在服务器上通过GUI操作来下载。
当然,Windows运维起来和Linux还是有一些区别的,并且还有一些Windows埋下的坑需要特殊注意:
从Windows 8开始微软开始推广微软账号登录,设置了微软账号登录的电脑无需再设置本地密码。但微软似乎忘了RDP/SMB默认的用户名和密码登录模式。RDP还好,如果登录的设备也是用微软账号登录的,那么直接可以直接登录。但是从不是Windows设备,例如Android设备的RDP应用登录时,以及通过SMB来连接共享的文件或者文件夹时,系统要求的用户名和密码到底是啥就比较让人摸不着头脑了。
这个网上有不少处理方法,但是总的来说,都会要求用户从本地用户登录,再切换到微软账号,并且需要至少在锁屏界面使用完整密码登录过一次系统,之后才能正常地用这个本地用户的用户名和密码登录RDP或者SMB。我更推荐在初始化系统的时候,就先使用本地账户登录,进入系统后再切换成微软账号,因为这样做还有个好处,可以让家目录的目录名是完整的(C:\Users\ddadaal)的而不是根据微软账号自动生成的5位字符。
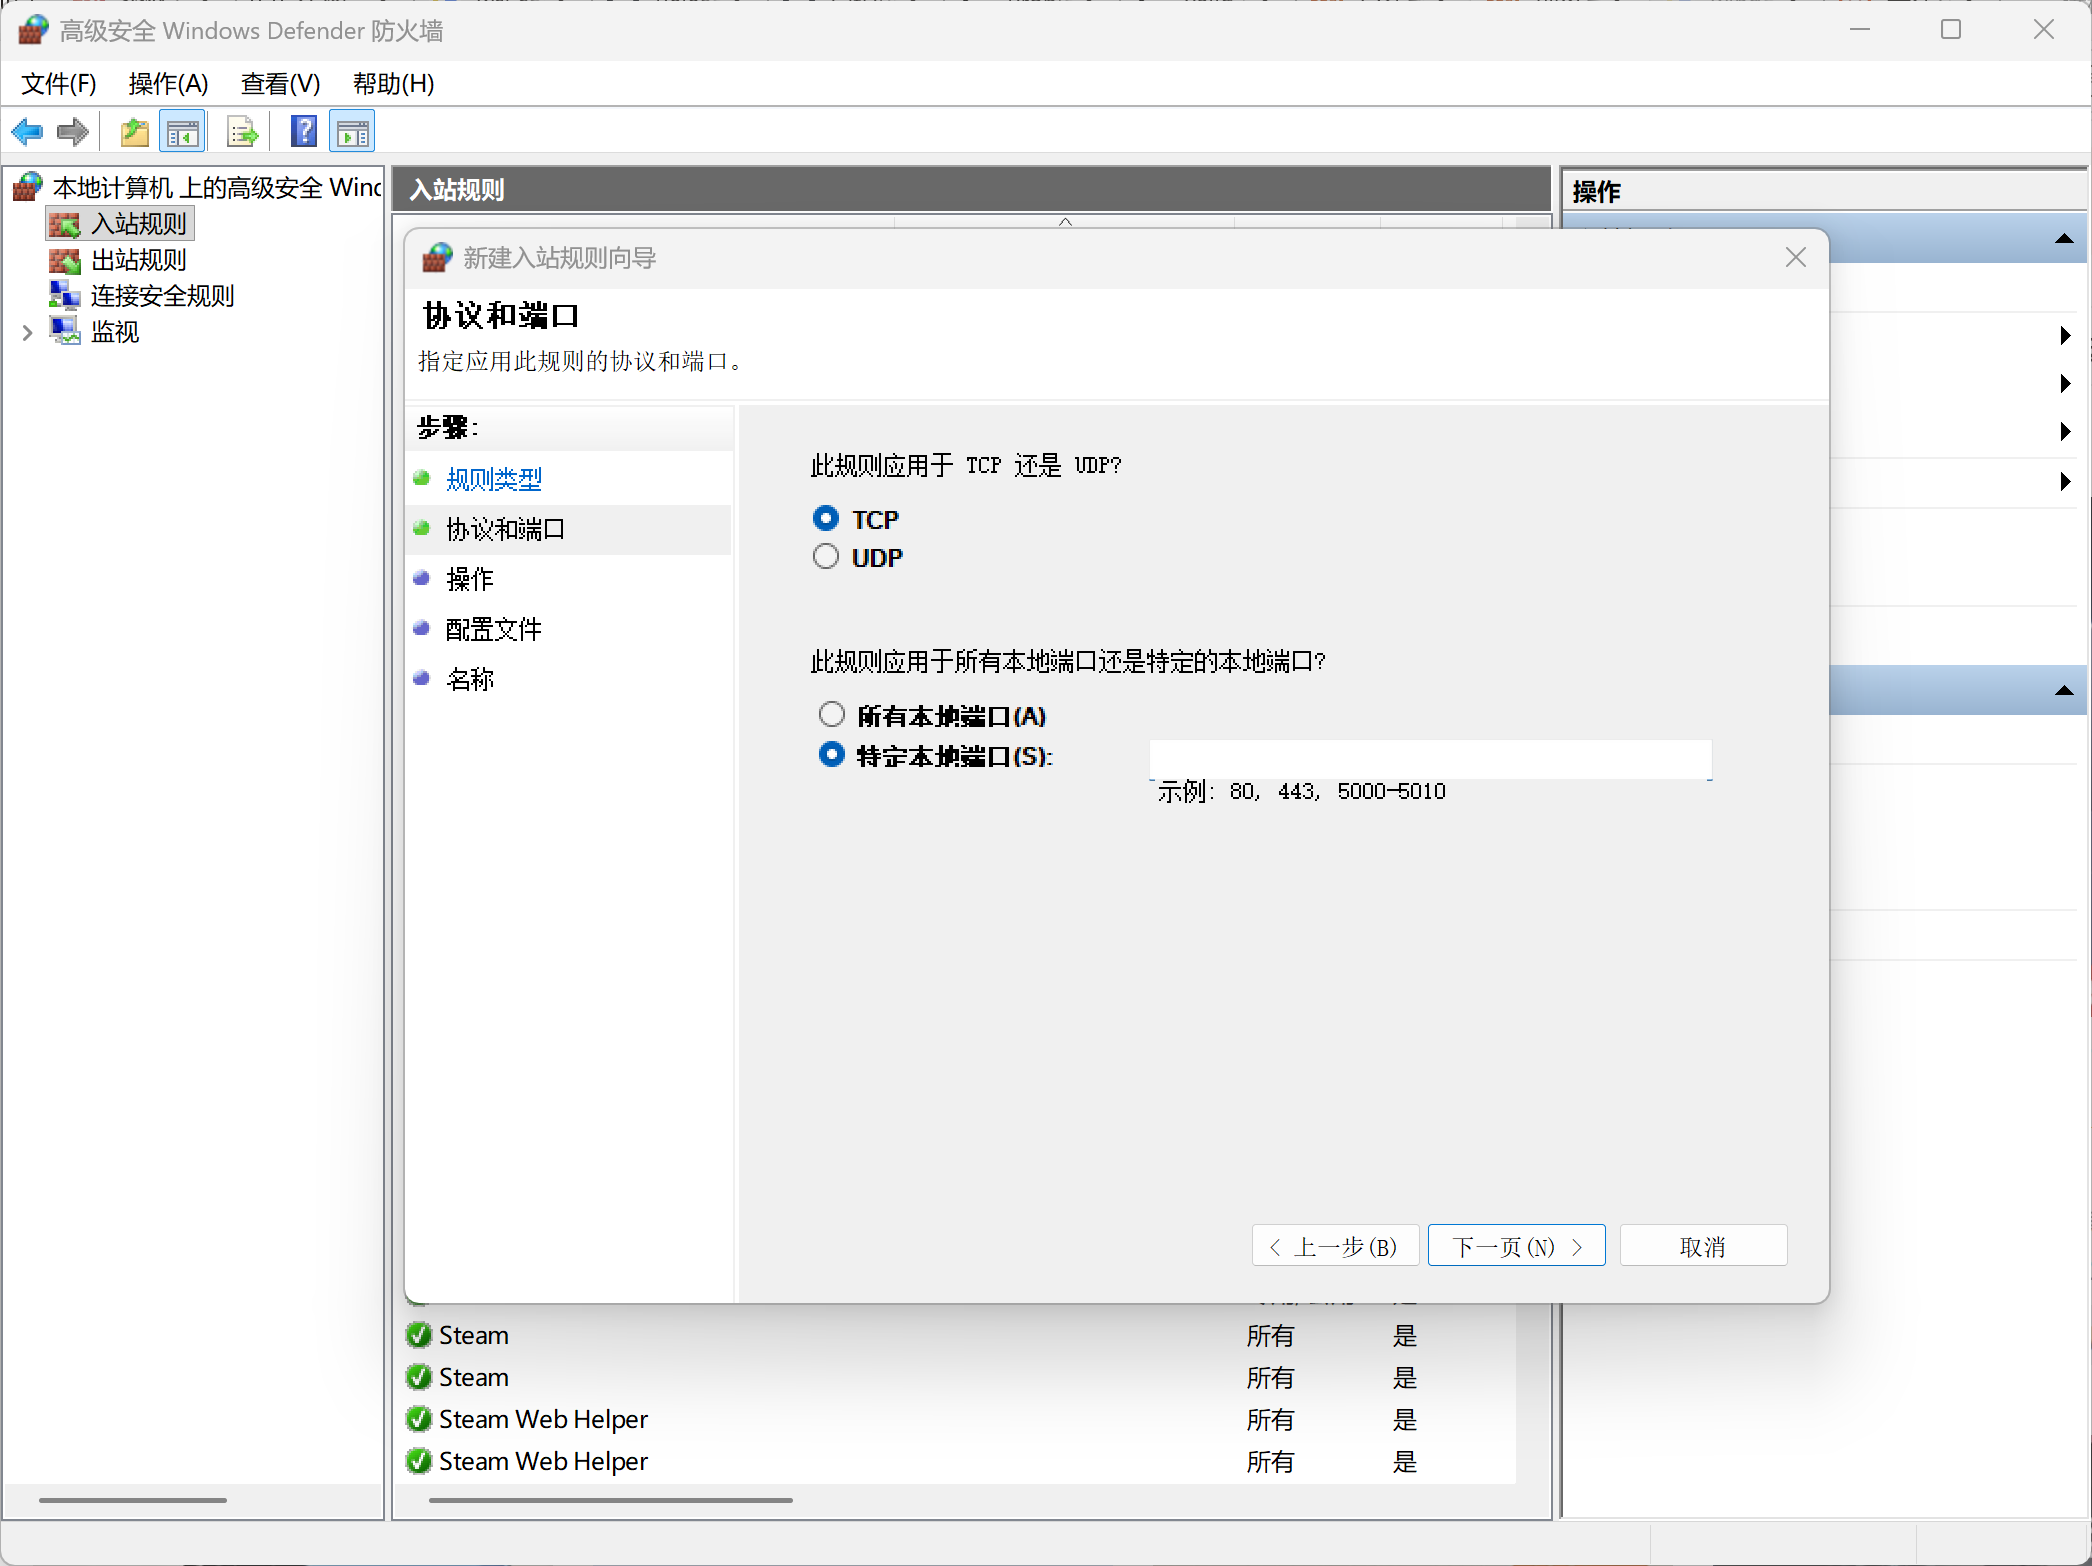
和大多数开启了防火墙的Linux系统一样,Windows也内置了非常完善的防火墙功能,这个功能平时用得不多,因为常见的应用都会自动添加防火墙规则。但是当我们自己写的Windows应用需要监听0.0.0.0的时候,系统会弹出提示,需要明确允许才可以监听(如果只是监听127.0.0.1就不会)。而如果一个WSL中的程序监听了0.0.0.0且WSL的网络是Mirrored时,我们就会发现Windows本机可以访问,但是局域网中的机器不能访问,这个时候就需要手动创建一个入站规则,让这个端口可以被其他机器访问。操作也比较简单,运行firewall.cpl进入防火墙界面,添加一个入站规则,跟着向导输入端口号即可。图形界面还是比较直观的,作为对比,我到现在都不记得firewall-cmd的设置规则的命令。
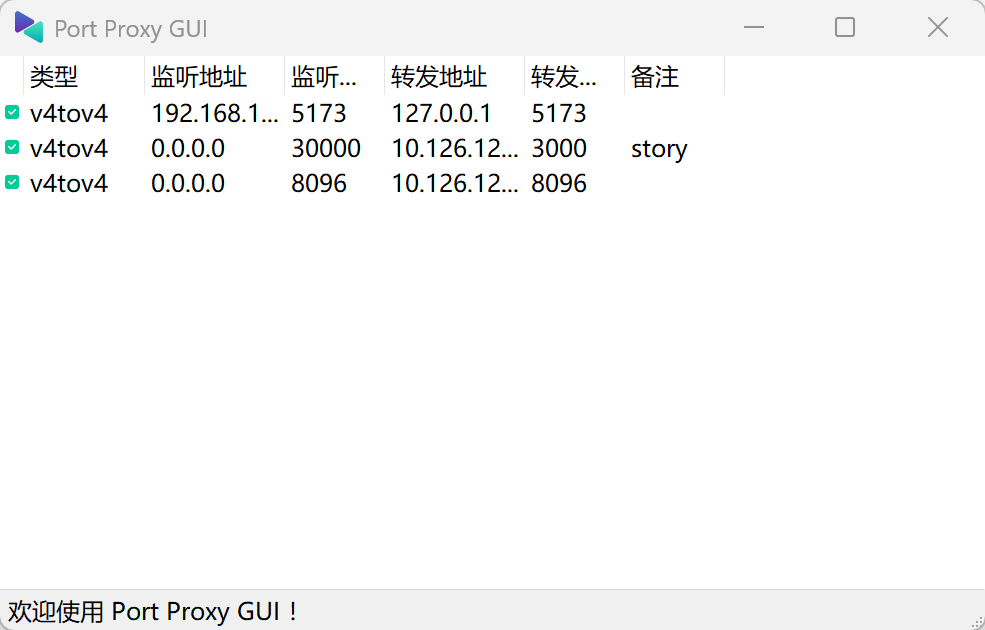
我这里有时候还有一个需求,也就是需要把仅监听内网地址的服务让内网其他机器也可访问(说的就是你,DeepSeek Harness)。另外,前几个月的Docker Desktop的端口转发似乎有问题,本来应该直接监听0.0.0.0的容器,实际只监听了127.0.0.1,于是想在局域网中访问这个服务,就必须把这个端口映射出来。Windows内置的防火墙是直接支持端口映射的,命令格式为(需要在提升权限的终端下运行):
netsh interface portproxy add v4tov4 listenaddress=0.0.0.0 listenport=18080 connectaddress=127.0.0.1 connectport=28080
但我都用Windows了,为什么还要输入命令?于是从GitHub上找到了一个可以配置转发规则的GUI程序: https://github.com/zmjack/PortProxyGUI 。非常感谢这个作者!
Windows 10开始微软不允许消费级的Windows系统停止系统更新,这对日常系统来说问题不大,但是对于服务器端用途的设备来说就比较折磨了,所以每次出远门前要记得暂停系统更新几天,并且为了以防万一,必须要让能够提供远程访问的程序在系统重启后自动启动。这样,即使系统真的重启了,也能有一个方法远程连接回电脑来启动其他程序。
软路由也是玩homelab不得不品的一环。由于我的笔记本只有一个物理网口,直接将它作为路由器不是非常现实,所以我采取了旁路由的方案。也就是不改变原来的路由器,而是将这个设备在局域网中作为一个独立的网关,设置局域网中的其他设备的默认网关为这个设备,让这些设备的流量都会经过这个软路由,从而让这个软路由可以处理到流量。而把openwrt装成一个Hyper-V虚拟机,然后建立一个网桥将openwrt暴露到内网并设置一个静态IP,这样就可以完美实现这一方案。
flowchart TB
    subgraph LAN[家庭内网 192.168.31.0/24]
        Router[主路由器<br/>192.168.31.1]

        subgraph Win[Windows 服务器(Hyper-V 宿主机,192.168.31.187)]
            OPN[Hyper-V 虚拟机:OpenWrt 旁路由<br/>192.168.31.188(OpenClash)]
            Bridge[Hyper-V 虚拟交换机(网桥)]
            OPN --- Bridge
        end

        Dev[其他设备<br/>默认网关手动设置为 192.168.31.188]
    end

    Dev -- ① 流量发往网关 192.168.31.188 --> OPN
    OPN -- ② OpenClash 处理后转发 --> Router
    Bridge -- 经扩展坞千兆网口桥接到内网 --> Router
OpenWrt虽然运行在Windows服务器里,但它通过Hyper-V的网桥直接接入了内网,拥有独立的IP(192.168.31.188),而不是和Windows服务器(192.168.31.187)共享IP。其他设备只需要把默认网关改成192.168.31.188,流量就会先经过OpenWrt处理,再由它转发给主路由器。
我使用的是原版的openwrt,并在此之上安装了OpenClash插件,这样经过旁路由的流量就可以自动科学上网了。原版openwrt对资源消耗也比较低,这样一台性能弱鸡的设备也完全可以支撑。
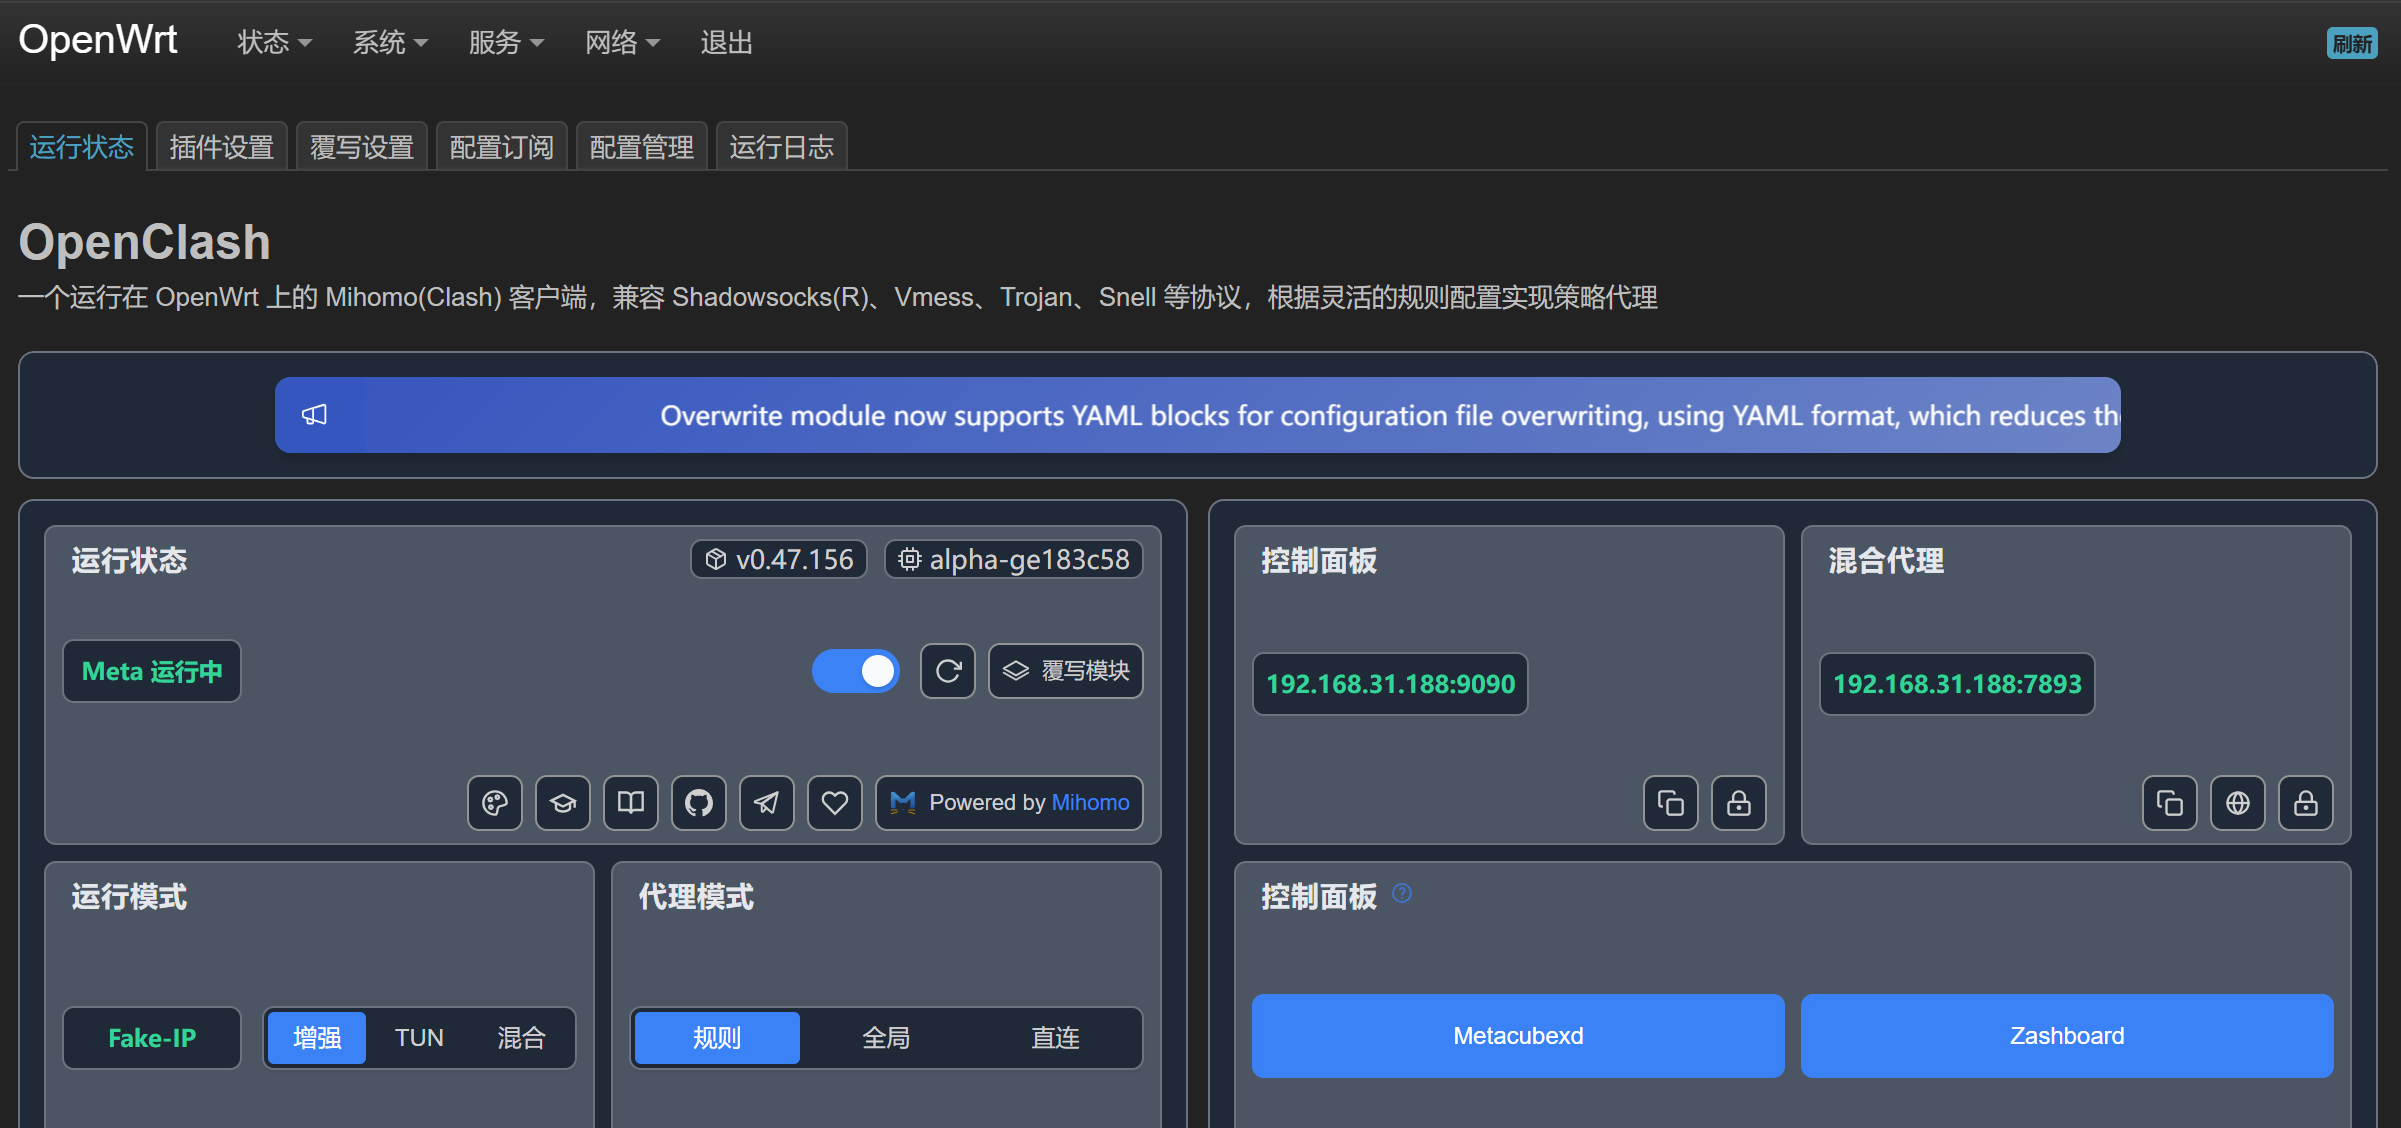
但我最后没有让所有设备都走旁路由,因为我的主要需求实际上只有科学上网,软路由的其他功能(如Docker等)我都通过Windows服务器+easytier虚拟网(后面会讨论)实现了,但是我的各类设备设备不仅要在家里、还需要在外面可以科学上网,所以本来就必须配置好科学上网软件,需要使用的时候直接打开软件就行,不需要走旁路由。但如果以后需要购入单独开科学上网不方便的设备(如各种国外的VR设备),那这个方案还是非常有用的。
由于我这个笔记本本身定位是超轻本,所以它的性能和外设都不是设计的重点。
接口层面,整台电脑只有3个C口和一个3.5mm耳机接口,没有A口也没有网口,这对于一个NAS设备来说确实不太够用。于是我找了一个带有千兆网口和USB 3.0的扩展坞,这样就完美满足了需求。和物理网口相比,Wi-Fi在速率和稳定性上确实还是差了不少。
性能层面,虽然笔记本本身是双风扇,但由于本身笔记本也不是性能导向,加上11代i5比较惨的性能和散热设计,还因为我这个笔记本由于用了太长的时间(到现在已经6年了),硅脂等都已经失效,所以只要稍微给笔记本加上一点性能压力,笔记本就特别烫,连带着的就是降频。在不加外置散热+烤机的情况下,CPU频率甚至能低到0.2Ghz,系统完全无法使用。由于懒得自己换硅脂,某一天突发奇想,直接用风扇怼着吹,发现性能。后面搬家后这个风扇没有带着一起走,就买了一个散热底座,虽然效果不如风扇直吹,但是起码能用了。
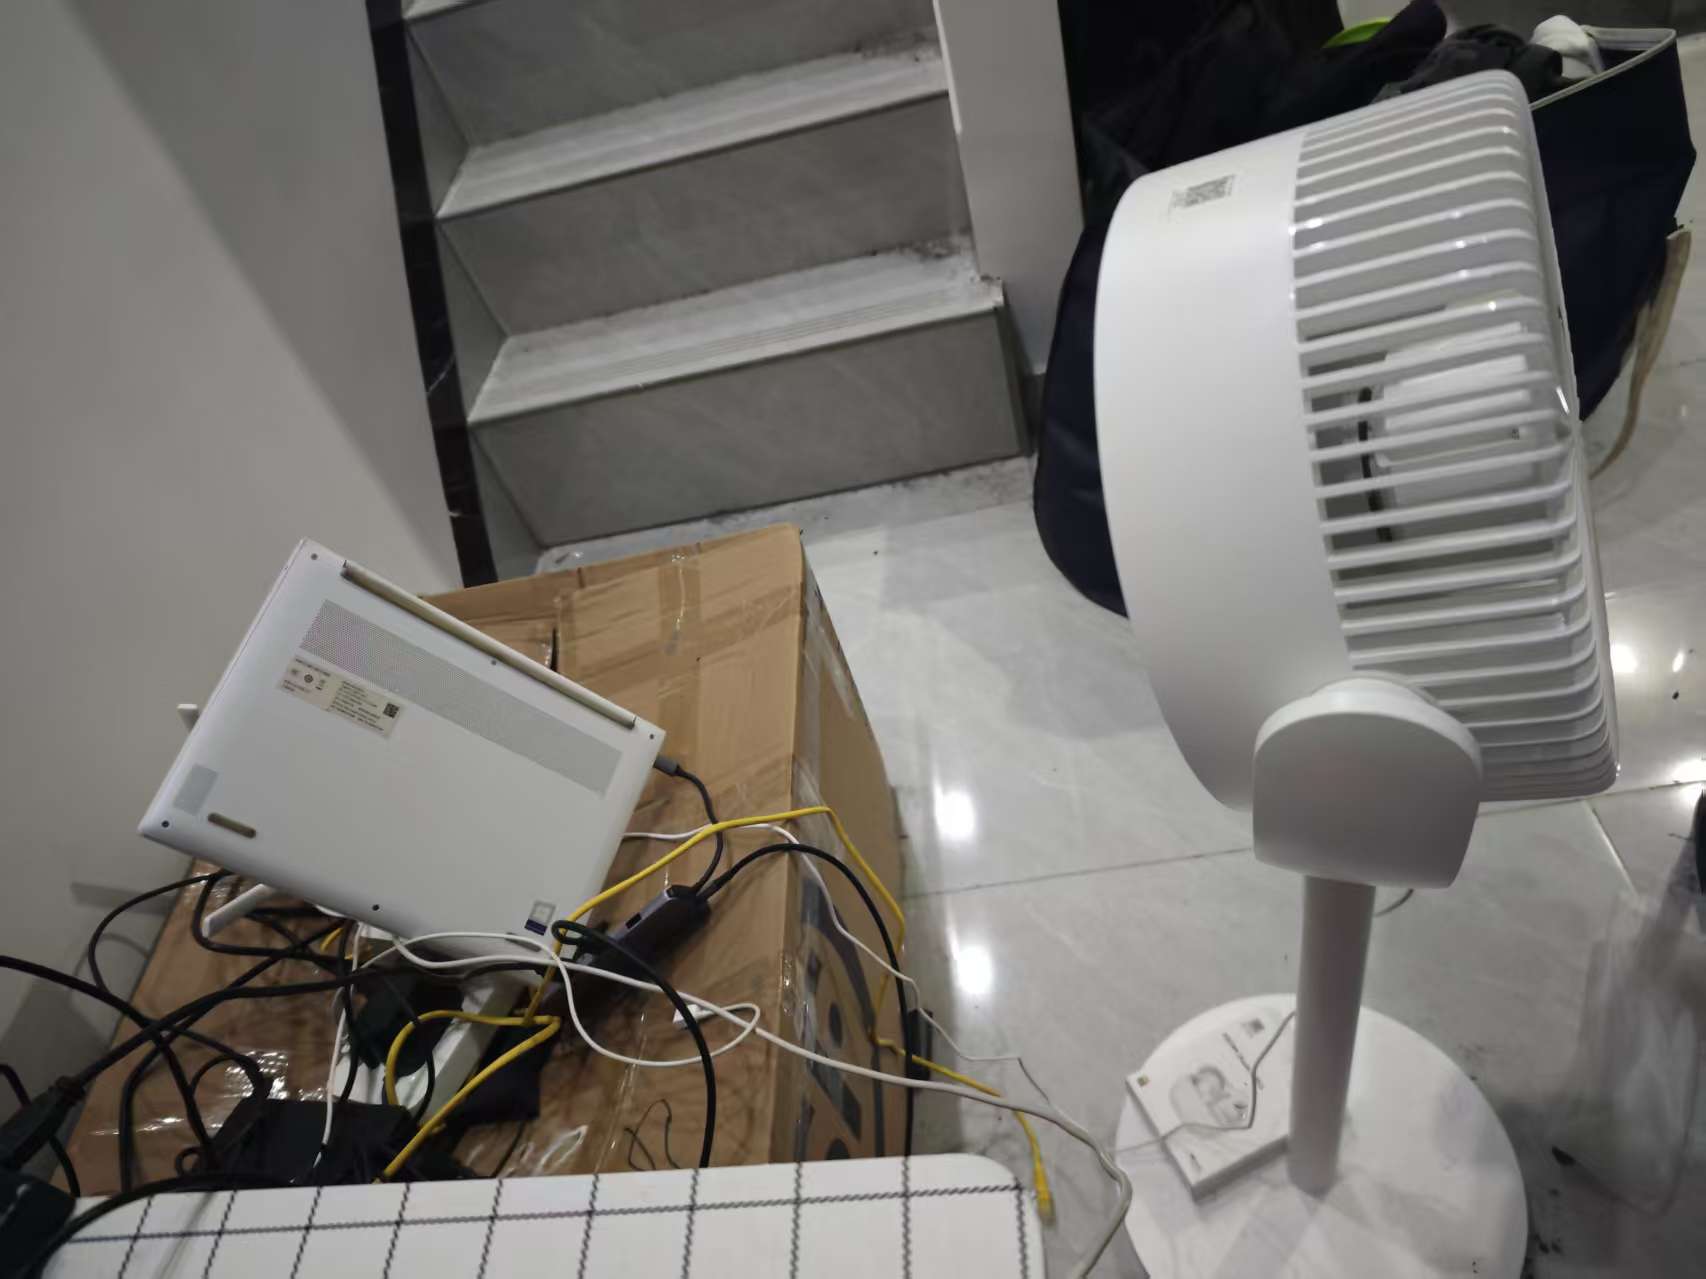
比较有意思的是,我一直以为这个降频是11代i5本身的锅,因为之前公司配发的11代i7笔记本同样也会降频到0.6Ghz。直到后面有一次偶尔在降频情况下摸了一下笔记本底盖被烫到,才发现是散热的问题。
homelab的一大功能就是提供NAS功能,这也是我的整套配置一开始的想法,所以我很早就买了HDD。但是在当时,我还想着可能之后会有扩展HDD的操作,所以直接一步到位买了一个4盘位的、可以提供软RAID的硬盘坞。可惜,直到我最后放弃这个硬盘坞,我都没有用过这个软RAID功能。
为什么我最后放弃了这个4位硬盘坞?因为我的数据坏了。
不知道具体是什么原因,从硬盘坞开始使用第一天,在正常运行的过程中硬盘也一直有“咔咔咔”的声音。这个声音是不正常的:要么是供电不足,要么是硬盘本身有问题。可是我这个硬盘是全新的刚买的呀!而供电不足也只能是硬盘坞本身的问题,但硬盘坞本身有外置电源,且设计是支持四个硬盘的,总不可能一个硬盘都不带起来吧!
死活查不出问题,后面也懒得继续查了。硬盘坞就这么运行了2年多,期间我经历过几次同城和异地的搬家,由于异地搬家需要坐飞机,为了防震,我也做了一些简单的保护,搬家完成后硬盘仍然一切正常,还让我长舒一口气。
可是没想到的是,突然在2025年11月的一天,系统无法访问这个硬盘的数据了。Windows甚至还可以识别到硬盘的总容量和可用容量,但是数据是完全无法访问。尝试了一些方法,最终只能放弃硬盘。还好我的主要数据都是多地备份,重要的数据都在云端有一份,只有本地保存的各类电影、游戏资源还可以重新下载。
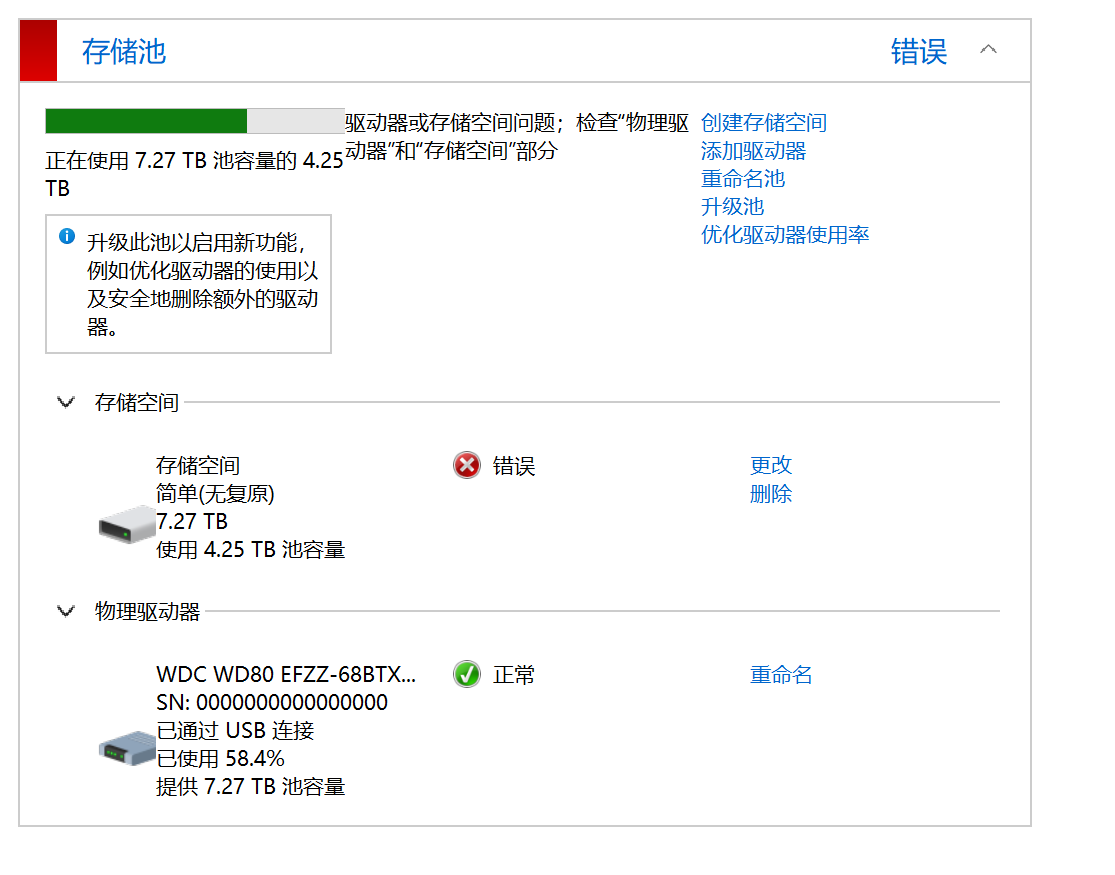
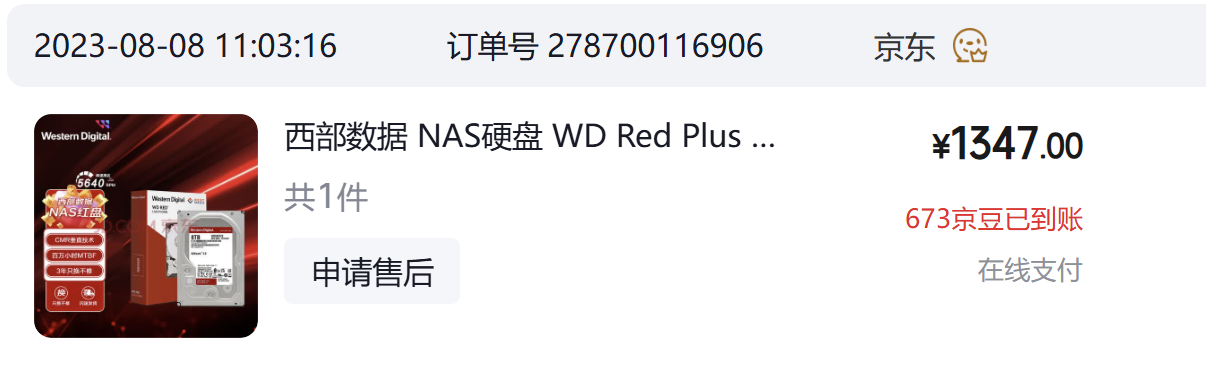
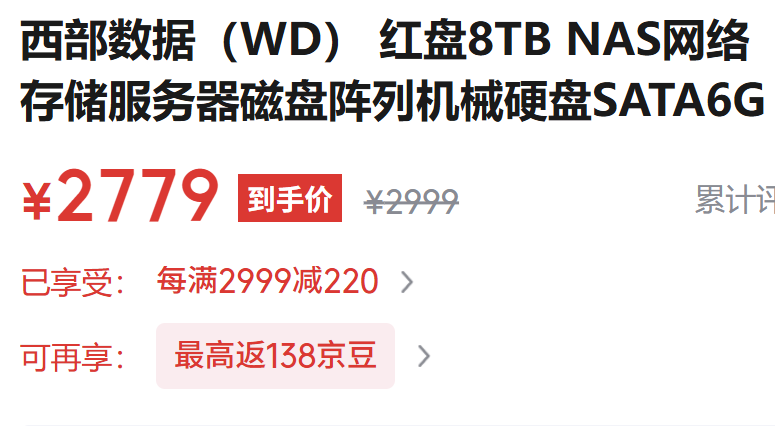
BTW,从那个时候开始存储的价格已经开始飙升。在我2023年8月购入HDD的时候HDD的价格只有1300出头,而此时价格已经涨到了1700。当我已经下单时,在朋友的提醒下发现HDD的保修居然是3年且我当时仍然在HDD的保修范围内,于是直接找京东免费重新换了一个。而现在再去看同款HDD的价格,官方店已经下架,第二方店铺已经快3000了,AI的存储需求实在是太恐怖了。
2023年硬盘价格:
写文时的硬盘价格:
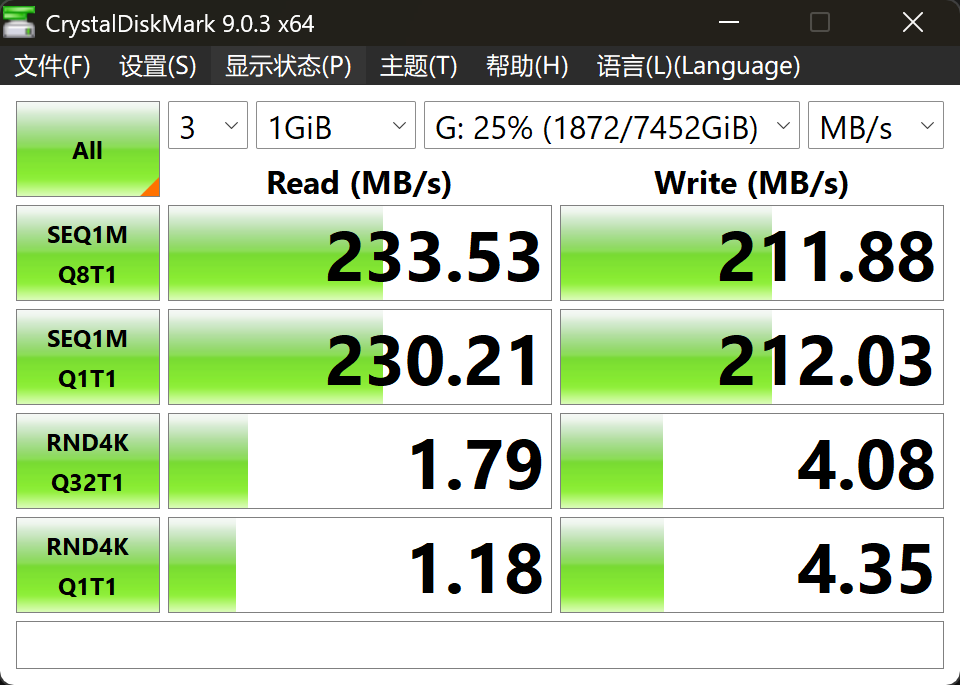
后面考虑到我的NAS需求并没有那么大,且这类硬盘盒方案已经让我损失过一次数据了,所以就换了一个简单的单盘位硬盘盒,这下一切都没问题了:没有咔咔声,移动起来方便,甚至连性能都正常了:当时用硬盘坞的时候,读写只有100MB/S,而现在总算恢复到了200MB/S的正常速度。对于一个仅用于存储文件的硬盘来说,这个性能已经完全够用了。
Homelab的另一个特性就是从互联网也可以访问内网的服务,这也是很多NAS产品的最大卖点。
我一开始使用的是frp,但frp的配置粒度是端口,且修改配置文件必须重启。这样就不够灵活,每次要新增服务都需要手动修改配置文件并重启转发服务,而如果正好是在远程修改配置,远程桌面都会断掉,而如果配置文件写错了,那就完蛋了,设备直接连不上了。
于是后面开始研究内网穿透方案,第一个选择就是Tailscale。这是一个非常老牌的内网穿透方案,但在我的网络环境中,无论是使用官方的服务器,还是我自部署的headscale开源第三方的控制服务器,穿透成功率都非常低。且tailscale如果想做普通的转发,则必须单独部署DERP服务器。
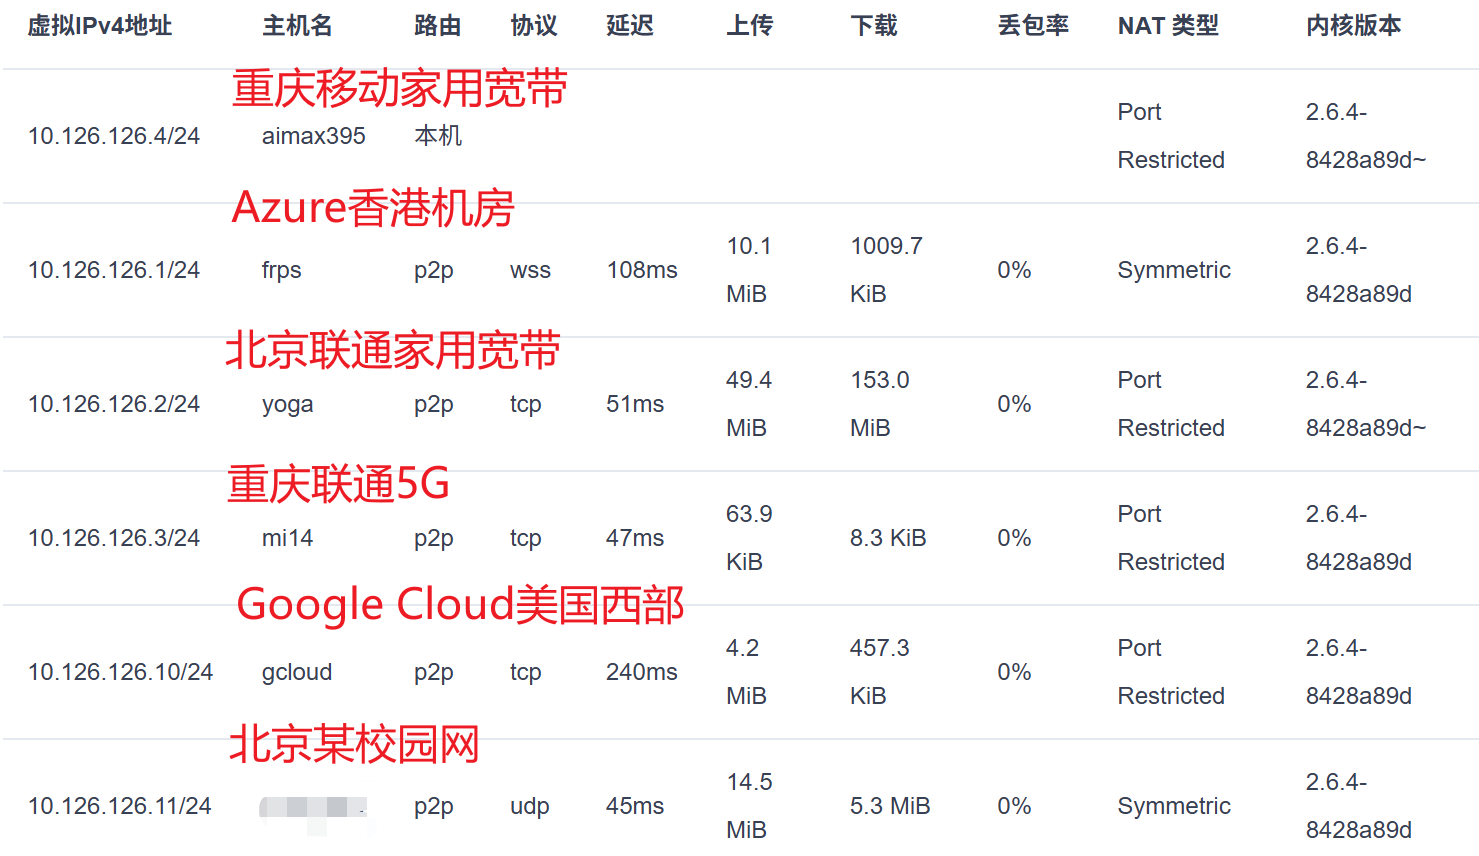
后面研究了很多方法,最终easytier满足了我的一切需求:
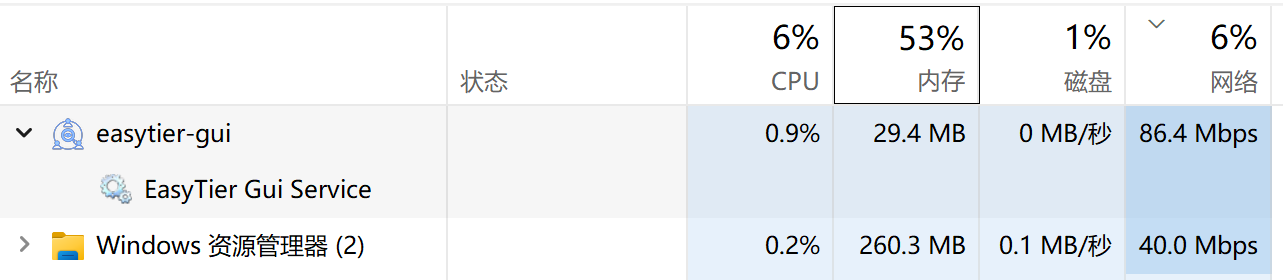
下图为从重庆移动家用宽带传输的笔记本到北京联通家用宽带中的NAS,已经打满了家用宽带的上行带宽(4MB/S)。比较奇怪的是,Windows Explorer给的传输速度是4MB/S左右,但是任务管理器里easytier-gui的网络使用是实际值的两倍,不知道是统计错误还是设计原因。
作为一个虚拟组网的方案,easytier在不开启no tun的情况下,会创建一个虚拟网络,每个网络中的设备都会有一个网段中的IP的虚拟网卡,这样,所有设备上监听了0.0.0.0或者这个网络的应用都可以直接访问,不需要每新增一个应用都要改一个配置。服务器上的NAS、RDP等端口无需单独配置即可直接使用。
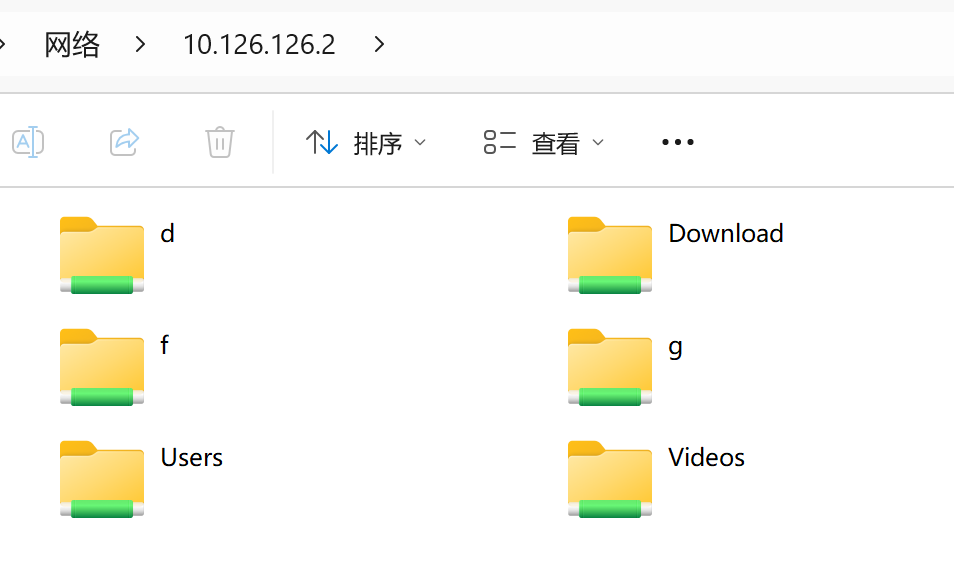
easytier本身不区分客户端和服务器端,所有节点只需要部署一个完全相同的二进制和大致相同的配置文件即可。实际部署需要选择一个公网可访问的节点作为所有节点的初始连接节点。只要能P2P,这个节点本身就不会走数据流量,所以初始节点本身的带宽和延迟就没那么重要。
我将主要初始节点部署在了博客的发展3:将博客迁移至Azure并添加访问指标采集中提到的Azure上的K3S集群。在写文的时候,虽然支持TCPRoute/UDPRoute的Gateway API v1.6已经Generally Available,但是K3S内置的Traefik还仅支持Gateway API v1.4,v1.4版本中TCPRoute/UDPRoute还处于实验阶段,还不可以直接公开TCP/UDP端口。easytier本身还支持WebSocket协议,所以可以直接将easytier通过wss协议暴露出来。
而Google Cloud Platform目前还提供免费的e2-micro虚拟机(文档),虽然都是us的机房,延迟很高,性能也一般,而且似乎还有流量的限制,但是有公网IP,作为一个备用的easytier主节点已经非常足够了。
除了命令行二进制以外,官方还给全平台(甚至Android)提供了GUI客户端。甚至Windows客户端还可以快速地配置为Windows服务,这样即使Windows重启了,easytier也能自动运行,不会让这个机器连不上。
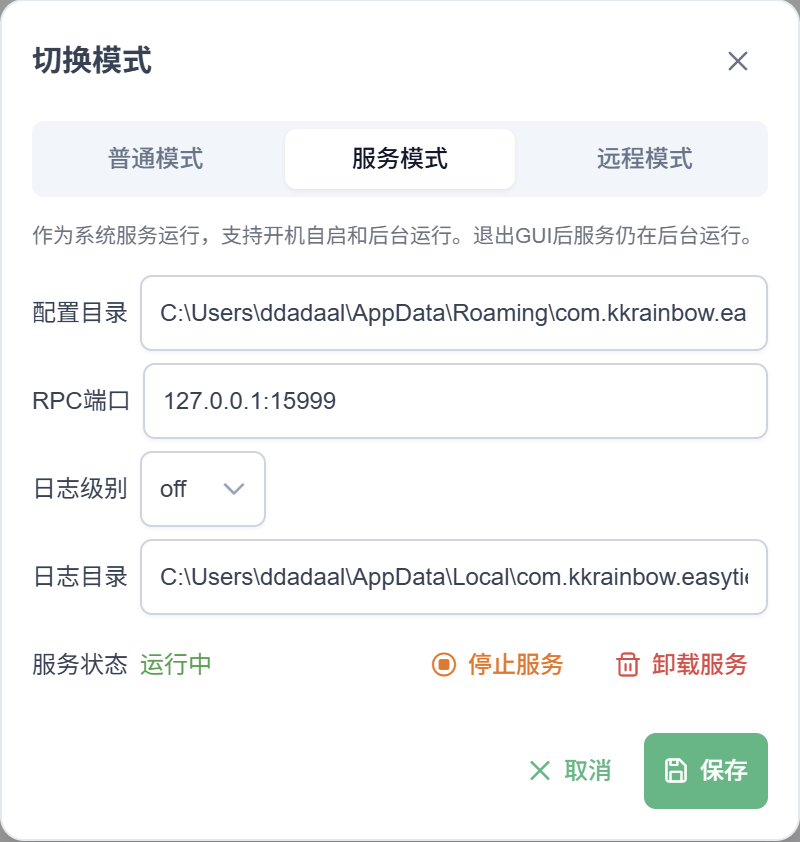
而Android客户端的使用体验虽然就是一个GUI套壳,但是使用起来也完全没有问题,唯一有的问题就是Android不支持多重VPN,启动一个easytier会顶掉科学上网VPN。我看网上有人让AI把科学上网软件和easytier这类内网穿透工具的功能做成同一个软件,这样在系统层面启动一个VPN即可,内部的流量由这个软件负责。
后续我想做的最重要的事情是透明加密+网盘备份。之前损失过一次数据,而要想保护数据完整性,除了本地装RAID以外,另一个比较节省钱的方案是将数据保存到网盘上。但是网盘经常和谐一些文件,所以需要在上传时将文件加密,下载后将文件解密。在Linux上可以使用FUSE做一个虚拟文件系统,如gocryptfs,在一个实际的目录上创建一个挂载点,从挂载点读写的文件时候,写入文件的时候将内容自动加密后存储到实际目录中,读取文件的时候自动解密,而在网盘软件中将实际目录设置为同步目录,这样就实现了从本地读写实际内容,网盘备份加密。而在我影响中,Windows对用户态文件系统没有那么友好,官方并未开放类似FUSE的用户态文件系统解决方案,后续会在AI的帮助下试试第三方的方案如Winfsp来实现这个比较重要的需求。
另外,我还在考虑做一个控制台,把NAS上的一些常见功能做成一个Web界面。以往这类功能都会直接采用第三方的方案,但是第三方的方案再好,也不如自己写符合自己的需求,而有了AI,定制化开发不再是一个时间问题,许愿式编程真的已经成为了现实。
2026-09-15 21:39:00
在开始文章之前,我先下个定义,本文的“主流就业圈”指代大厂、头部初创这类需求量大、人员流动性高、认可度高,对求职者的要求、能提供的待遇标准趋同的工作。我并不认为主流就业圈是唯一的就业正解,但是对大多数人来说,这些工作就是较优解。
毕业两年后,我从一家大厂离开,加入了一家创业团队。如今,我甚至无法通过一些主流岗位的简历筛选。回望这段经历,我做错了哪些事情?
AI彻底改变了程序员工作的流程,也改变了整个就业市场,几乎已经不存在和AI无关的工作。但是,这个趋势是从什么时候开始的呢?
我毕业时,ChatGPT已经出现,但多数人仍把它看作更强的聊天机器人,很少有人认为它会成为新的生产力。后来,AI逐渐进入企业工作流,能够调用外部工具、编写和修改代码,也开始承担越来越完整的工作。在工具和基础设施领域,原本的部署和运维工作也逐渐加入了越来越多AI相关功能。
等到我真正意识到AI已经成为就业市场的必选项时,这个趋势已经非常明显了。
我没有看到这个趋势吗?
2024年起公司内部的AI工具和探索已经满天飞,AI已经接入多个关键的内部系统并开始发挥作用。我也尝试过用 AI 探索代码库、修复问题和辅助评审,尝试将AI在团队内部推广,获得过定期与+3大老板沟通AI应用的相关讨论。我甚至还获得过头部AI公司的面试机会。
但这个时候我的重心在哪儿呢?
我的主要精力放在内部工具链、合规改造和一个从实习的时候就开始推进、但是在发布前夕被砍掉的项目上。在私下的项目,我也把大量时间用于扩展机制、权限系统、项目管理,甚至想牺牲做业务功能的时间,把项目用另一种语言重写,却没有真正推动 AI 功能或解决用户最迫切的问题。
在那个时候我看来,这些工作都很重要:流程要合规,项目要上线,系统要考虑长期维护。我甚至没有好好准备面试,在这家头部 AI 公司的面试中败在了一些完全是常识的问题上。
我做了许多在当时看来对公司、对项目重要的工作。但这些工作没有一个和趋势有关,在现在的就业市场面前看来,几乎就等于无价值。
如果说在上一家公司工作时还能找到一条比较清晰的主线,回到创业团队后,我的工作内容就越来越“丰富”了。
总是有来自各个方面的需求,总是在解决问题。即使每个内部基建最终都成为了项目开发不可或缺的工具,质量我也认为已不弱于大多数公司,设计的流程也或多或少一直发挥着作用,但放在一起,连我自己都说不清楚我究竟擅长什么,也很难让下一位面试官判断我适合什么岗位。
主流就业选项需要的是专精的人,并不需要什么都会的人。
所有人都可以在AI的帮助下快速学习一个全新的领域并解决一个从未见过的问题。我曾在几乎不了解某项底层技术的情况下接手一个虚拟化和GPU的相关项目,并在很短时间内借助AI完成了大量学习、改造和兼容工作。但这更像是快速完成任务,而不是在稳定、真实、大规模的问题中形成自己的专业深度。我可能暂时比其他人知道得更多,但所有人都可以借助 AI 很快追上来。
AI比人类更快、更好地完成绝大多数具体工作,也可以设计出比绝大多数人更全面的解决方案。解决问题本身已不值钱,而值钱的、有意义的是接触真实问题的机会。
但是,
连真实环境中会遇到什么问题都不知道,怎么知道应学习哪些知识、应设计什么方案、应作出哪些取舍?闭门造车出来的方案,拍脑袋想出来的产品、制度,销售不知道有什么优点,客户用起来别扭,面试官不理解项目有哪些特点,同事不知道应该怎么做,除了自娱自乐,还有什么实际作用?
我虽然表面上可以把大多数工作归类为调度、集群管理或 DevOps,但是当真正寻找类似岗位时,有些岗位要求大规模集群经验,有些岗位虽然没有明确写出这些要求,却在投递后直接拒绝。其他相关方向又缺乏足够有说服力的深度履历。管理就更不用提了,谁会招一个没有完整成功项目经验的人来做真正的管理呢?
之前我一直没有考虑互联网公司,因为那时我以为自己已经知道想要什么。上一家公司同时满足了我当时的大多数追求:喜欢的城市、认可的公司、感兴趣的工作内容、WLB、社会认可、稳定,而它的劣势,也就是待遇和发展潜力,在那个时候的我看来没有那么重要,因为我以为未来总是会越来越好。
可是,后来这类工作的机会逐渐减少,裁员越来越频繁,升职和涨薪也越来越难。而那个时候,创业团队的业务看起来蒸蒸日上,融资似乎也近在眼前。这个时候,“想做出一番事业”这一想法的权重提升,而“社会认可”“城市”“社交”等因素的重要性被调低,我去了创业公司。
而随着创业公司的业务逐渐定型,我又重新开始追求“城市”“公司”和“社会认可”,也曾尝试进入一家头部 AI 公司。可此时,在情绪的主导下,虚假的“WLB”诱惑让我早早放弃了这个机会。当我最终认识到 AI 已经成为必选项,以往选择工作的标准已经过时,却发现已经不再有加入新时代的机会。
我认为,自己在认可的事情上一直有不错的行动力。求学和早期工作阶段,我曾把大量精力投入社团和项目,曾在保研材料提交DDL的时候相通并申请保研,也曾主动选择当时被认为缺乏前景的外企和创业团队。
但是这之后,我的“行动力”反而带来了不幸:
有人说做点什么总比什么都不做好。我不赞同。不行动也是一种行动。朝着正确的方向行动固然可以带来巨大的收益,但是如果行动错了呢?
上学的时候选错方向,还能通过实习或者升学争取机会和时间弥补;第一份工作找得不好,还能时间、有精力学习新知识、更换公司,其他人也愿意给机会。但是,当每个行为都被记录在案,每个变动都决定了接下来几年时间中自己的方向,每个选择需要几年的时间才能消减影响,人生还有多少机会去试错?
在该发展能力的时代选择了安逸,在该利用平台的时候放弃平台优势,在该沉淀能力的年纪浅尝辄止,在新热点发展最快的时代沉迷于过时的领域而白白浪费时间,在好不容易到手的正确机会上因妄想维持原有的生活方式狼狈逃避。
现在偶尔仍会遇到一些真正有价值的机会,例如主导真正的集群的建设和维护、推动公司走向正常化,或弥补过去没有准备好的面试。我也曾认真投入,享受做这些真正有意义的工作的过程,并努力补上过去缺失的知识,甚至都已经做到初见成效,可是这些事情总是悄悄走向了沉寂,这些机会最终还是没有落到我手里。是啊,有背景更匹配、经历更深入贴合、节奏更适应的选择,为什么会选我呢?
果然,我几乎不可能回到主流就业圈了。
文章到了最后,我也想提出几个“人生建议”。如果有读者可以从我的故事中学到点经验,避开点坑,那也算是没有浪费读者阅读这篇文章的宝贵的时间。
紧紧跟随、快速转向主流方向
每个阶段,总有一些主题在市场上有巨大的需求。13年后的移动开发,16年后的互联网,23年后的AI。方向主流意味着这些方向有着最多的需求、最快的发展潜力、进步空间和最大的当期和未来回报。作为求职者,应永远将时间和精力面向这些主流的方向,尽量少投入时间和精力在已经明显走下坡路的方向。一旦有机会,应尽快投入主流方向的工作,在时代的浪潮中占据一个自己的位置。
在 AI 时代、大学生越来越多也越来越强的情况下,时间越来越重要。现在每年毕业上千万的应届毕业生没有过往知识、技术和角色的包袱,有精力、有最新的知识和更广阔的眼界。任何一个需要人才的公司都会、也应该以应届生和年轻人为主要培养对象。如果不尽快给自己在新的发展中找个位置,等待着我们的只有被社会、被年轻人淘汰。
充分利用平台的力量
AI时代,问题最重要。移动互联网时代,草根还可能通过一些工作量少的创新逆袭大平台,而现在,没有优秀平台提供的挑战、资源和社交圈,我们甚至没有办法跟上主流方向的前沿。所以,应尽可能加入可以提供真正的挑战的平台,应尽可能利用好平台提供的资源以及身边同事的能力,尽快把解决最新、最实际的问题的经验写进自己的履历。即使没能真正接触这些核心的问题,平台本身也是履历的最好的背书。
做让未来拥有更多选择的选择
平均下来,每个人应该还有一段不会被社会淘汰的工作时间。在这段时间内,我们一定会做出多次改变,而且改变可能越来越频繁。为了让每次改变都尽可能有利于自己的发展,每次选择最重要的考虑因素,不是待遇或 WLB,而是如何让自己在未来拥有更多选择。
稳定只是幻影,按部就班、讲究经验的发展模式已经过时。只有不停地调整方向,才是真正的稳定;只有面向真正的问题,才能真正提高自己在社会竞争中的能力;只有不断淘汰自己的过去,才能让自己不被未来淘汰。
2026-09-12 19:02:00
自从上一次将博客重写为一个静态网站后已经运行3年了。
这套架构非常简单:所有网站代码以及文章源码全部都在仓库里。要更新网站,直接改代码或者写文章,推送到github上,CI构建网站,把构建好的静态文件推到另一个发布为github pages的仓库ddadaal/ddadaal.me.github.io里,更新后的网站就可以访问了。
为什么要折腾了?
由于之前是纯静态网站,完全没有办法记录动态的信息。之前的博客的评论数据都是存放在ddadaal/ddadaal.me.github.io的Issues里的。
在前AI时代,我也部署过一个简单的访问量采集服务,当时还写了个文章增加自制博客点击量统计。这篇文章单独写了一个Node.js服务,本博客中加了一些JS钩子。现在看来,把逻辑分在两个项目里还是太麻烦了。
而在现在AI时代,写一个完整的指标采集服务也是个非常简单的工作,于是一不做二不休,一口气把完整的指标采集都给实现了。
由于访问指标采集会涉及到隐私相关的信息,这里列出目前会采集的信息,并且,由于博客代码纯开源,后续有任何改动,都可以在代码中看出来:
以GDPR的标准来说,其中有的数据已经涉及到个人信息,如可以关联多次访问的IP哈希。但以后有问题再说吧。
微软一直在给微软员工发150刀每年的Azure订阅。我从2019年第一次在微软实习开始就开始领,并且竟然直到现在这个订阅还生效(感谢微软爸爸),我一直没有充分利用好这些资源。
这次趁着想要添加指标采集的功夫,就直接把整个网站+数据库全部搬迁到Azure。
第一次先选择了经典的全托管AKS+Azure SQL Server方案:
访问 -> [AKS] -> [Azure SQL Server]
整个网站代码本身放在AKS上:
AKS正常运行情况下用量其实挺小的:
❯ kubectl top nodes
NAME                                CPU(cores)   CPU(%)   MEMORY(bytes)   MEMORY(%)
aks-agentpool-27587481-vmss000000   229m         12%      3669Mi          63%
但是呢,AKS会默认装一些用处不大的功能在集群里,这些功能的Pod会占用集群的配置资源。AKS集群创建后,自己装的pod就占用了1300m的CPU,然而2C的集群总共只有1900m的CPU可以分配,也就是留给应用程序的只有600m。如果自己的应用设置了requests,那么很容易出现资源不够、触发scale up,花费更多钱。所以针对我们这些穷逼用户,最好还是关闭Azure的一些没那么常用的功能,包括
数据存放在Azure SQL Server中:
IP和流量对于国外的云来说几乎免费。这样下来,花钱的大头也就是Node pool的虚拟机,通过计算器估算一个月70/80刀,150刀勉强够用。
之前的CI/CD很简单:推送代码 -> 构建静态HTML/JS/CSS -> 推送到github pages仓库 -> github pages部署。
现在由于变成了一个完整的网站项目,所以CI/CD也需要较大的改动。推送代码后,GitHub Actions需要:
整个过程中完全没有密码参与:
az CLI命令就可以全部完成。这样一套下来,我完全没有任何运维压力。数据库、AKS、扩缩容、TLS证书、部署全部不需要手动管,平时的运维也直接用标准的Kubernetes工具链即可,不太需要熟悉其他技术。
不得不说,Kubernetes生态真的是好东西,不仅是统一了软件的管理,还尽量把不同云服务商之间提供的服务也给统一了,大多数时候只需要和kubernetes本身打交道。之前我有一些服务放在Azure App service上的,其部署、运维都是一套单独的API,要使用就得重新学一整套概念、一整套新的UI以及新的CI/CD。
本以为这样就大功告成了,没想到隔了两天后再进Azure Portal发现余额少了20刀,并且发现博客的加载量没有增加,重启服务后发现时候就莫名其妙访问不了了。
经过一番研究后才发现,我之前博客的访问数据只是做了个读缓存,一旦有访问或者缓存失效就会写数据库,这样10万小时的CPU时间完全不够,用了2天就用完了。
于是为了恢复访问,我紧急打开了SQL付费,并优化了一下数据库访问设计,直接做了个内存缓存,所有读只从内存读。
这样解决了数据库vGPU的问题,但是带来了另一个问题:当长时间没有访问(也就没有数据库写入),数据库会自动暂停。然而数据库从暂停到启动的时间又大于30s,超过了我配置的数据库超时时间,于是读写数据库就又失败了。但如果不打开自动暂停的话,数据库一直运行就一直收CPU的费用。
再加上AKS本身的费用也比预想中的多很多,于是我下决定,还是放弃花里胡哨的全托管,回归了最经典的虚拟机+单节点kubernetes的形式。代码也改成了直接读写本地SQLite数据库,部署起来方便。
开好VM,直接让AI给装了个k3s,把所有yaml直接迁移过去,改了改CI,费用果然就下来了。也没有更多的付费内容,2C8G一个月80刀左右,再加上公网IP的费用,150刀这下才真正够用。
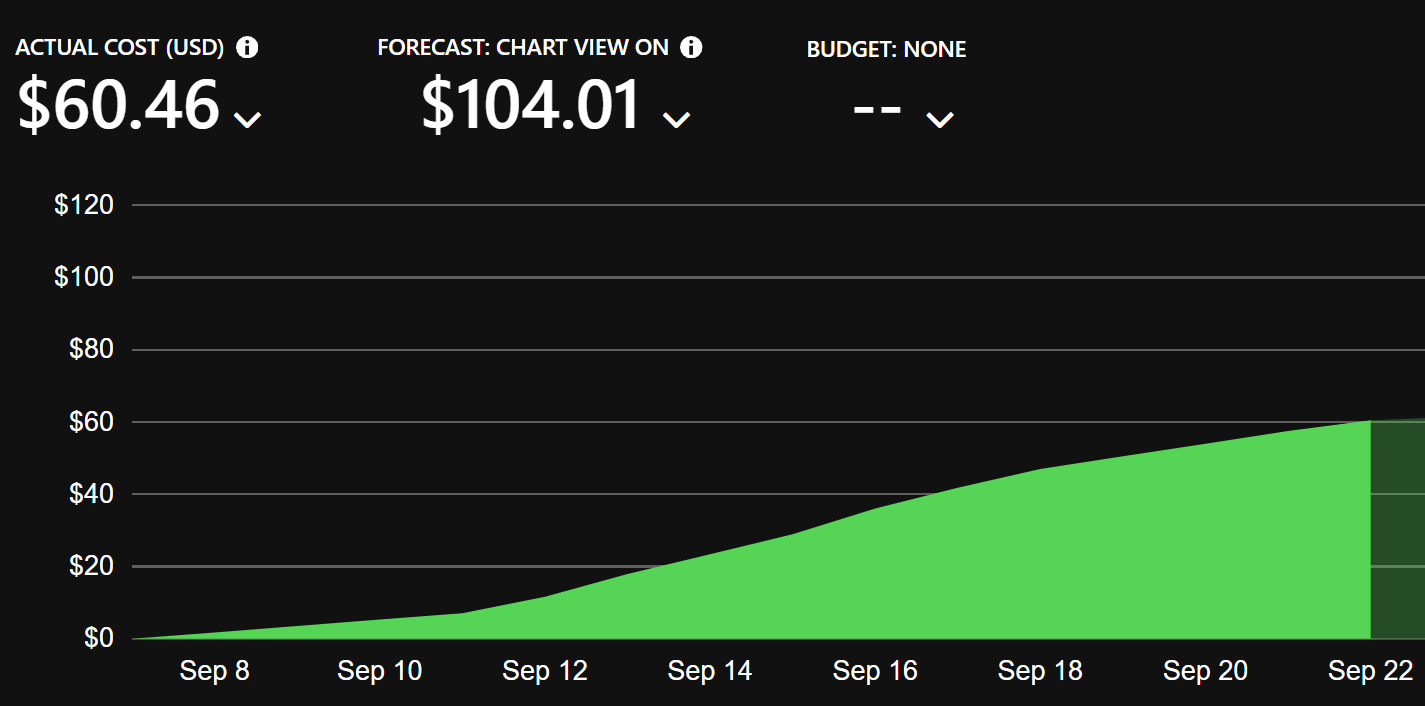
而且用VM还有个好处:没有那么多花里胡哨的AKS专属的功能pod,可用的资源也变多了。现在我把所有服务(例如内网穿透、梯子)全部迁移到这里,也完全够用。
Allocated resources:
  (Total limits may be over 100 percent, i.e., overcommitted.)
  Resource           Requests    Limits
  --------           --------    ------
  cpu                500m (25%)  2 (100%)
  memory             780Mi (9%)  1706Mi (21%)
  ephemeral-storage  0 (0%)      0 (0%)
  hugepages-1Gi      0 (0%)      0 (0%)
  hugepages-2Mi      0 (0%)      0 (0%)
现在博客项目使用Next.js实现的,做起来确实比较简单,但是构建的镜像太大了(300M),推送还挺耗时间的。有了AI后,后续可考虑把博客逻辑改成go写,前端改成vite+react纯前端,最后构建一个十几M的纯go二进制。
在做这个过程中的时候,我又遇到了前两年工作的时候几乎天天接触的Azure的各种概念。这些概念纯学起来非常抽象,真正用起来才直到用处在哪儿。最近工作也接触了一些国产云,感觉国产云在这些管理和开发者友好的功能上还是有一定差距的。
2026-03-14 11:53:00
最近我想看一场时长 5 个多小时的日语演唱会录像,但这份录像没有可用字幕,我又不懂日语,没有字幕MC部分根本听不懂。
于是我想到可以用本地语音转录生成字幕。调研后我发现了 McCloudS/subgen 这个项目,发现它已经把“本地自动转录”这件事做得很完整,并且可以用jellyfin集成实现视频加入和播放时自动生成字幕。
在实际体验中,我进一步希望它能覆盖“转录后翻译”的需求,于是决定在原项目基础上做一层轻量扩展,把翻译功能补齐到同一条工作流中。
因此,我在原仓库上创建了一个fork https://github.com/ddadaal/subgen-translate ,实现了:
uv run launcher.py -f "D:\Movies\movie.mp4" -t transcribe
uv run launcher.py --srt "D:\Movies\movie.subgen.medium.jpn.srt" --srt-to zh
uv管理环境、subgen.env.local来编写本地配置等我的实际环境是一个典型的家庭局域网多机协作场景:
在 Subgen 与 Jellyfin 集成时,有一个关键前提:Subgen 看到的媒体文件路径,必须与 Jellyfin 看到的路径完全一致。为了实现这一点,我
这样,Jellyfin 仍然负责媒体管理与播放触发,GPU 机器负责高耗时的转录与翻译,实现了“存储在 NAS、计算在 GPU 机器”的分工。
flowchart LR
	subgraph LAN[家庭局域网]
		subgraph NASHost[老 Windows 笔记本(NAS)]
			Jellyfin[Jellyfin 服务]
			Disk[外接硬盘盒 / 媒体库]
		end

		subgraph GPUHost[GPU 机器]
			Subgen[Subgen 服务]
			Model[Whisper + TranslateGemma]
		end

		Client[局域网播放器/客户端]
	end

	Disk -->|媒体文件路径| Jellyfin
	Disk -.同盘符映射.-> Subgen
	Client -->|播放/新增媒体| Jellyfin
	Jellyfin -->|Webhook 事件| Subgen
	Subgen -->|转录/翻译| Model
	Model -->|生成字幕(双语/纯译文)| Disk
Jellyfin -->|读取字幕并展示| Client配置情况:
vad功能,其他参数可让AI来调整。# subgen.env.local
SUBGEN_KWARGS={'vad': True}faster-whisper支持多种模型( https://deepwiki.com/SYSTRAN/faster-whisper#supported-model-variants ),但是不同模型的使用体验有较大区别:
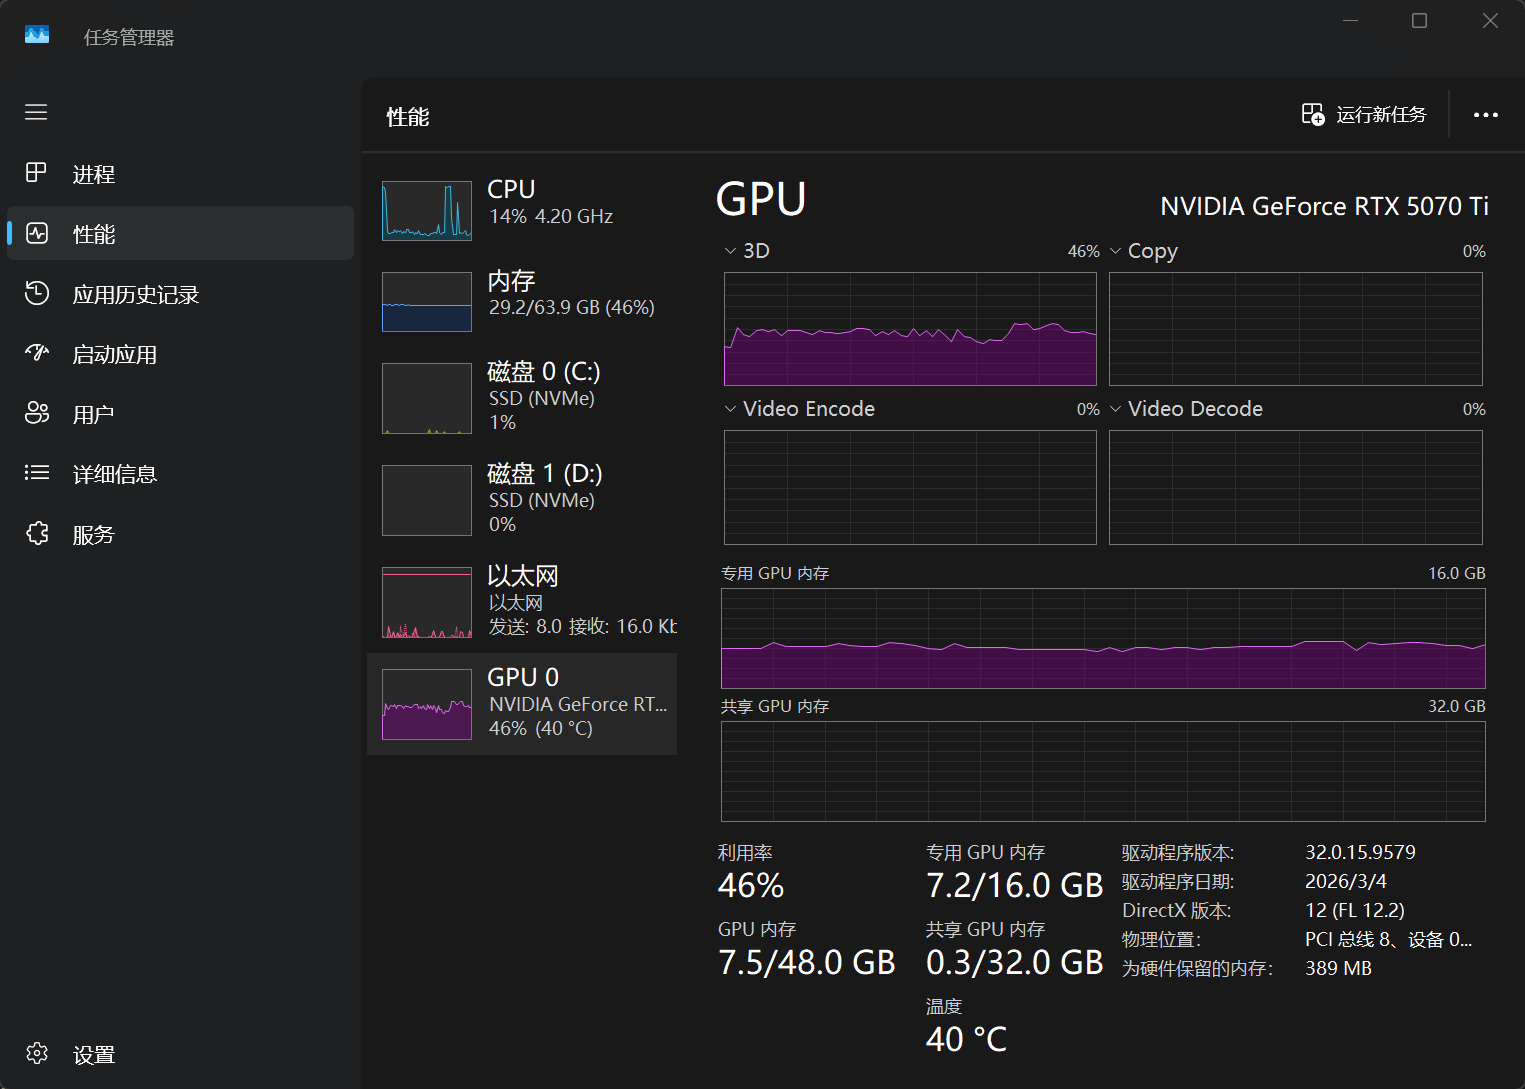
medium:在 i5-1135G7 上用CPU大约可以做到 1s/s(每 1 秒处理 1 秒原视频),台式机RTX 5070 Ti 6s/s (每秒处理约6秒原视频),速度可以接受large-v3:模型大小 3G,在台式机 RTX 5070 Ti 上最快可达 9s/s,和medium差不多,因为瓶颈在CPU上large-v3-turbo:模型体积和 medium 差不多,都是约 1.5G;但在我的环境里只能正常处理视频开头,后面基本识别不出文字,估计也和调参有关,而且既然large-v3也这么快了,直接用large-v3就好distil-large-v3:只支持识别英文faster-whisper只支持CUDA 12,不支持最新的CUDA 13translategemma-4b-it和默认参数在RTX 5070 Ti上推理一次2.3s,速度勉强可以接受。但是考虑到字幕的每一行一般较短,将多个字幕合并后同时推理效率更高,所以提供了批量翻译的功能,每一次推理翻译多行,需要根据README中的描述以及本地硬件的情况调整相关参数2026-03-06 18:50:00
实在不太放心把 nanobot 这类可以直接操作本地电脑的程序直接装在操作系统上,所以我选择把 nanobot 放在容器里运行。但是nanobot很多有意义的工作又需要和宿主机上的环境(例如浏览器)交互,而浏览器上很多网站需要我们先去登录才可以正常使用,这就需要一个既可以由 nanobot操作、也可以由我们自己的操作的浏览器
经过一番查找,终于找一个不影响 nanobot 本身的方法,操作是在部署 nanobot的 docker-compose.yaml 目录下再创建一个 docker-compose.override.yaml,内容如下:
services:
  chromium-vnc-cdp:
    image: linuxserver/chromium:latest
    container_name: chromium-vnc-cdp
    ports:
      - "3000:3000" # Web 界面
    shm_size: "2gb"
    environment:
      - PUID=1000
      - PGID=1000
      - TZ=Asia/Shanghai
      - CHROME_CLI=--remote-debugging-address=127.0.0.1 --remote-debugging-port=9222

  chromium-cdp-proxy:
    image: alpine/socat
    container_name: chromium-cdp-proxy
    restart: unless-stopped
    network_mode: "service:chromium-vnc-cdp"
    command: "TCP-LISTEN:19222,fork,bind=0.0.0.0,reuseaddr TCP:localhost:9222"
启动后,给 nanobot 一条明确指令:
之后都使用
chromium-vnc-cdp:19222这个 CDP 端口操作浏览器。
chromium-vnc-cdp 的职责是提供浏览器本体和 Web 访问界面(3000 端口),这样我们可以直接使用localhost:3000访问这个浏览器。
chromium-cdp-proxy 的职责是把 Chromium 容器里只监听 127.0.0.1:9222 的 CDP 端口,转发成同网络命名空间下可访问的入口。实际上这两个容器在同一个网络中,所以需要换个端口监听,这里选择了19222,其他任何端口都可以。
这里有一个关键限制:根据 pyppeteer 相关讨论中的实践结论,--remote-debugging-address=0.0.0.0 往往需要和 --remote-debugging-port、--headless 一起使用;但一旦使用 --headless,就无法达到“实时查看浏览器界面”的目标。
来源:https://github.com/pyppeteer/pyppeteer/pull/379#issuecomment-2072215518
因此我不走“浏览器直接对外暴露 CDP”的路线,而是保留有界面的 Chromium,再通过独立的 socat proxy 容器做端口转发。
这样拆分有三个好处:
socat 单独做代理,不需要改 Chromium 镜像或启动脚本。chromium-vnc-cdp:19222),配置简单且稳定。这套配置完成后:
3000 端口看到浏览器 Web 界面。2026-02-02 20:34:00
之前写过一篇关于HP战99 Ultra(搭载AMD AI Max+ 395)的使用体验,今天聊聊这台笔记本在AI推理场景下的表现。作为这台机器宣传的主要场景,AI推理的实际使用情况却优点一言难尽。
| 配置 | 详情 |
|---|---|
| CPU | AMD Ryzen AI Max+ 395 16C32T Zen5 |
| 内存 | 64G LPDDR5 8000MT 4通道可划分显存 |
| 显卡 | Radeon 8060S 40CU RDNA3.5 |
| 显存 | 可在BIOS里将几个固定挡位的内存分配给显存 |
在深入分析数据之前,需要理解几个重要概念:
重要区别:AI Max+ 395使用可划分显存架构,需要静态分配部分内存给GPU使用;而统一内存无需显式分配,灵活性更高。
为了方便,以及因为我至今没能在WSL下成功运行rocminfo也就没办法跑vllm等主流推理引擎方案(就离谱),本次测试均在Windows下使用LM Studio运行。
这是个MoE模型,总参数量30B激活3B的规模,主要测试Q4_K_M量化的情况。在这个量化等级下,在模型大小为18.13GB。
以下的给出Prompt为:
编写一个科技公司的官网的HTML
另外值得一提的是,LM Studio中对AMD显卡有两种Runtime:Vulkan和ROCm。我本以为两种Runtime不会有什么很大的区别,但是实际测试下来却axm并非如此。
在16K上下文下:
| 专用显存 | 512M | 32G |
|---|---|---|
| 显存占用 | 20.8G | 21.3G |
| Vulkan速度、总数(token/s) | 17.26 (6970) | 42.89 (6107) |
| Vulkan 首token (s) | 0.8 | 0.8 |
| ROCm速度、总数(token/s) | 15.28 (5262) | 14.42 (6351) |
| ROCm 首token (s) | 0.04 | 0.34 |
Vulkan在32G专用显存下的速度实在是过于逆天,于是我重新跑了数次,结果均非常接近。后面我们还能拿到如此让人匪夷所思的成绩。
16K的上下文只能说勉强够用。既然还有这么多显存可用,不妨试试更多的长度上下文。根据LM Studio估计,不同长度上下文的显存使用估计值:
看起来MoE模型的一大好处就是可以把上下文拉大!于是我选择GLM 4.7 Flash最大支持的长上下文 198K下,虽然LM Studio的估计显存占用也仅有22.3G,但是512M专用显存的无法正常加载:
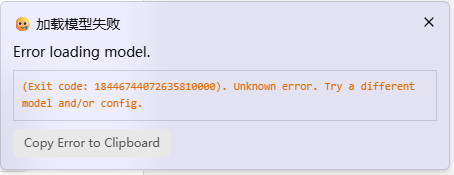
只有在32G下可以正常使用,在Vulkan下获得了**37.28 token/s(7857 token,首token 0.15s)**的成绩。
同时我还测试了Q6_K的量化模型,在16K上下文、32G专用显存下:
再次看到了不知道该说是Vulkan逆天还是ROCm的成绩!ROCm作为AMD官方的方案,居然被Vulkan拉开了如此大的差距。
在不开启思考的情况下,10 token/s的速度还是可以应付日常使用的。
稠密模型的情况就不一样了。这一部分我选择了Qwen 3 VL 32B来测试。
这是个支持图像输入的模型,于是我去stackoverflow上截了如下这一张图,
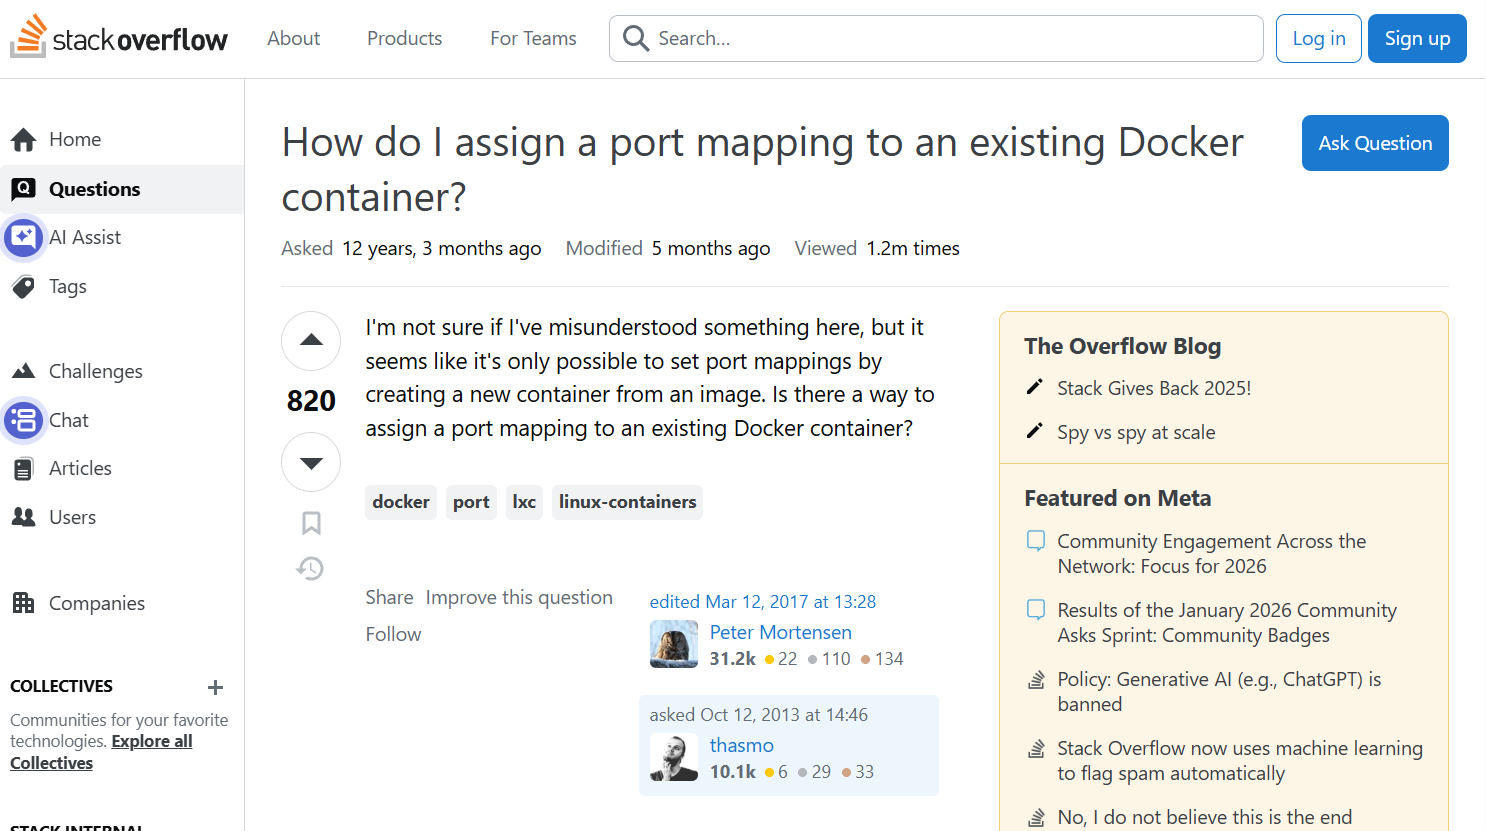
并给出prompt:
使用html和css重现这个HTML页面
以下为结果:
| 专用显存 | 512M 16K | 512M 24K | 32G 16K |
|---|---|---|---|
| 显存占用 | 25.8G | 28.3G | 27.5G |
| Vulkan速度、总数(token/s) | 3.74 (4059) | 3.51 (3676) | 9.41 (6801) |
| Vulkan 首token (s) | 36.67 | 39.29 | 18.32 |
| ROCm速度、总数(token/s) | 4.15 (3723) | 3.10 (3713) | 9.42 (4198) |
| ROCm 首token (s) | 24.59 | 26.56 | 9.46s |
可以看到,在24K上下文已经到32G显存的极限了(28G)。但不管有没有独立显存,这个推理速度用起来已经是比较难受的级别了。
395的另一个宣传点是可以将75%的内存划给显存,在64G的型号上,BIOS中最高可以将48G的内存划给显存。
听起来很美?48G显存甚至可以高量化跑32B模型了!
Qwen 3 VL 32B的Q6_K量化模型大小为28.08G,在32G显存下可以加载,但是推理的时候因为显存不够了,速度比可以完全在显存中的Q4版本慢很多。经过测试,Q5_K_M是最大的32G显存可以充分的量化规格。
而这时候你想到,48G显存岂不是就可以接近这个问题了?
可是事实却是:16G的系统内存不仅使得正常的系统操作会开始缓慢甚至卡顿,甚至模型都无法正常加载!而我已经LM Studio中有三个选项和显存和内存全部调整为不给内存太多压力了:
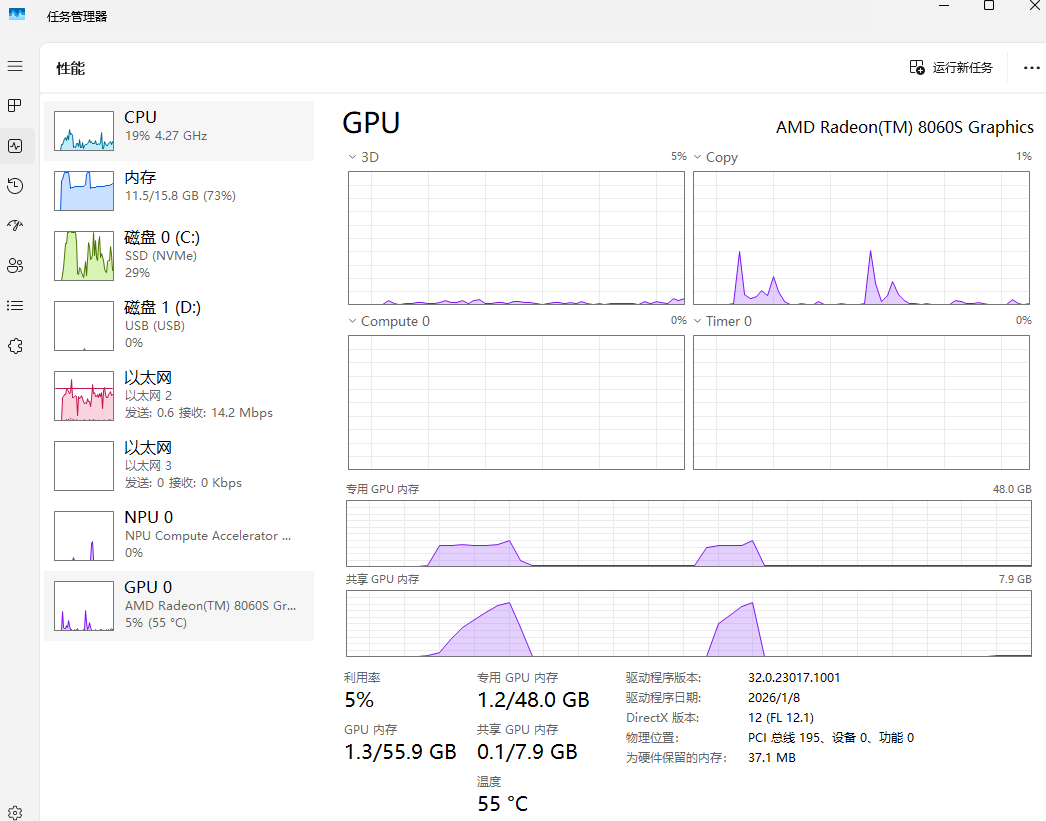
395的主要的宣传口号,就是内存可以当作显存用。这话当然不假,BIOS里确实可以将内存划分给显存,但是,它和我们预期的共享内存完全是两码事:
那,如果我们不划分显存,直接把内存当显存用呢?其实现在的推理框架都支持把内存当显存用,但是以下两个问题让用内存当显存的方案下的推理速度惨不忍睹:
理论上来说,395的内存和显存均为同一款芯片,问题1不存在,但实际上问题2的问题仍然无法避免:即使是在同一块芯片上,显存仍然不能直接用内存部分的部分,内存和显存之间拷贝仍然非常频繁。
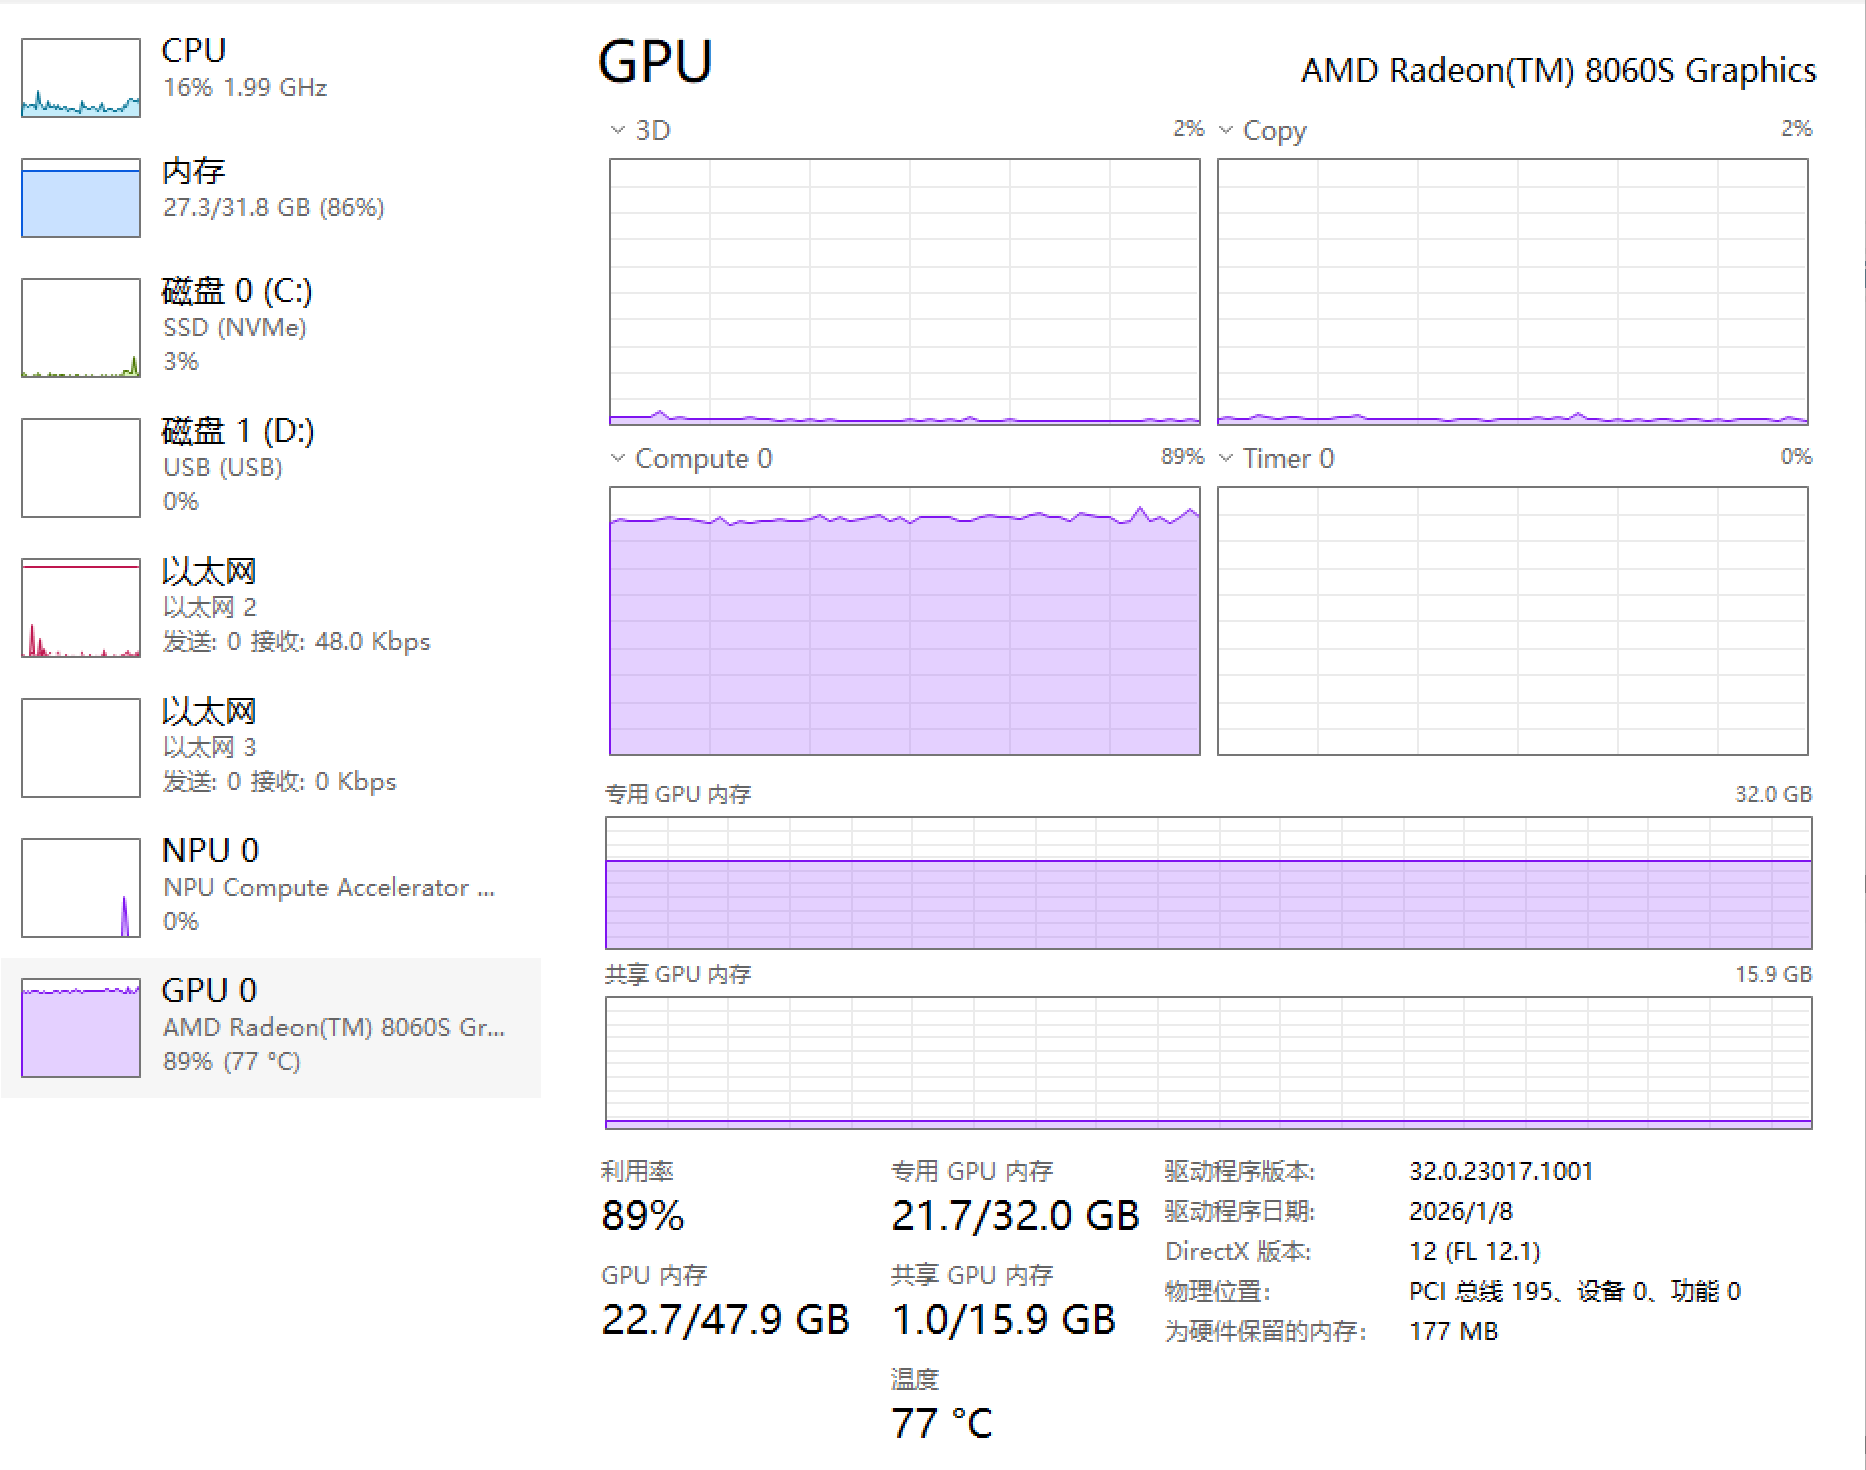
以下为使用512M专用显存(上)和32G专用显存(下)使用Vulkan运行GLM 4.7 Flash Q4_K_M时的任务管理器的图片,可以看出,512M的专用显存下GPU利用率只有70%左右,而32G下可以到达90%以上。而右上角的Copy也可以看出512M专用显存下显存一直在进行复制的操作。
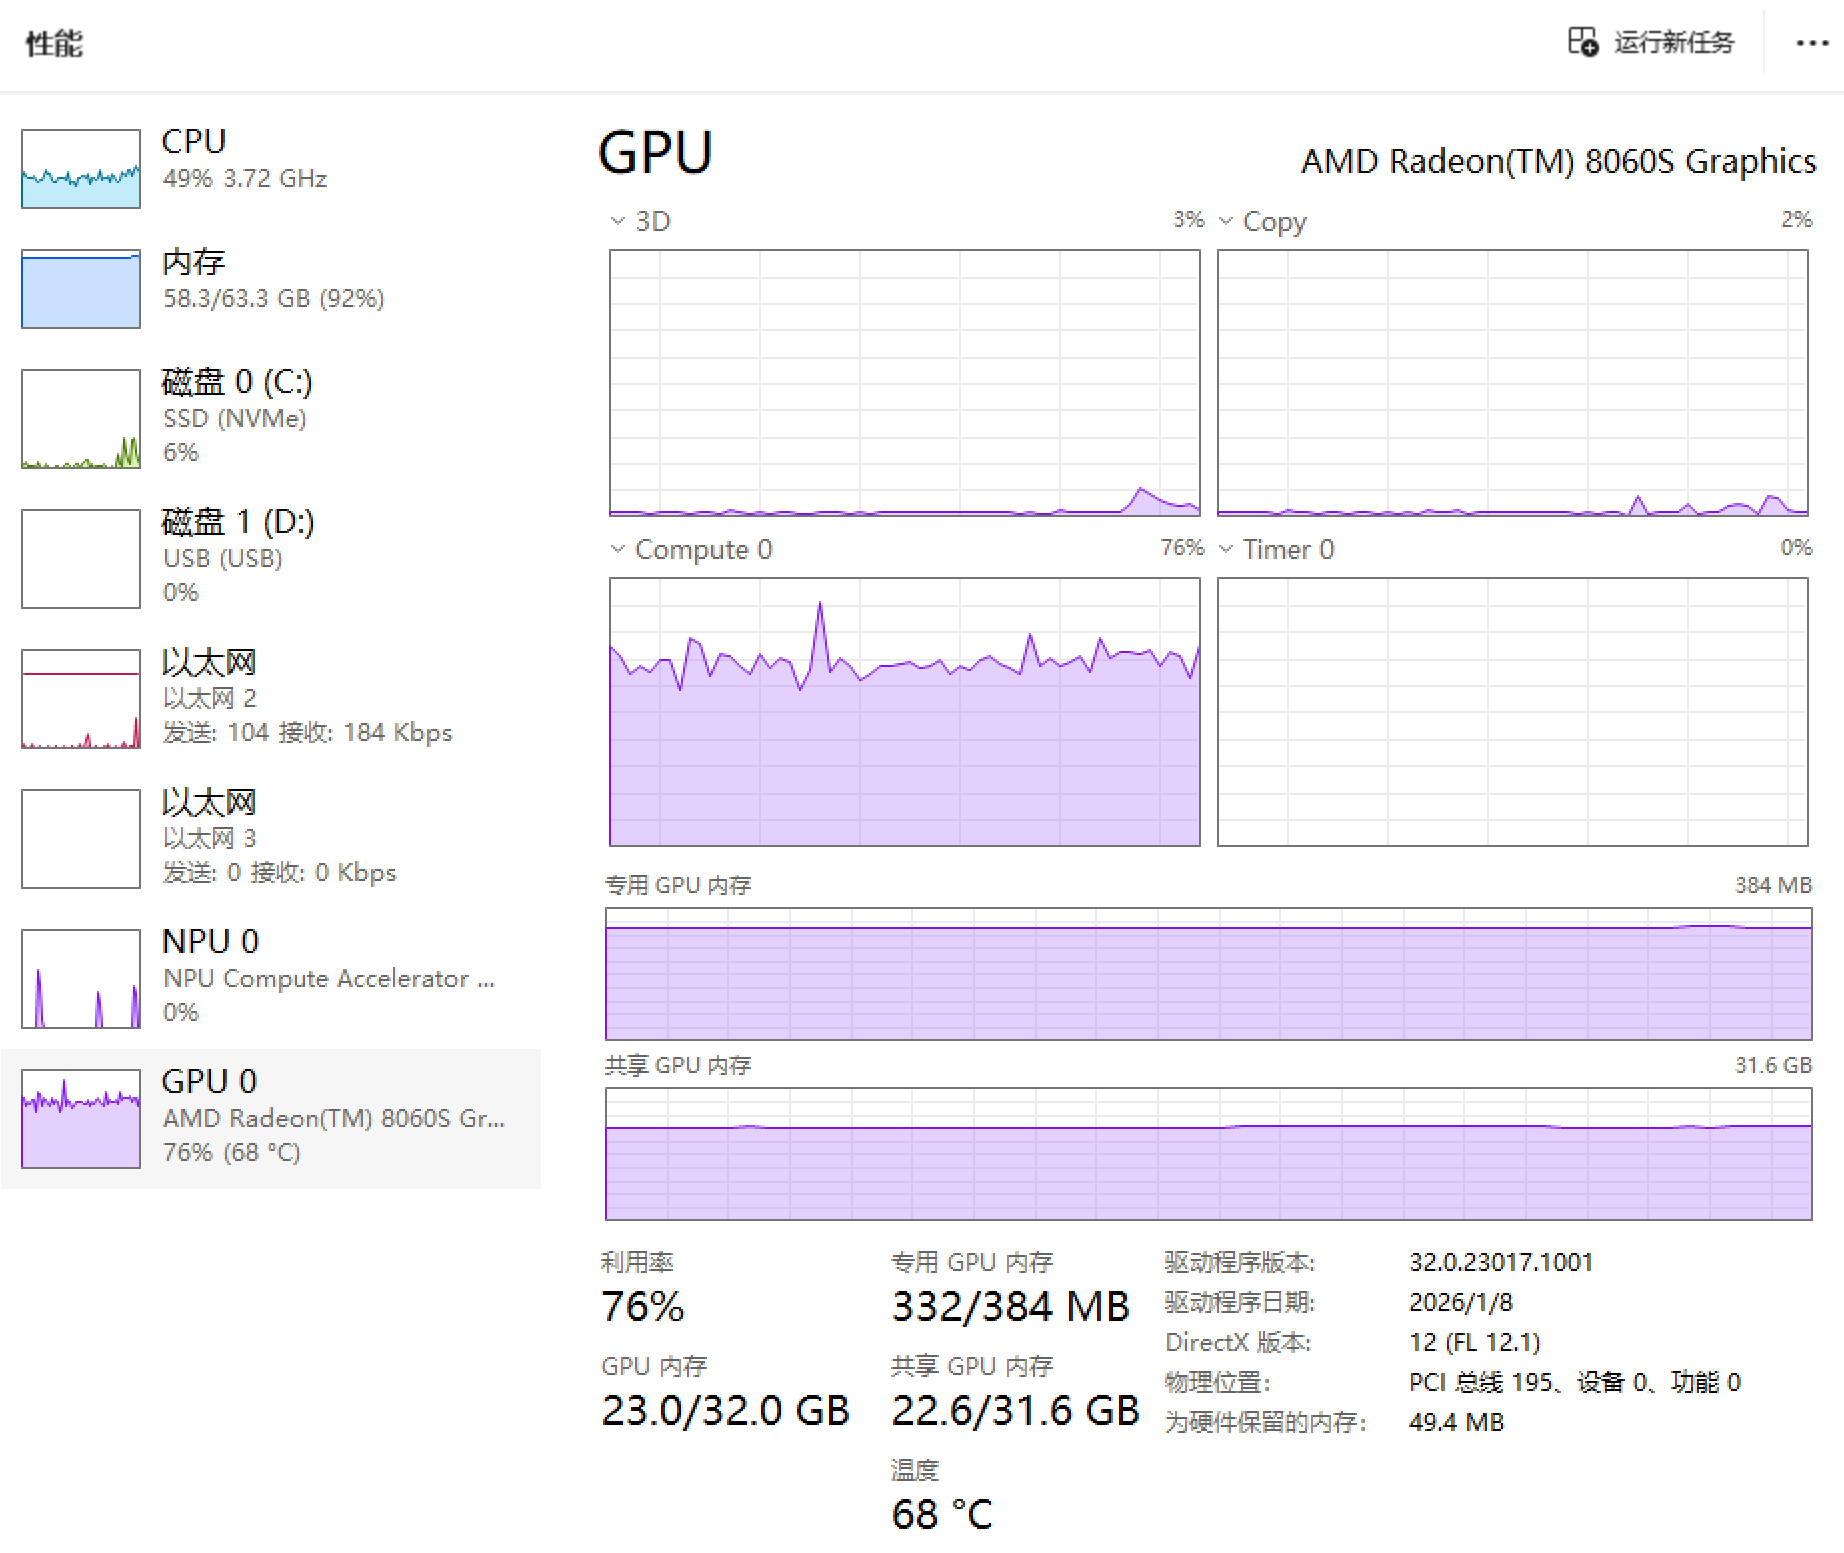
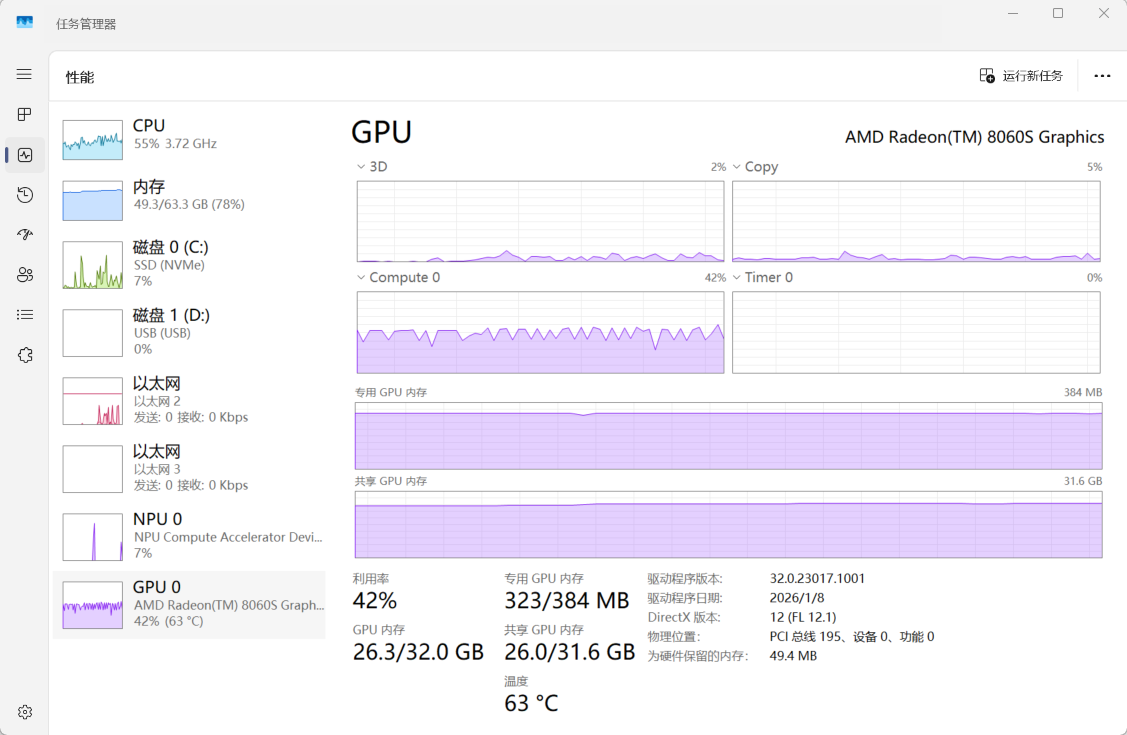
同一现象也出现在512M专用显存下运行Qwen 3 VL 32B Q4_K_M的情况,GPU利用率更是只有50%,而Copy图中也能一直看到复制的过程,而整个过程中CPU也在(艰难地)参与运算。而CPU参与计算在笔记本场景下有抢功耗的问题,更影响了GPU的性能发挥。
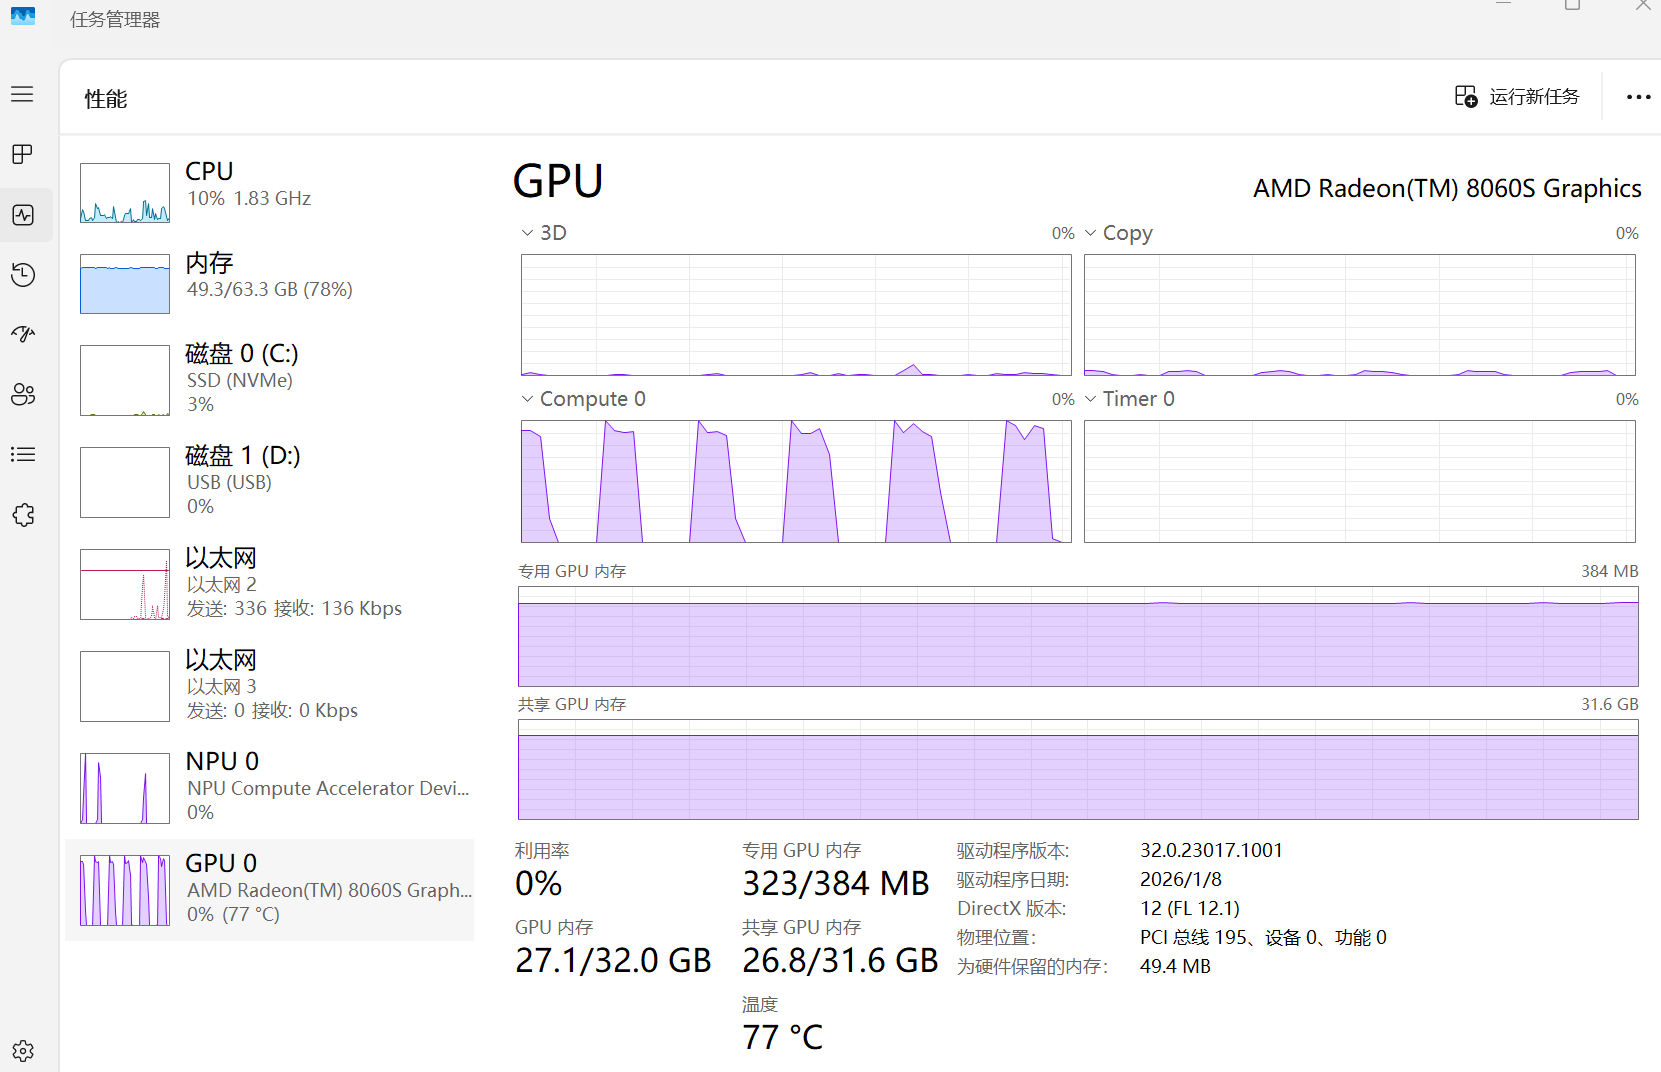
更进一步地,如果把上下文拉到24K,进一步加大显存的需求量,在512M专用显存下情况更加恶化了:GPU有接近一半的时间都闲着。要知道,这个时候显存需求甚至才26G!
我用两个字总结395的优点:能用
可是这台笔记本形态、64G的总内存的设备却有点尴尬:
所以395确实非常适合小主机场景:
pytorch)甚至小主机的价格也比笔记本形态的设备(64G 19999)便宜太多(128G普遍15000,希望还没开始涨)。在这个内存价格疯涨的年代,能以这个价格有一台可以跑大模型的机器已经很不容易了。


